


Korte samenvatting: Python maakt geavanceerde NLP-analyse voor semantische SEO mogelijk met bibliotheken als spaCy, NLTK en Hugging Face Transformers. Deze tools extraheren entiteiten, analyseren zoekintentie, clusteren trefwoorden semantisch en optimaliseren inhoud voor actuele relevantie die verder gaat dan traditionele trefwoordmatching. Het automatiseren van deze taken met Python-scripts helpt sites actuele autoriteit te bereiken en beter te scoren in moderne zoekalgoritmen.
Zoekmachines zijn al jaren geleden verder geëvolueerd dan het eenvoudig matchen van trefwoorden. Ze analyseren nu de betekenis, begrijpen de context en evalueren de actuele diepte. Traditionele SEO-tactieken werken niet meer.
Python heeft alles veranderd voor inhoudoptimalisatie. Bibliotheken voor natuurlijke taalverwerking decoderen hoe zoekalgoritmen de semantiek van inhoud interpreteren. En de toegangsdrempel? Lager dan de meeste mensen denken.
Voor het intelligent verwerken van ruwe tekst is meer nodig dan het matchen van patronen. Woorden die er anders uitzien, betekenen vaak hetzelfde. Dezelfde woorden in verschillende volgordes geven compleet verschillende betekenissen. Volgens de documentatie van spaCy vereist het effectief oplossen van deze problemen het toevoegen van linguïstische kennis aan de analyse van ruwe tekst.
In deze gids wordt precies uitgelegd hoe Python NLP-bibliotheken semantische SEO-workflows transformeren. Geen onzin, geen verzonnen statistieken. Alleen praktische implementatiestrategieën ondersteund door echte bibliotheekdocumentatie.
NLP en semantische SEO-fundamenten begrijpen
Natuurlijke taalverwerking leert machines menselijke taal te begrijpen. Semantic SEO past dat begrip toe om inhoud te maken die overeenkomt met zoekintentie en actuele verwachtingen.
Het zit zo: zoekmachines vergelijken niet alleen meer met trefwoorden. Ze analyseren entiteiten, relaties en context. Een pagina over “Python programmeren” moet natuurlijk gerelateerde concepten bespreken zoals variabelen, functies en bibliotheken. Het ontbreken van deze semantische verbanden duidt op een onvolledige dekking.
Hoe zoekmachines taal semantisch verwerken
Moderne zoekalgoritmen gebruiken transformatormodellen om de betekenis van een zoekopdracht te begrijpen. BERT, ontwikkeld door Google AI Language in 2018, dient als basis voor het oplossen van meer dan 11 van de meest voorkomende NLP-taken, waaronder sentimentanalyse en named entity recognition.
De bidirectionele methodologie is belangrijk. BERT analyseert context vanuit beide richtingen rond elk woord, vergelijkbaar met hoe mensen lege plekken in zinnen invullen door omringende tekst te lezen. Volgens de Hugging Face documentatie biedt DistilBERT een lichtere versie die 60% sneller draait met behoud van 95% van de prestaties van BERT.
Zoekmachines passen deze modellen toe op zowel zoekopdrachten als inhoud. Ze extraheren entiteiten, begrijpen relaties en evalueren of inhoud een onderwerp volledig dekt.
Waarom traditioneel trefwoordonderzoek tekortschiet
Trefwoorddichtheid optimaliseren was zinvol toen algoritmen woordfrequentie telden. Nu niet meer.
Echte taal: doelzoekwoorden in de inhoud stoppen schaadt nu actief de rankings. Zoekalgoritmen detecteren onnatuurlijke taalpatronen. Ze geven voorrang aan inhoud die op een natuurlijke manier semantische velden bestrijkt.
Een semantische benadering identificeert conceptclusters. Voor een onderwerp als “machinaal leren” omvatten verwante termen neurale netwerken, trainingsgegevens, algoritmen en modelvalidatie. Python NLP tools extraheren deze relaties automatisch.
Gebruik NLP voor betere SEO
Python gebruiken voor NLP en semantische SEO is slechts één onderdeel van een bredere strategie, en LENGREO helpt deze technieken te integreren in complete SEO-frameworks die resultaten opleveren. Het succes hangt af van hoe goed de inhoud overeenkomt met de zoekintentie.
- trefwoordclustering en intentiemapping
- semantische inhoud optimaliseren
- schaalbare SEO-raamwerken
Als je gegevens wilt omzetten in rankings, contact opnemen met LENGREO om te beginnen.
Essentiële Python-bibliotheken voor NLP en semantische SEO
Drie bibliotheekecosystemen domineren Python NLP: NLTK voor basistaken, spaCy voor productiepijplijnen en Hugging Face Transformers voor geavanceerde modellen.
Ze dienen allemaal verschillende gebruikssituaties. Het kiezen van de juiste tool hangt af van de specifieke analysebehoeften.
NLTK: De Stichting
De Natural Language Toolkit biedt uitgebreide toegang tot linguïstische algoritmen. Het is ontworpen voor het leren van NLP concepten en prototyping oplossingen.
Installatie vereist één enkel commando:
pip installeert nltk
NLTK blinkt uit in tekst voorbewerking, tokenization en linguïstische basisanalyse. De leercurve is laag, waardoor het toegankelijk is voor nieuwkomers in NLP. De verwerkingssnelheid blijft echter achter bij moderne alternatieven.
De beste toepassingen voor SEO zijn onder andere het opschonen van tekst, het verwijderen van stopwoorden en basis frequentieanalyses. De uitgebreide documentatie en educatieve bronnen maken NLTK ideaal voor het begrijpen van NLP grondbeginselen voordat wordt overgestapt op productietools.
spaCy: Productieklare verwerking
Volgens de officiële documentatie van spaCy is spaCy een gratis, open-source bibliotheek voor geavanceerde verwerking van natuurlijke taal in Python. Het is gebouwd voor echte toepassingen waarbij prestaties van belang zijn.
De installatie verloopt in twee stappen:
pip installeert spacy
python -m spacy download en_core_web_sm
De architectuur geeft prioriteit aan snelheid. Zoals veel NLP-bibliotheken codeert spaCy alle strings naar hashwaarden, waardoor het geheugengebruik wordt verminderd en de efficiëntie wordt verbeterd. Voeg een underscore toe aan de attribuutnaam om leesbare stringweergaven van attributen te krijgen.
Het verwerken van een document creëert een Doc-object dat tokens, entiteiten en syntactische relaties bevat:
importeren spacy
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Microsoft kocht Activision op 18 januari voor $68,7 miljard’.’
doc = nlp(tekst)
voor ent in doc.ents:
print(ent.text, ent.label_)
Dit script identificeert “Microsoft” en “Activision” als organisaties, “$68,7 miljard” als geld en “18 januari” als datum. Marketeers die spaCy in Python gebruiken, melden 25-35% snellere cycli voor het optimaliseren van inhoud door het automatisch genereren van synoniemen en semantische veldanalyse.
Knuffelgezicht Transformers: Geavanceerde modellen
De Transformers bibliotheek biedt toegang tot voorgetrainde modellen zoals BERT, GPT en gespecialiseerde varianten. Deze modellen begrijpen context op een niveau dat traditionele algoritmen niet kunnen evenaren.
Installatie:
pip installeert transformatoren
Transformer-modellen blinken uit in het begrijpen van zoekintentie, het genereren van semantisch vergelijkbare zinnen en het analyseren van de diepte van de inhoud. De computationele vereisten zijn hoger dan die van spaCy, maar de kwaliteit van het semantisch begrip rechtvaardigt de kosten voor kritische analyses.
Voor semantische zoektoepassingen leggen transformatorgebaseerde inbeddingen de betekenis beter vast dan traditionele woordvectoren. Dit maakt een betere analyse van inhoudsleemtes en het matchen van intenties mogelijk.
| Bibliotheek | Installatie | Beste voor | Leercurve | SEO-toepassingen |
|---|---|---|---|---|
| NLTK | pip installeert nltk | Fundamenteel leren | Beginnersvriendelijk | Tekst voorbewerken, frequentieanalyse |
| spaCy | pip installeert spacy | Productiepijplijnen | Matig | Entiteitsextractie, afhankelijkheidsparsing |
| Transformers | pip installeert transformatoren | Geavanceerde semantiek | Geavanceerd | Intentieanalyse, semantische gelijkenis |
Named Entity Recognition voor inhoudoptimalisatie
Named Entity Recognition (NER) identificeert en classificeert entiteiten die in tekst worden genoemd. Zoekmachines gebruiken vergelijkbare technieken om te begrijpen waar inhoud over gaat.
Entiteiten omvatten mensen, organisaties, locaties, datums, producten en meer. Uitgebreide dekking van entiteiten geeft aan dat het om een actueel onderwerp gaat.
Entiteiten extraheren met spaCy
SpaCy's voorgetrainde modellen identificeren entiteiten out of the box. Het proces neemt slechts een paar regels code in beslag:
importeren spacy
uit spacy importeer displacy
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Apple kondigde de iPhone 15 aan in Cupertino op 12 september 2023’.’
doc = nlp(tekst)
voor ent in doc.ents:
print(f'{ent.text}: {ent.label_}’)
Dit identificeert Apple als organisatie, iPhone 15 als product, Cupertino als locatie en de datum. Het analyseren van de inhoud van concurrenten laat zien welke entiteiten zij bestrijken en welke hiaten er zijn.
Dekkingskaarten van bouwentiteiten
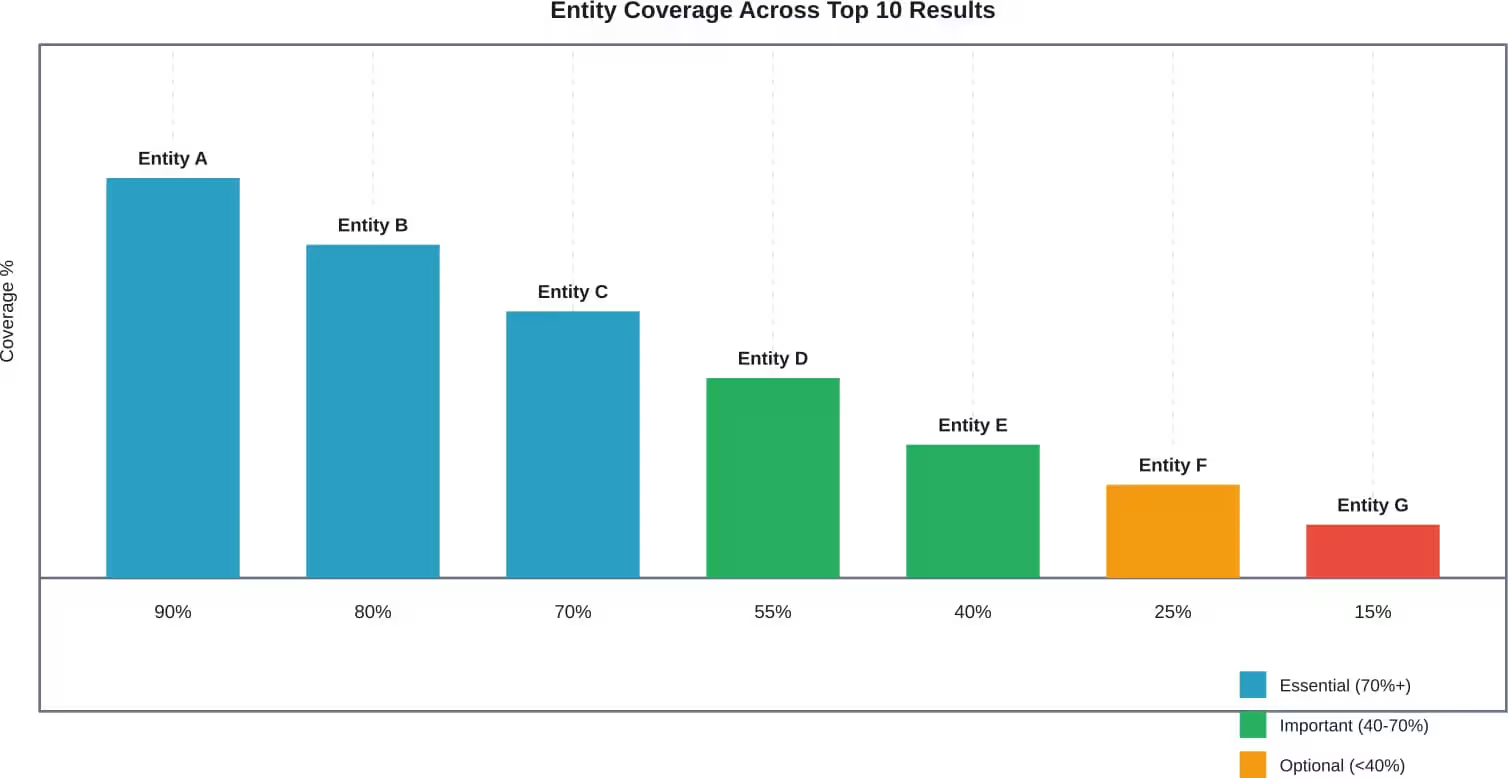
Topische autoriteit vereist dat relevante entiteiten op natuurlijke wijze worden genoemd. Python-scripts kunnen top-ranking pagina's analyseren en patronen in entiteitsfrequentie extraheren.
De aanpak werkt als volgt: scrap top 10 resultaten voor een doelquery, extraheer entiteiten uit elk resultaat, tel de frequentie van entiteiten over de resultaten en identificeer entiteiten die aanwezig zijn in 70%+ van de topresultaten.
Entiteiten die voorkomen in de meeste topresultaten vertegenwoordigen de verwachte actuele dekking. Inhoud waarin deze entiteiten ontbreken, lijkt waarschijnlijk onvolledig voor zoekalgoritmen. Door ze op natuurlijke wijze toe te voegen, zonder vermelding te forceren, wordt de semantische relevantie versterkt.
Semantische trefwoordclustering met Python
Trefwoordclustering groepeert gerelateerde zoektermen op basis van semantische gelijkenis in plaats van alleen woordoverlap. Dit onthult hoe zoekers denken over onderwerpen en hoe inhoud moet worden gestructureerd.
Traditionele clustering keek naar gedeelde woorden. Semantische clustering analyseert de betekenis. “Beste smartphones” en “top mobiele telefoons” bevatten geen gedeelde woorden maar drukken dezelfde betekenis uit.
TF-IDF gebaseerd clusteren
Term Frequency-Inverse Document Frequency meet het belang van woorden in documenten. Woorden die vaak voorkomen in één document, maar zelden in andere, scoren hoog.
De techniek werkt voor de eerste trefwoordgroepering:
uit sklearn.feature_extraction.text importeer TfidfVectorizer
uit sklearn.cluster importeer KMeans
trefwoorden = [‘python handleiding’, ‘leer python’, ‘python gids’,
‘[basiskennis machinaal leren], [introductie ML], [beginnen met ML].
vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(trefwoorden)
kmeans = KMeans(n_clusters=2)
kmeans.fit(X)
print(kmeans.labels_)
Dit groepeert trefwoorden in clusters. De eerste drie trefwoorden clusteren samen (Python learning), terwijl de laatste drie afzonderlijk worden gegroepeerd (machine learning introduction).
Geavanceerde semantische clustering met inbeddingen
Inbeddingen op basis van transformatoren leggen semantische gelijkenis nauwkeuriger vast. Ze begrijpen dat “auto” en “auto” hetzelfde betekenen ondanks verschillende tekens.
De bibliotheek Sentence Transformers vereenvoudigt dit:
uit sentence_transformers importeer SentenceTransformer
uit sklearn.cluster importeer AgglomerativeClustering
model = SentenceTransformer(‘all-MiniLM-L6-v2’)
trefwoorden = [‘beste laptops 2026’, ‘top notebooks dit jaar’,
‘koopgids voor laptops’, ‘hoe kies ik een computer’].
embeddings = model.encode(trefwoorden)
clustering = AgglomerativeClustering(n_clusters=2)
labels = clustering.fit_predict(embeddings)
Deze methode groepeert semantisch vergelijkbare zoekopdrachten, zelfs als ze volledig verschillende bewoordingen gebruiken. Query's over productvergelijkingen worden apart gegroepeerd van how-to gidsen.
Content hubs bouwen vanuit clusters
Zodra zoekwoorden semantisch geclusterd zijn, structureer je de inhoud dienovereenkomstig. Elk cluster wordt een contenthub met een pijlerpagina en ondersteunende artikelen.
Clusters onthullen zoekintentiepatronen. Informatieve zoekopdrachten groeperen zich. Commerciële termen vormen afzonderlijke clusters. Dit geeft informatie over de selectie van inhoudstypes en de architectuur van interne koppelingen.
Zoekintentie analyseren met NLP
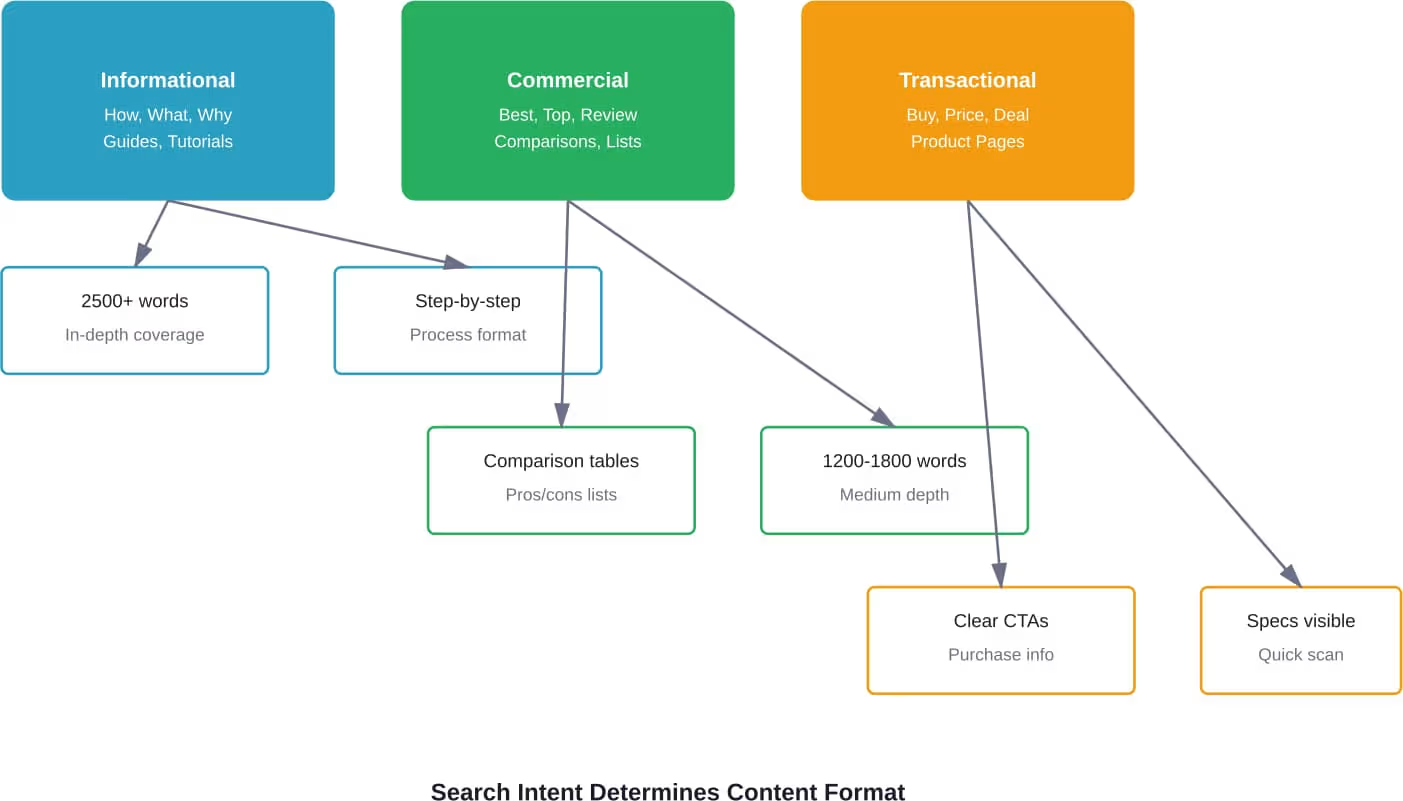
Zoekintentie bepaalt welk type inhoud voldoet aan een zoekopdracht. Python NLP tools classificeren intentie automatisch door het analyseren van zoekpatronen en top-ranking inhoud.
Er bestaan vier hoofdtypen intenties: informatie (leren), navigatie (specifieke sites vinden), commercieel (producten onderzoeken) en transactioneel (klaar om te kopen).
Intentieclassificatie via vraaganalyse
De structuur van een vraag onthult de bedoeling. Vragen die beginnen met “hoe”, “wat” of “waarom” duiden op een informatieve intentie. Zinnen met “beste”, “top” of “recensie” duiden op commercieel onderzoek.
Een eenvoudige classificator gebruikt patroonherkenning:
import re
def classificeer_intentie(query):
query_lower = query.lower()
informational_patterns = [r’^how’, r’^what’, r’^why’, r’^when’, r'guide’, r'tutorial’].
commercial_patterns = [r'best’, r'top’, r'review’, r'compare’, r'vs’]
transactionele_patronen = [r'kopen’, r'kopen’, r'prijs’, r'goedkoop’, r'deal’]
voor patroon in transactionele_patronen:
Als re.search(pattern, query_lower):
geef ‘Transactioneel’ terug’
voor patroon in commerciële_patronen:
Als re.search(pattern, query_lower):
Geef ‘Commercieel’ terug’
voor patroon in informatieve_patronen:
Als re.search(pattern, query_lower):
geef ‘Informatief’ terug’
geef ‘Navigational’ terug’
print(classificeer_intentie(‘hoe leer ik python’)) # Informatief
print(classificeer_intentie(‘beste python cursussen’)) # Commercieel
SERP-inhoudsanalyse voor intentievalidatie
Top-ranglijst inhoudstypen valideren intentieclassificatie. Als alle topresultaten lijstartikelen zijn, verwacht de query vergelijkende inhoud. Als tutorials domineren, presteert instructieve inhoud het best.
Geautomatiseerde SERP-analyse haalt patronen eruit:
- Vraagtekens in titels tellen (inhoud in FAQ-stijl)
- Lijstindicatoren identificeren (genummerde stappen, opsommingstekens)
- Productvermeldingen en -prijzen detecteren (commerciële inhoud)
- De gemiddelde lengte van de inhoud meten (diepteverwachtingen)
Het afstemmen van het inhoudsformaat op dominante SERP-patronen verbetert het rankingpotentieel. Een gedetailleerde handleiding zal niet worden weergegeven bij een zoekopdracht waarbij zoekers snelle productvergelijkingen verwachten.
Analyse van hiaten in de inhoud met Python
Hiaten in de inhoud zijn onderwerpen die concurrenten behandelen en die jouw site mist. Door deze hiaten te identificeren en op te vullen, bouw je topische autoriteit op en vang je extra zoekverkeer.
Handmatige analyse van gaten duurt uren. Python automatiseert het proces in enkele minuten.
Inhoudstructuren van concurrenten scrapen
Het analyseren van concurrerende koppen onthult hun actuele dekking. Beautiful Soup haalt efficiënt rubriekstructuren eruit:
van bs4 importeer BeautifulSoup
importverzoeken
url = ‘https://competitor.com/target-article’
antwoord = requests.get(url)
soep = BeautifulSoup(response.content, ‘html.parser’)
rubrieken = []
voor heading in soup.find_all([‘h2’, ‘h3’]):
koppen.append(heading.get_text().strip())
voor h in rubrieken:
print(h)
Voer dit uit op meerdere pagina's die bovenaan staan. Extraheer alle H2- en H3-koppen. Vergelijk hun onderwerpen met je bestaande inhoud.
Ontbrekende actuele dekking vinden
Zodra de koppen van concurrenten zijn verzameld, identificeert u algemene onderwerpen die ontbreken in uw inhoud. Onderwerpen die voorkomen in 60%+ van de topresultaten maar ontbreken op uw pagina's vormen duidelijke hiaten.
Een script voor frequentieanalyse telt het voorkomen van rubrieken:
van verzamelingen importeer Teller
import re
alle_concurrent_headings = [
# Rubrieken van concurrent 1
[‘Introductie’, ‘Installatiegids’, ‘Geavanceerde technieken’, ‘Veelvoorkomende fouten’],
# Rubrieken van concurrent 2
[‘Aan de slag’, ‘Installatiegids’, ‘Problemen oplossen’, ‘Beste praktijken’],
# Rubrieken van concurrent 3
[‘Overzicht’, ‘Installatie’, ‘Geavanceerde technieken’, ‘Veelvoorkomende fouten’].
]
flat_headings = [h for sublist in all_competitor_headings for h in sublist]
kop_aantallen = Teller(platte_koppen)
voor heading, count in heading_counts.most_common():
percentage = (count / len(all_competitor_headings)) * 100
print(f'{kop}: {telling} voorkomens ({percentage:.0f}%)’)
Koppen die vaak voorkomen bij concurrenten, maar ontbreken in jouw content, moeten worden toegevoegd. Dit betekent niet dat je hun structuur moet kopiëren, maar dat je moet zorgen voor een uitgebreide dekking van verwachte subonderwerpen.
Leesbaarheid en structuur van inhoud optimaliseren
Leesbaarheid beïnvloedt zowel de betrokkenheid van gebruikers als zoekresultaten. Python tools meten de leesbaarheid objectief en identificeren verbetermogelijkheden.
Zoekmachines houden rekening met verblijftijd en engagementsignalen. Moeilijk te lezen inhoud jaagt bezoekers snel weg, wat negatieve ranking signalen geeft.
Leesbaarheidsscores berekenen
De bibliotheek textstat berekent standaard leesbaarheidsmetingen:
import tekststat
text = ”’Je inhoud komt hier. Dit kan een volledig artikel zijn
of alleen een gedeelte dat je wilt analyseren op leesbaarheid.”
flesch_reading_ease = textstat.flesch_reading_ease(text)
flesch_kincaid_grade = textstat.flesch_kincaid_grade(text)
print(f'Flesch leesgemak: {flesch_reading_ease}’)
print(f'Rangniveau: {flesch_kincaid_grade}’)
Flesch Reading Ease scores boven de 60 duiden op toegankelijke inhoud. Scores onder de 30 duiden op moeilijk leesbaar materiaal dat publiek kan verliezen. Flesch-Kincaid Grade Level geeft aan welke klas van de Amerikaanse school nodig is om de tekst te begrijpen.
Richt je voor de meeste webinhoud op niveau 8-10. Technische onderwerpen kunnen een hoger niveau rechtvaardigen, maar zelfs complexe onderwerpen hebben baat bij helder schrijven.
Analyse van zinslengte en complexiteit
Een gemiddelde zinslengte beïnvloedt de leesbaarheid. Erg lange zinnen vermoeien lezers. Te veel korte zinnen voelen hakkerig aan.
spaCy analyseert de zinsstructuur:
importeren spacy
nlp = spacy.load(‘en_core_web_sm’)
tekst = ”’Je artikeltekst hier.”’
doc = nlp(tekst)
zin_lengtes = [len(sent) for sent in doc.sents]
gemiddelde_lengte = som(zin_lengten) / len(zin_lengten)
print(f'Gemiddelde zinslengte: {gemiddelde_lengte:.1f} woorden’)
print(f'Langste zin: {max(zin_lengtes)} woorden’)
print(f'Kortste zin: {min(zin_lengte)} woorden’)
Streef naar een gemiddelde zinslengte tussen 15-20 woorden. Meng kortere, krachtige zinnen met langere, gedetailleerde zinnen. Zinnen van meer dan 35-40 woorden verwarren lezers vaak en moeten worden opgesplitst.
Geautomatiseerde SEO-inhoud analysetools bouwen
Het combineren van NLP-technieken in uniforme analysetools automatiseert repetitieve optimalisatietaken. Een enkel script kan entiteiten extraheren, intentie classificeren, leesbaarheid meten en hiaten identificeren.
Een Content Audit Script maken
Een uitgebreid auditscript analyseert bestaande inhoud op schaal:
importeren spacy
import tekststat
van verzamelingen importeer Teller
nlp = spacy.load(‘en_core_web_sm’)
def_content analyseren(tekst):
doc = nlp(tekst)
# Entiteitsextractie
entiteiten = [(ent.text, ent.label_) for ent in doc.ents]
entiteit_tellingen = Teller([label voor _, label in entiteiten])
# Leesbaarheid
leesbaarheid = textstat.flesch_reading_ease(text)
graad_niveau = textstat.flesch_kincaid_grade(text)
# Structuur
aantal zinnen = len(lijst(doc.zinnen))
word_count = len([token for token in doc if not token.is_punct])
terugkeren {
‘word_count’: word_count,
‘zin_aantal’: zin_aantal,
‘readability_score’: leesbaarheid,
‘Rangniveau: Rangniveau,
‘entity_counts’: dict(entity_counts),
‘unieke_entiteiten’: len(set([tekst voor tekst, _ in entiteiten]))
}
# Gebruik op inhoud
resultaten = analyseer_content(uw_artikel_tekst)
afdrukken(resultaten)
Dit levert bruikbare statistieken op: aantal woorden, aantal zinnen, leesbaarheidsscores, diversiteit van entiteiten en verdeling van entiteitstypes. Voer het uit over alle inhoud van de site om slecht presterende pagina's te identificeren.
Dashboard voor vergelijking met concurrenten
Het analyseren van de inhoud van concurrenten naast uw eigen inhoud onthult relatieve sterke en zwakke punten. Een vergelijkingsscript verwerkt meerdere URL's:
importverzoeken
van bs4 importeer BeautifulSoup
def scrape_and_analyze(url):
antwoord = requests.get(url)
soep = BeautifulSoup(response.content, ‘html.parser’)
# Hoofdinhoud extraheren (selector voor doelsites aanpassen)
inhoud = soep.vind(‘artikel’).get_text()
return analyseer inhoud(content)
concurrent_urls = [
‘https://competitor1.com/article’,
‘https://competitor2.com/article’
]
for url in competitor_urls:
print(f’\Analyzing: {url}’)
resultaten = scrape_and_analyze(url)
print(f”Woorden: {results[‘word_count’]}”)
print(f”Leesbaarheid: {results[‘readability_score’]:.1f}”)
print(f”Entiteiten: {results[‘unique_entities’]}”)
Vergelijk je statistieken met de gemiddelden van concurrenten. Als concurrenten gemiddeld 2.500 woorden schrijven en die van jou bevat er 1.200, dan kan het uitbreiden van de diepte van de inhoud de ranking verbeteren. Als zij 25 unieke entiteiten vermelden en de jouwe 12, dan kan het helpen om de thematische breedte te vergroten.
| Metrisch | Uw inhoud | Gemiddelde concurrent | Noodzakelijke actie |
|---|---|---|---|
| Aantal woorden | 1,850 | 2,600 | Dekking uitbreiden |
| Leesbaarheidsscore | 58 | 65 | Taal vereenvoudigen |
| Unieke entiteiten | 14 | 22 | Relevante entiteiten toevoegen |
| Gemiddelde zittingsduur | 24 woorden | 18 woorden | Zinnen inkorten |
| Titels (H2+H3) | 8 | 13 | Structuur verbeteren |
Transformers gebruiken voor semantisch zoeken
Transformatormodellen hebben een revolutie teweeggebracht in semantisch begrip. Ze voeden moderne zoekmachines en maken geavanceerde contentoptimalisatietechnieken mogelijk.
Volgens onderzoek naar semantisch zoeken presteren op transformatoren gebaseerde benaderingen aanzienlijk beter dan traditionele lexicale methoden voor het ophalen van informatie.
Semantische inbeddingen genereren
Embeddings zetten tekst om in numerieke vectoren die de betekenis vastleggen. Semantisch vergelijkbare teksten produceren vergelijkbare vectoren, zelfs met verschillende bewoordingen.
Sentence Transformers genereert deze inbeddingen:
uit sentence_transformers importeer SentenceTransformer, util
model = SentenceTransformer(‘all-MiniLM-L6-v2’)
zinnen = [
‘Python is een programmeertaal’,
‘Python wordt gebruikt voor codering,
‘Slangen zijn reptielen’
]
inbeddingen = model.encode(zinnen)
# Bereken gelijkenis tussen eerste en andere zinnen
similariteit_1_2 = util.cos_sim(embeddings[0], embeddings[1])
similariteit_1_3 = util.cos_sim(embeddings[0], embeddings[2])
print(f'Gelijkenis (1-2): {gelijkenis_1_2.item():.3f}’)
print(f'Gelijkenis (1-3): {gelijkenis_1_3.item():.3f}’)
De eerste twee zinnen vertonen een hoge gelijkenis ondanks verschillende woorden. De derde zin scoort lage gelijkenis-juiste identificatie van verschillende semantische betekenis.
Semantisch gerelateerde inhoud vinden
Embeddings identificeren gerelateerde artikelen voor interne links. Converteer alle site-artikelen naar embeddings en zoek vervolgens stukken met een hoge semantische gelijkenis.
Dit onthult natuurlijke koppelingsmogelijkheden die actuele clusters versterken:
artikelen = [
{‘titel’: ‘Python Basics’, ‘text’: ‘Inleiding tot Python programmeren...’},
{‘titel’: ‘Python voor gevorderden’, ‘text’: ‘Python-technieken voor gevorderden...’},
{‘titel’: ‘JavaScript-gids’, ‘tekst’:‘JavaScript-grondbeginselen leren...’}
]
embeddings = model.encode([a[‘tekst’] voor a in artikelen])
# Vind soortgelijke artikelen als de eerste
doel_embedding = embeddings[0]
overeenkomsten = [util.cos_sim(target_embedding, emb).item() voor emb in embeddings[1:]]
voor i, sim in enumerate(gelijkenissen, 1):
print(f”{articles[i][‘title’]}: {sim:.3f}”)
Artikelen met similariteitscores boven 0,6-0,7 zijn sterke kandidaten voor interne links. Zo worden semantische inhoudclusters opgebouwd die zoekmachines actuele expertise tonen.
Lokale SEO verbeteren met NLP
Zoeken op locatie vereist specifieke semantische optimalisatie. Python NLP extraheert locatie-entiteiten en zorgt voor de juiste geografische context.
Geografische entiteiten extraheren
spaCy identificeert locatievermeldingen automatisch:
importeren spacy
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Bezoek onze kantoren in Seattle, Portland en San Francisco’.’
doc = nlp(tekst)
locaties = [ent.text for ent in doc.ents if ent.label_ == ‘GPE’]
print(f'Genoemde locaties: {locaties}’)
GPE (Geo-Politieke Entiteit) legt steden, staten en landen vast. FAC legt faciliteiten en gebouwen vast.
Voor lokale SEO moet u ervoor zorgen dat locatie-entiteiten op natuurlijke wijze in de inhoud verschijnen. Servicepagina's moeten steden, buurten en regionale oriëntatiepunten vermelden.
Lokale zoekintentie analyseren
Lokale zoekopdrachten bevatten vaak impliciete locatie-intentie zonder expliciete locatiewoorden. “Coffeeshops” impliceert “coffeeshops bij mij in de buurt”.”
Het analyseren van SERP's voor zoekopdrachten laat zien wanneer zoekmachines lokale intentie toepassen:
- Kaartpakketten in resultaten geven lokale intentie aan
- Bedrijfsvermeldingen domineren ranglijsten
- Resultaten variëren per zoeklocatie
Inhoud die gericht is op deze zoekopdrachten heeft sterke lokale signalen nodig: adresvermeldingen, beschrijvingen van servicegebieden en lokaal relevante entiteiten.
Semantische rankings en prestaties bewaken
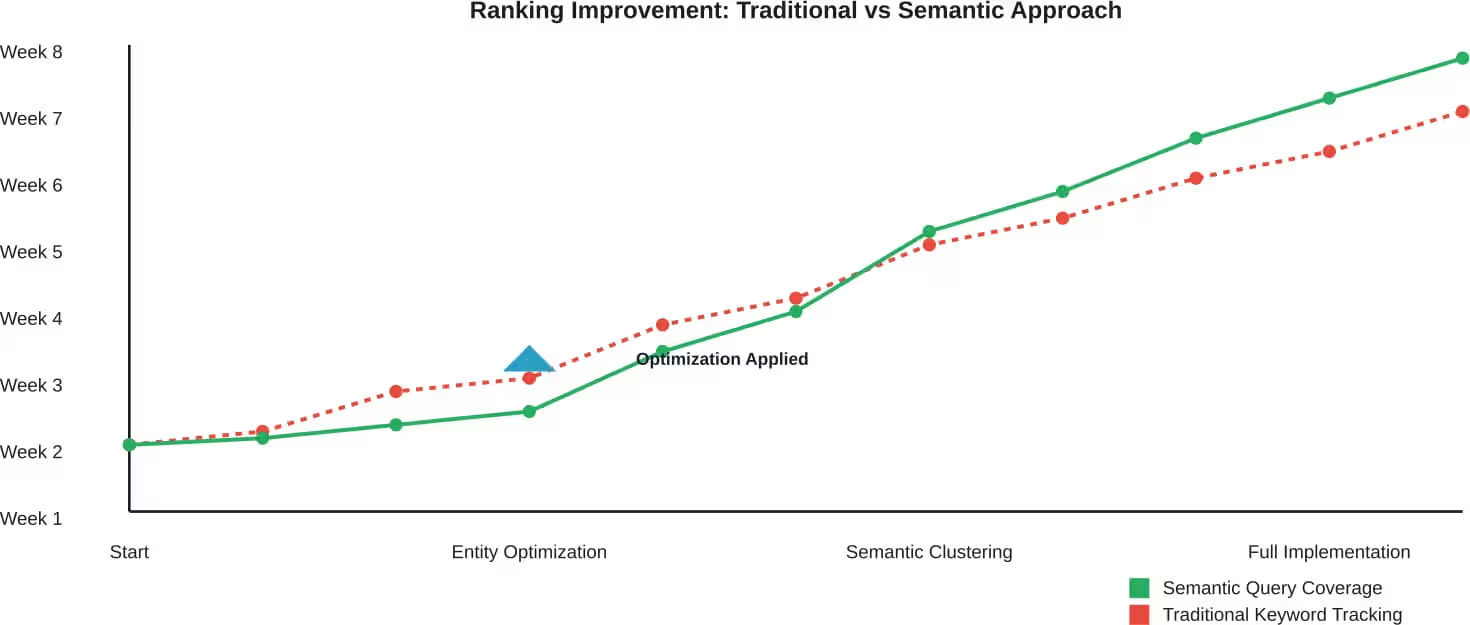
Het volgen van semantisch SEO-succes vereist andere statistieken dan het volgen van traditionele zoekwoorden. Monitor actuele autoriteitssignalen, zichtbaarheid van entiteiten en semantische verkeersgroei.
Op entiteiten gebaseerd rangvolgsysteem
In plaats van individuele zoekwoorden bij te houden, kunt u controleren hoe goed inhoud scoort op entiteitsgerelateerde zoekopdrachten. Als u zich richt op de entiteit “Python-programmeren”, volg dan rankings voor:
- Core entiteit queries (“Python programmeren”)
- Gerelateerde entiteit zoekopdrachten (“Python tutorials”, “Python bibliotheken”)
- Lange-staart semantische variaties
Verbeterde entiteitassociatie stimuleert verkeer via meerdere gerelateerde zoekopdrachten, niet alleen via trefwoorden.
Analyse van inhoudelijke prestaties
Vergelijk de inhoudsstatistieken voor en na semantische optimalisatie:
- Gemiddelde tijd op pagina (verbetering engagement)
- Pagina's per sessie (interne link effectiviteit)
- Bouncepercentage (relevantiematching)
- Indrukken voor gerelateerde zoekopdrachten (uitbreiding van topische autoriteit)
Semantische optimalisatie verhoogt meestal de breedte van het verkeer - het aantal verschillende zoekopdrachten die bezoeken genereren - in plaats van alleen het volume.
Gebruikelijke Python NLP SEO workflows
Effectieve implementatie combineert meerdere technieken in herhaalbare workflows. Deze processen veranderen geïsoleerde scripts in systematische optimalisatiebenaderingen.
Nieuwe workflow voor het maken van inhoud
Voordat je nieuwe inhoud schrijft:
- Scrape top 10 pagina's voor doelzoekopdracht
- Entiteiten van alle pagina's extraheren met spaCy
- Identificeer gemeenschappelijke entiteiten (70%+ aanwezigheid)
- Semantisch clusteren van gerelateerde trefwoorden
- Analyseer de inhoudsstructuur van SERP's (koppen, indeling)
- Bepaal dominante zoekintentie
- Gemiddelde lengte en leesbaarheid van inhoud berekenen
Creëer inhoud die voldoet aan de verwachtingen van de opmaak, die verwachte entiteiten dekt en die gericht is op de geïdentificeerde intentie. Deze gegevensgestuurde aanpak vermindert giswerk.
Bestaande workflow voor inhoudoptimalisatie
Voor ondermaats presterende bestaande inhoud:
- Leesbaarheidsanalyse uitvoeren (zinnen identificeren om te vereenvoudigen)
- Huidige entiteitsdekking uitpakken
- Vergelijk met de dekking van concurrerende entiteiten
- Ontbrekende entiteiten uit topresultaten identificeren
- Controleer semantische overeenkomsten met top-ranking inhoud
- Mogelijkheden voor intern linken vinden via embeddings
- Inhoud bijwerken met opgevulde gaten
Deze systematische aanpak zorgt ervoor dat optimalisatie zich richt op de werkelijke tekortkomingen in plaats van willekeurige veranderingen aan te brengen.
Beste praktijken en overwegingen voor implementatie
Een succesvolle implementatie van Python NLP vereist een evenwicht tussen automatisering en redactionele beoordeling. Scripts bieden datagestuurde inzichten, maar de kwaliteit van de inhoud is uiteindelijk afhankelijk van menselijke expertise.
Kwaliteit van gegevens is belangrijk
De kwaliteit van geautomatiseerde analyses hangt volledig af van de kwaliteit van de invoergegevens. Het scrapen van de inhoud van concurrenten vereist een nauwkeurige extractie van de inhoud, inclusief navigatie, advertenties en voetteksten. Veel sites structureren content anders, waardoor aangepaste extractielogica nodig is.
Test scripts op kleine samples voordat ze op schaal worden uitgevoerd. Controleer de nauwkeurigheid van de entiteitsextractie handmatig. Controleer of de berekeningen voor leesbaarheid de werkelijke leesmoeilijkheid weergeven. Slechte invoergegevens leveren misleidende analyses op.
Overdrijf niet
NLP-tools onthullen optimalisatiekansen, maar door elke geïdentificeerde entiteit in de inhoud te proppen, ontstaat er onnatuurlijk schrijfwerk. Geef prioriteit aan de meest relevante entiteiten en onderwerpen. Niet elk semantisch gat hoeft te worden opgevuld.
Zoekmachines detecteren patronen van overoptimalisatie. Inhoud die is volgepropt met entiteiten voor manipulatiedoeleinden presteert slecht. Natuurlijke dekking van echt relevante concepten werkt beter dan geforceerde vermeldingen.
Geautomatiseerde analyse combineren met menselijk oordeel
Python-scripts identificeren welke onderwerpen concurrenten behandelen en welke entiteiten ze noemen. Menselijke redacteuren bepalen hoe deze onderwerpen op een natuurlijke manier kunnen worden behandeld en of ze daadwerkelijk van belang zijn voor de doelgroep.
Geautomatiseerde leesbaarheidsscores bieden houvast, maar de context is van belang. In technische inhoud voor een deskundig publiek wordt terecht complexe taal gebruikt. Vereenvoudiging is niet altijd gepast.
Modellen bijgewerkt houden
NLP bibliotheken en modellen worden regelmatig bijgewerkt. spaCy brengt nieuwe versies uit met verbeterde nauwkeurigheid. Transformers voegt regelmatig nieuwe voorgetrainde modellen toe. Het periodiek updaten van afhankelijkheden zorgt voor toegang tot verbeteringen.
Modelupdates kunnen de uitvoer licht wijzigen. Test bijgewerkte versies voordat u ze inzet in productieworkflows om eventuele gedragsveranderingen te begrijpen.
Verder met Python NLP voor SEO
Het semantische web blijft zich ontwikkelen. Zoekalgoritmen worden steeds verfijnder in het begrijpen van context en het evalueren van expertise. Python NLP tools bieden de analytische mogelijkheden die nodig zijn om bij te blijven.
Begin met eenvoudige implementaties. Extraheer entiteiten uit top-ranking content. Bereken de leesbaarheid voor bestaande pagina's. Bouw van daaruit verder naarmate u meer vertrouwd raakt met de tools.
Het concurrentievoordeel komt van consistente toepassing, niet van perfecte scripts. Sites die semantische analyse systematisch toepassen op de planning en optimalisatie van inhoud, behalen na verloop van tijd steeds meer voordelen.
Zoekmachines belonen uitgebreide, goed gestructureerde inhoud die getuigt van actuele expertise. Python NLP automatiseert het vinden van hoe uitgebreide dekking eruit ziet voor elk onderwerp. De rest is uitvoering.
Implementatie vereist geen data science teams of complexe infrastructuur. De besproken bibliotheken draaien op elke computer. Een paar honderd regels Python-code kunnen contentworkflows transformeren.
De semantische toekomst van zoeken is al aangebroken. Tools die een paar jaar geleden hypermodern leken, zijn nu inzetbaar. Sites die deze technieken onder de knie hebben, krijgen een topische autoriteit waar traditionele trefwoordtactieken niet aan kunnen tippen.
Begin vandaag nog met het bouwen van uw Python NLP toolkit. Extraheer die entiteiten. Cluster die trefwoorden. Analyseer de inhoudsstructuur. De gegevens zullen u precies laten zien hoe uitgebreide actuele dekking eruitziet.









