


Resumen rápido: Python permite realizar análisis avanzados de PNL para SEO semántico a través de bibliotecas como spaCy, NLTK y Hugging Face Transformers. Estas herramientas extraen entidades, analizan la intención de búsqueda, agrupan las palabras clave semánticamente y optimizan el contenido para que tenga más relevancia temática que la tradicional concordancia de palabras clave. La automatización de estas tareas con scripts de Python ayuda a los sitios web a conseguir autoridad temática y una mejor clasificación en los algoritmos de búsqueda modernos.
Hace años que los motores de búsqueda evolucionaron más allá de la simple búsqueda de palabras clave. Ahora analizan el significado, entienden el contexto y evalúan la profundidad temática. Las tácticas tradicionales de SEO ya no sirven.
Python lo cambió todo para la optimización de contenidos. Las bibliotecas de procesamiento del lenguaje natural descifran cómo los algoritmos de búsqueda interpretan la semántica de los contenidos. ¿Y la barrera de entrada? Más baja de lo que la mayoría de la gente cree.
El tratamiento inteligente de textos en bruto requiere algo más que la concordancia de patrones. Palabras que parecen diferentes a menudo significan cosas similares. Las mismas palabras en distintos órdenes transmiten significados completamente diferentes. Según la documentación de spaCy, para resolver eficazmente estos problemas es necesario añadir conocimientos lingüísticos al análisis de caracteres en bruto.
Esta guía explica exactamente cómo las bibliotecas Python NLP transforman los flujos de trabajo de SEO semántico. Sin palabrería ni estadísticas inventadas. Solo estrategias de implementación prácticas respaldadas por documentación real de las bibliotecas.
Comprender los fundamentos de la PNL y el SEO semántico
El procesamiento del lenguaje natural enseña a las máquinas a entender el lenguaje humano. El SEO semántico aplica esa comprensión para crear contenidos que coincidan con la intención de búsqueda y las expectativas temáticas.
Pero los motores de búsqueda ya no se limitan a buscar palabras clave. Analizan entidades, relaciones y contexto. Una página sobre “programación en Python” debería tratar naturalmente conceptos relacionados como variables, funciones y bibliotecas. La ausencia de esas conexiones semánticas indica una cobertura incompleta.
Cómo procesan los motores de búsqueda el lenguaje semántico
Los algoritmos de búsqueda modernos utilizan modelos transformadores para comprender el significado de las consultas. BERT, desarrollado por Google AI Language en 2018, sirve de base para resolver más de 11 de las tareas de PLN más comunes, incluidos el análisis de sentimientos y el reconocimiento de entidades con nombre.
La metodología bidireccional es importante. BERT analiza el contexto en ambas direcciones alrededor de cada palabra, de forma similar a cómo los humanos rellenan los espacios en blanco de las frases leyendo el texto circundante. Según la documentación de Hugging Face, DistilBERT ofrece una versión más ligera que funciona 60% más rápido manteniendo más de 95% del rendimiento de BERT.
Los motores de búsqueda aplican estos modelos tanto a las consultas como a los contenidos. Extraen entidades, entienden relaciones y evalúan si el contenido cubre un tema de forma exhaustiva.
Por qué la búsqueda tradicional de palabras clave se queda corta
La optimización de la densidad de palabras clave tenía sentido cuando los algoritmos contaban la frecuencia de las palabras. Ahora ya no.
Hablando en serio: rellenar el contenido con palabras clave perjudica la clasificación. Los algoritmos de búsqueda detectan patrones de lenguaje poco naturales. Dan prioridad a los contenidos que cubren campos semánticos de forma natural.
Un enfoque semántico identifica grupos de conceptos. Para un tema como “aprendizaje automático”, los términos relacionados incluyen redes neuronales, datos de entrenamiento, algoritmos y validación de modelos. Las herramientas de PLN de Python extraen estas relaciones automáticamente.
Utilizar la PNL para mejorar el SEO
El uso de Python para la PNL y el SEO semántico es sólo una pieza de una estrategia más amplia, y LENGREO ayuda a integrar estas técnicas en marcos SEO completos que generan resultados. El éxito depende de la adecuación del contenido a la intención de búsqueda.
- agrupación de palabras clave y mapeo de intenciones
- optimización semántica de contenidos
- marcos SEO escalables
Si quieres convertir datos en clasificaciones, contacto LENGREO para empezar.
Bibliotecas esenciales de Python para PNL y SEO semántico
Tres ecosistemas de bibliotecas dominan la PNL en Python: NLTK para las tareas básicas, spaCy para los procesos de producción y Hugging Face Transformers para los modelos más avanzados.
Cada una sirve para casos de uso diferentes. La elección de la herramienta adecuada depende de las necesidades específicas de análisis.
NLTK: La base
El conjunto de herramientas de lenguaje natural proporciona un acceso completo a los algoritmos lingüísticos. Está diseñado para aprender conceptos de PNL y crear prototipos de soluciones.
La instalación requiere un único comando:
pip install nltk
NLTK destaca en el preprocesamiento de textos, la tokenización y el análisis lingüístico básico. La curva de aprendizaje empieza suavemente, lo que lo hace accesible para quienes se inician en la PNL. Sin embargo, la velocidad de procesamiento está por detrás de las alternativas modernas.
Las mejores aplicaciones para SEO incluyen la limpieza de textos, la eliminación de palabras clave y el análisis básico de frecuencias. La amplia documentación y los recursos educativos hacen que NLTK sea ideal para comprender los fundamentos de la PNL antes de pasar a las herramientas de producción.
spaCy: Procesamiento listo para la producción
Según la documentación oficial de spaCy, spaCy es una biblioteca gratuita de código abierto para el procesamiento avanzado del lenguaje natural en Python. Está pensada para aplicaciones reales en las que el rendimiento es importante.
La instalación sigue un proceso de dos pasos:
pip install spacy
python -m spacy descargar en_core_web_sm
La arquitectura da prioridad a la velocidad. Como muchas bibliotecas de PNL, spaCy codifica todas las cadenas en valores hash, reduciendo el uso de memoria y mejorando la eficiencia. Para obtener representaciones de cadena legibles de los atributos, añada un guión bajo al nombre del atributo.
Al procesar un documento se crea un objeto Doc que contiene tokens, entidades y relaciones sintácticas:
importar spacy
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Microsoft compró Activision por $68.700 millones el 18 de enero’
doc = nlp(texto)
para ent en doc.ents:
print(ent.texto, ent.etiqueta_)
Este script identifica “Microsoft” y “Activision” como organizaciones, “$68.700 millones” como dinero y “18 de enero” como fecha. Los profesionales del marketing que utilizan spaCy en Python informan de ciclos de optimización de contenidos 25-35% más rápidos gracias a la generación automatizada de sinónimos y el análisis de campos semánticos.
Transformadores de caras abrazables: Modelos de última generación
La biblioteca Transformers proporciona acceso a modelos preentrenados como BERT, GPT y variantes especializadas. Estos modelos comprenden el contexto a niveles que los algoritmos tradicionales no pueden igualar.
Instalación:
pip install transformadores
Los modelos transformadores destacan en la comprensión de la intención de búsqueda, la generación de frases semánticamente similares y el análisis de la profundidad de los contenidos. Los requisitos informáticos son superiores a los de spaCy, pero la calidad de la comprensión semántica justifica el coste de los análisis críticos.
En las aplicaciones de búsqueda semántica, las incrustaciones basadas en transformadores captan el significado con más eficacia que los vectores de palabras tradicionales. Esto permite mejorar el análisis de brechas de contenido y la concordancia de intenciones.
| Biblioteca | Instalación | Ideal para | Curva de aprendizaje | Aplicaciones SEO |
|---|---|---|---|---|
| NLTK | pip install nltk | Fundamentos del aprendizaje | Para principiantes | Preprocesamiento de textos, análisis de frecuencias |
| spaCia | pip install spacy | Conductos de producción | Moderado | Extracción de entidades, análisis sintáctico de dependencias |
| Transformers | pip install transformadores | Semántica avanzada | Avanzado | Análisis de intenciones, similitud semántica |
Reconocimiento de entidades con nombre para la optimización de contenidos
El reconocimiento de entidades con nombre (NER) identifica y clasifica las entidades mencionadas en un texto. Los motores de búsqueda utilizan técnicas similares para entender de qué se habla en los contenidos.
Las entidades incluyen personas, organizaciones, lugares, fechas, productos y mucho más. La amplia cobertura de entidades indica la autoridad del tema.
Extracción de entidades con spaCy
Los modelos preentrenados de spaCy identifican entidades desde el primer momento. El proceso solo requiere unas pocas líneas de código:
importar spacy
from spacy import displacy
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Apple anunció el iPhone 15 en Cupertino el 12 de septiembre de 2023’
doc = nlp(texto)
para ent en doc.ents:
print(f'{ent.text}: {ent.label_}’)
Así se identifica a Apple como organización, el iPhone 15 como producto, Cupertino como ubicación y la fecha. El análisis de los contenidos de la competencia revela qué entidades cubren y qué lagunas existen.
Construir mapas de cobertura de entidades
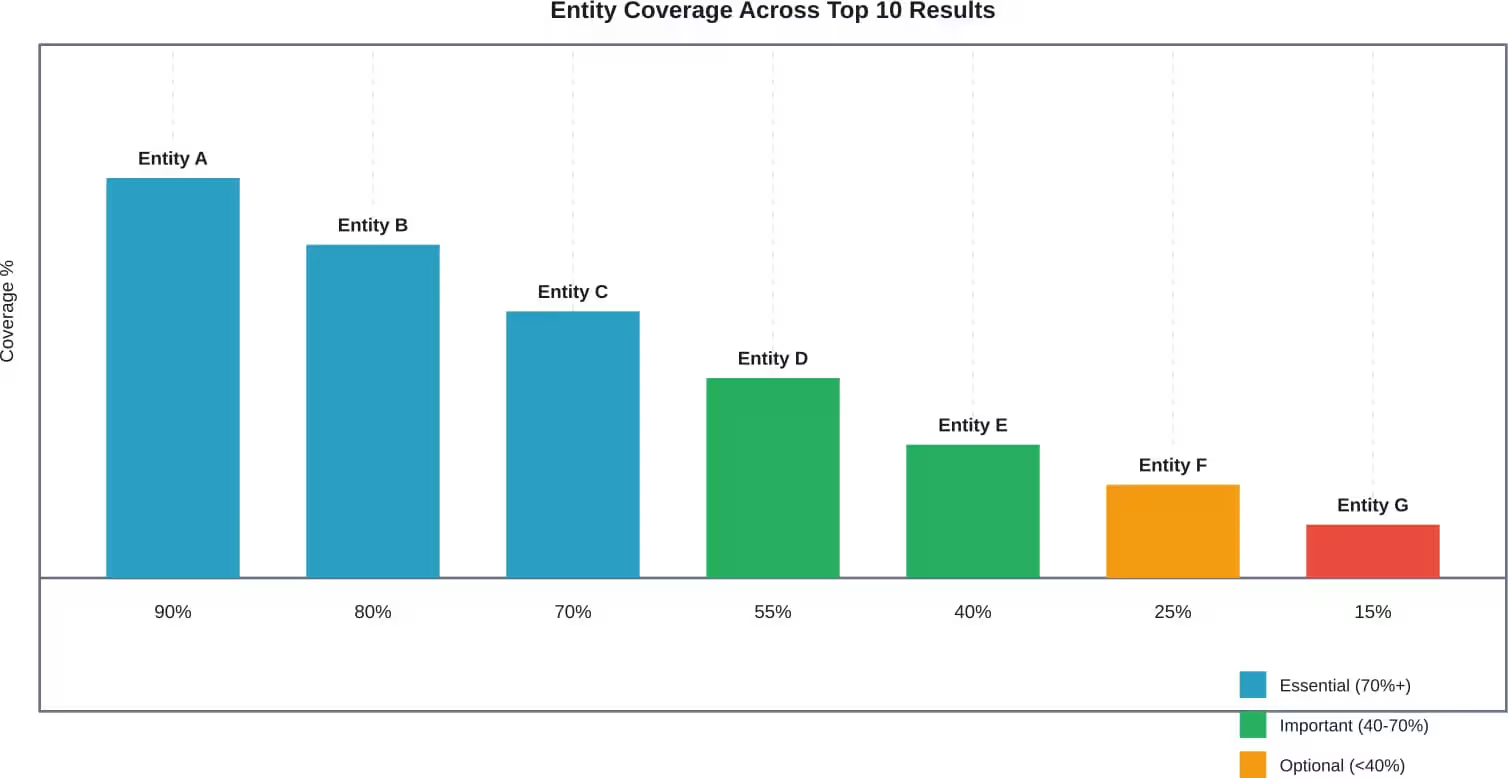
La autoridad temática requiere mencionar entidades relevantes de forma natural. Los scripts de Python pueden analizar las páginas mejor clasificadas y extraer patrones de frecuencia de entidades.
El método es el siguiente: se extraen los 10 primeros resultados de una consulta, se extraen las entidades de cada uno de ellos, se cuenta la frecuencia de entidades en los resultados y se identifican las entidades presentes en más de 70% de los primeros resultados.
Las entidades que aparecen en la mayoría de los primeros resultados representan la cobertura temática esperada. Es probable que los algoritmos de búsqueda consideren incompleto el contenido en el que faltan estas entidades. Añadirlas de forma natural -sin forzar menciones- refuerza la relevancia semántica.
Agrupación semántica de palabras clave con Python
La agrupación de palabras clave agrupa los términos de búsqueda relacionados basándose en la similitud semántica y no sólo en el solapamiento de palabras. Esto revela cómo piensan los buscadores sobre los temas y cómo debe estructurarse el contenido.
La agrupación tradicional se fijaba en las palabras compartidas. La agrupación semántica analiza el significado. “Los mejores smartphones” y “los mejores teléfonos móviles” no comparten ninguna palabra, pero expresan la misma intención.
Agrupación basada en TF-IDF
Frecuencia de términos-Frecuencia inversa de documentos mide la importancia de las palabras en los documentos. Las palabras que aparecen con frecuencia en un documento pero raramente en otros obtienen una puntuación alta.
La técnica funciona para la agrupación inicial de palabras clave:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.cluster import KMeans
keywords = [‘tutorial python’, ‘aprender python’, ‘guía python’,
‘fundamentos del aprendizaje automático’, ‘introducción al aprendizaje automático’, ‘iniciarse en el aprendizaje automático’].
vectorizador = TfidfVectorizador()
X = vectorizer.fit_transform(palabras clave)
kmeans = KMeans(n_clusters=2)
kmeans.fit(X)
print(kmeans.etiquetas_)
Esto agrupa las palabras clave en clusters. Las tres primeras palabras clave se agrupan juntas (aprendizaje de Python), mientras que las tres últimas se agrupan por separado (introducción al aprendizaje automático).
Agrupación semántica avanzada con incrustaciones
Las incrustaciones basadas en transformadores captan la similitud semántica con mayor precisión. Entienden que “automóvil” y “coche” significan lo mismo a pesar de tener caracteres diferentes.
La biblioteca Sentence Transformers simplifica esta tarea:
from transformadores_de_sentencia import Transformador_de_sentencia
from sklearn.cluster import AgglomerativeClustering
model = Transformador de frases(‘all-MiniLM-L6-v2’)
palabras clave = [‘mejores portátiles 2026’, ‘mejores portátiles de este año’,
‘guía de compra de portátiles’, ‘cómo elegir un ordenador’].
incrustaciones = model.encode(palabras clave)
clustering = AgglomerativeClustering(n_clusters=2)
etiquetas = clustering.fit_predict(incrustaciones)
Este método agrupa consultas semánticamente similares aunque utilicen una redacción completamente distinta. Las comparaciones de productos se agrupan por separado de las guías prácticas.
Creación de concentradores de contenidos a partir de clusters
Una vez que las palabras clave se agrupen semánticamente, estructure el contenido en consecuencia. Cada grupo se convierte en un centro de contenidos con una página principal y artículos de apoyo.
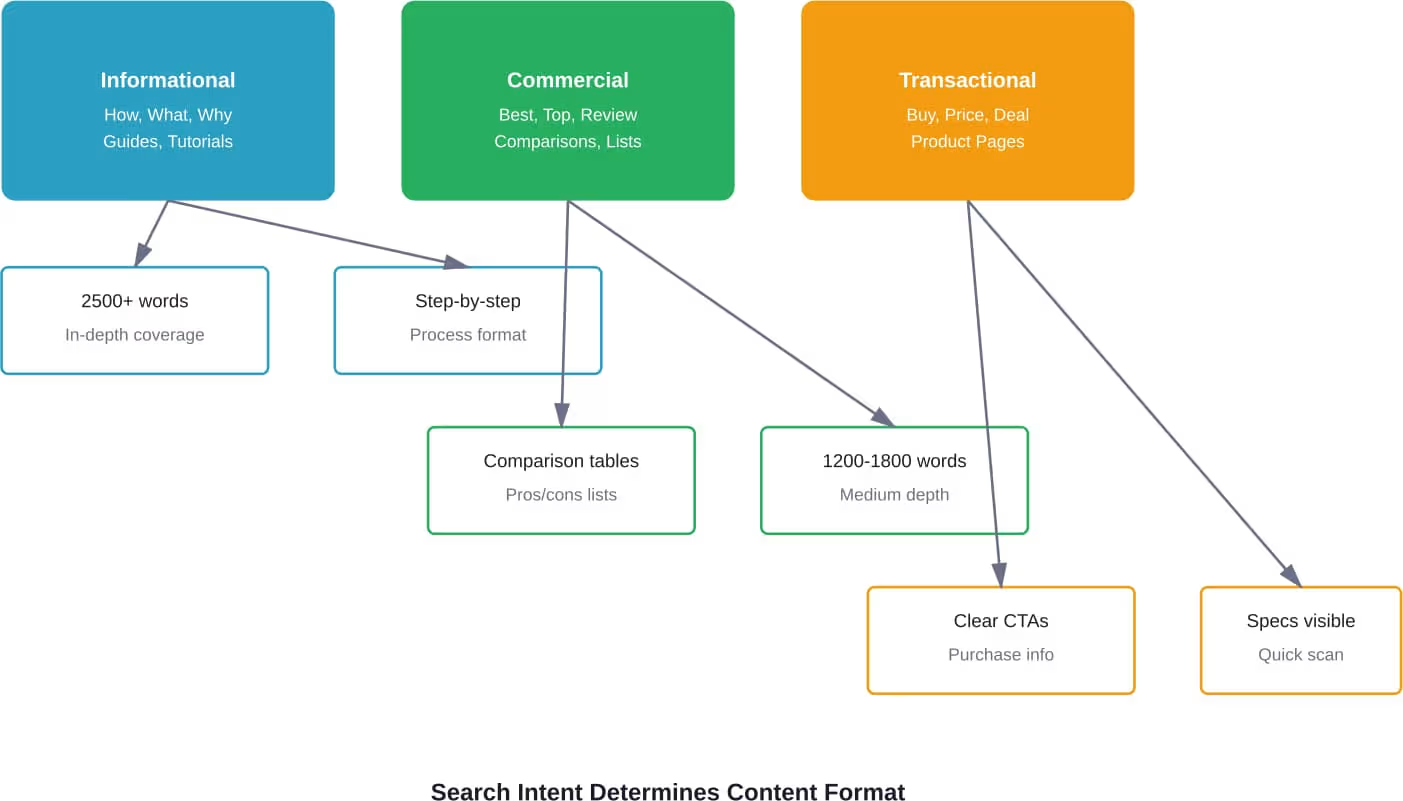
Los clusters revelan patrones de intención de búsqueda. Las consultas informativas se agrupan. Los términos comerciales forman grupos separados. Esto informa sobre la selección del tipo de contenido y la arquitectura de enlaces internos.
Análisis de la intención de búsqueda con PNL
La intención de búsqueda determina qué tipo de contenido satisface una consulta. Las herramientas Python NLP clasifican la intención automáticamente analizando los patrones de consulta y los contenidos mejor clasificados.
Existen cuatro tipos principales de intención: informativa (aprendizaje), de navegación (búsqueda de sitios específicos), comercial (búsqueda de productos) y transaccional (lista para comprar).
Clasificación de intenciones mediante el análisis de consultas
La estructura de las preguntas revela la intención. Las preguntas que empiezan por “cómo”, “qué” o “por qué” indican una intención informativa. Las frases que contienen “mejor”, “mejor” o “revisión” indican una intención de investigación comercial.
Un clasificador sencillo utiliza la concordancia de patrones:
importar re
def clasificar_intento(consulta):
query_lower = query.lower()
informational_patterns = [r’^cómo’, r’^qué’, r’^por qué’, r’^cuándo’, r'guía’, r'tutorial’]
commercial_patterns = [r'best’, r'top’, r'review’, r'compare’, r'vs’]
transactional_patterns = [r'comprar’, r'comprar’, r'precio’, r'barato’, r'trato’]
for patrón in patrones_transaccionales:
si re.search(pattern, query_lower):
return ‘Transaccional’
for patrón in patrones_comerciales:
si re.search(pattern, query_lower):
return ‘Comercial’
for patrón in patrones_informativos:
si re.search(pattern, query_lower):
return ‘Informativo’
return ‘Navegación’
print(clasificar_intento(‘cómo aprender python’)) # Informativo
print(clasificar_intento(‘mejores cursos de python’)) # Comercial
Análisis del contenido de las SERP para validar la intención
Los tipos de contenido mejor clasificados validan la clasificación de la intención. Si todos los resultados principales son artículos de listas, la consulta espera contenido comparativo. Si predominan los tutoriales, el contenido instructivo es el más adecuado.
El análisis automatizado de las SERP extrae patrones:
- Contar los signos de interrogación en los títulos (contenido tipo FAQ)
- Identificar los indicadores de la lista (pasos numerados, viñetas)
- Detectar menciones y precios de productos (contenido comercial)
- Medir la longitud media de los contenidos (expectativas de profundidad)
Adaptar el formato del contenido a los patrones dominantes de las SERP mejora el potencial de clasificación. Un tutorial detallado no se clasificará para una consulta en la que los buscadores esperan comparaciones rápidas de productos.
Análisis de brechas de contenido con Python
Las lagunas de contenido representan temas que la competencia cubre y que su sitio no cubre. Identificar y llenar estos vacíos crea autoridad temática y capta tráfico de búsqueda adicional.
El análisis manual de carencias lleva horas. Python automatiza el proceso en minutos.
Estructuras de contenido de la competencia
El análisis de los encabezamientos de los competidores revela su cobertura temática. Beautiful Soup extrae las estructuras de los encabezados con eficacia:
from bs4 import BeautifulSoup
solicitudes de importación
url = ‘https://competitor.com/target-article’
response = requests.get(url)
soup = BeautifulSoup(response.content, ‘html.parser’)
encabezamientos = []
for heading in soup.find_all([‘h2’, ‘h3’]):
headings.append(heading.get_text().strip())
para h en encabezamientos:
print(h)
Ejecutar esto contra múltiples páginas de alto rango. Extraiga todos los títulos H2 y H3. Compare sus temas con el contenido existente.
Encontrar la cobertura temática que falta
Una vez recopilados los títulos de los competidores, identifique los temas comunes ausentes en su contenido. Los temas que aparecen en más de 60% de los primeros resultados pero que no aparecen en sus páginas representan claras lagunas.
Un script de análisis de frecuencia cuenta la aparición de temas en los encabezamientos:
from colecciones import Contador
importar re
all_competitor_headings = [
# Rúbricas del competidor 1
[‘Introducción’, ‘Guía de instalación’, ‘Técnicas avanzadas’, ‘Errores comunes’],
# Rúbricas del competidor 2
[‘Primeros pasos’, ‘Guía de instalación’, ‘Solución de problemas’, ‘Buenas prácticas’],
# Rúbricas del competidor 3
[‘Visión general’, ‘Instalación’, ‘Técnicas avanzadas’, ‘Errores comunes’]
]
cabeceras_planas = [h para sublista en cabeceras_de_todos_los_competidores para h en sublista]
head_counts = Contador(flat_headings)
para encabezamiento, recuento en recuentos_encabezamiento.más_comunes():
percentage = (count / len(all_competitor_headings)) * 100
print(f'{encabezado}: {cuenta} ocurrencias ({porcentaje:.0f}%)’)
Los títulos que aparecen con frecuencia entre los competidores pero que faltan en su contenido deben añadirse. Esto no significa copiar su estructura, sino garantizar una cobertura completa de los subtemas previstos.
Optimizar la legibilidad y la estructura de los contenidos
La legibilidad afecta tanto a la participación de los usuarios como a la clasificación en las búsquedas. Las herramientas de Python miden la legibilidad de forma objetiva e identifican oportunidades de mejora.
Los motores de búsqueda tienen en cuenta el tiempo de permanencia y las señales de compromiso. Los contenidos difíciles de leer alejan rápidamente a los visitantes, lo que envía señales negativas de clasificación.
Cálculo de los índices de legibilidad
La biblioteca textstat calcula métricas estándar de legibilidad:
importar textstat
text = ”’Tu contenido va aquí. Puede ser un artículo completo
o sólo una sección que desee analizar para facilitar la lectura”’.’
flesch_reading_ease = textstat.flesch_reading_ease(texto)
flesch_kincaid_grado = textstat.flesch_kincaid_grado(texto)
print(f'Facilidad de lectura Flesch: {flesch_reading_ease}’)
print(f'Grado: {flesch_kincaid_grado}’)
Las puntuaciones de Flesch Reading Ease superiores a 60 indican contenidos accesibles. Las puntuaciones por debajo de 30 sugieren una lectura difícil que puede perder audiencia. El nivel de Flesch-Kincaid indica el grado escolar necesario en EE.UU. para comprender el texto.
Para la mayoría de los contenidos web, apunte a los grados 8-10. Los temas técnicos pueden justificar niveles más altos, pero incluso los temas complejos se benefician de una redacción clara. Los temas técnicos pueden justificar niveles más altos, pero incluso los temas complejos se benefician de una redacción clara.
Análisis de la longitud y complejidad de las frases
La longitud media de las frases influye en la legibilidad. Las frases muy largas cansan al lector. Las frases demasiado cortas resultan entrecortadas.
spaCy analiza la estructura de las frases:
importar spacy
nlp = spacy.load(‘en_core_web_sm’)
text = ”’Su texto del artículo aquí.”’
doc = nlp(texto)
longitud_frase = [len(sent) for sent in doc.sents]
longitud_media = suma(longitud_frase) / longitud(longitud_frase)
print(f'Longitud media de la frase: {longitud_media:.1f} palabras’)
print(f'Frase más larga: {max(longitud_frase)} palabras’)
print(f'La frase más corta: {min(longitud_frase)} palabras’)
La longitud media de las frases debe oscilar entre 15 y 20 palabras. Combine frases cortas y contundentes con otras más largas y detalladas. Las frases que superan las 35-40 palabras suelen confundir a los lectores y deben dividirse.
Creación de herramientas automatizadas de análisis de contenidos SEO
La combinación de técnicas de PLN en herramientas de análisis unificadas automatiza las tareas de optimización repetitivas. Un único script puede extraer entidades, clasificar la intención, medir la legibilidad e identificar lagunas.
Creación de un guión de auditoría de contenidos
Un completo guión de auditoría analiza los contenidos existentes a escala:
importar spacy
importar textstat
from colecciones import Contador
nlp = spacy.load(‘en_core_web_sm’)
def analizar_contenido(texto):
doc = nlp(texto)
# Extracción de entidades
entidades = [(ent.texto, ent.etiqueta_) for ent in doc.ents]
entity_counts = Counter([etiqueta para _, etiqueta en entidades])
# Legibilidad
legibilidad = textstat.flesch_reading_ease(texto)
nivel_grado = textstat.flesch_kincaid_grado(texto)
Estructura #
sentence_count = len(list(doc.sents))
word_count = len([token for token in doc if not token.is_punct])
devolver {
‘word_count’: word_count,
‘recuento_de_frases’: recuento_de_frases,
‘readability_score’: legibilidad,
‘grado_nivel’: grado_nivel,
‘entity_counts’: dict(entity_counts),
‘unique_entities’: len(set([text for text, _ in entities]))
}
# Utilización en el contenido
resultados = analizar_contenido(su_texto_artículo)
print(resultados)
Esto proporciona métricas procesables: recuento de palabras, recuento de frases, puntuaciones de legibilidad, diversidad de entidades y distribución de tipos de entidades. Ejecútelo en todo el contenido del sitio para identificar las páginas de bajo rendimiento.
Panel comparativo con la competencia
Analizar los contenidos de la competencia junto con los propios revela los puntos fuertes y débiles relativos. Un script de comparación procesa varias URL:
solicitudes de importación
from bs4 import BeautifulSoup
def scrape_and_analyze(url):
response = requests.get(url)
soup = BeautifulSoup(response.content, ‘html.parser’)
# Extraer el contenido principal (ajustar el selector a los sitios de destino)
contenido = soup.find(‘articulo’).get_text()
return analizar_contenido(contenido)
competidor_urls = [
‘https://competitor1.com/article’,
‘https://competitor2.com/article’
]
para url en urls_competidor:
print(f’\nAnalizando: {url}’)
resultados = scrape_and_analyze(url)
print(f ”Palabras: {resultados[‘recuento_palabras’]}”)
print(f ”Legibilidad: {resultados[‘puntuación_legibilidad’]:.1f}”)
print(f ”Entidades: {results[‘unique_entities’]}”)
Compare sus métricas con las medias de la competencia. Si la media de los competidores es de 2.500 palabras y la suya contiene 1.200, ampliar la profundidad del contenido puede mejorar la clasificación. Si mencionan 25 entidades únicas y la suya abarca 12, aumentar la amplitud temática podría ayudar.
| Métrica | Su contenido | Promedio de la competencia | Medidas necesarias |
|---|---|---|---|
| Recuento de palabras | 1,850 | 2,600 | Ampliar la cobertura |
| Puntuación de legibilidad | 58 | 65 | Simplificar el lenguaje |
| Entidades únicas | 14 | 22 | Añadir entidades pertinentes |
| Duración media de las penas | 24 palabras | 18 palabras | Acortar las frases |
| Rúbricas (H2+H3) | 8 | 13 | Mejorar la estructura |
Transformadores para la búsqueda semántica
Los modelos de transformación revolucionaron la comprensión semántica. Impulsan los motores de búsqueda modernos y permiten técnicas avanzadas de optimización de contenidos.
Según las investigaciones sobre búsqueda semántica, los enfoques basados en transformadores superan con creces a los métodos léxicos tradicionales en tareas de recuperación de información.
Generación de incrustaciones semánticas
Las incrustaciones convierten el texto en vectores numéricos que captan el significado. Los textos semánticamente similares producen vectores similares, incluso con distinta redacción.
Sentence Transformers genera estas incrustaciones:
from sentencia_transformadores import SentenceTransformer, util
model = Transformador de frases(‘all-MiniLM-L6-v2’)
frases = [
‘Python es un lenguaje de programación’,
‘Python se utiliza para codificar’,
‘Las serpientes son reptiles’
]
incrustaciones = model.encode(frases)
# Calcular la similitud entre la primera frase y las demás
similitud_1_2 = util.cos_sim(incrustaciones[0], incrustaciones[1])
similitud_1_3 = util.cos_sim(incrustaciones[0], incrustaciones[2])
print(f'Similitud (1-2): {semejanza_1_2.item():.3f}’)
print(f'Similitud (1-3): {semejanza_1_3.item():.3f}’)
Las dos primeras frases muestran una alta similitud a pesar de tener palabras diferentes. La tercera frase presenta una similitud baja, ya que identifica correctamente un significado semántico diferente.
Búsqueda de contenidos semánticamente relacionados
Las incrustaciones identifican artículos relacionados para enlaces internos. Convierta todos los artículos del sitio en incrustaciones y, a continuación, busque las piezas con alta similitud semántica.
Esto revela oportunidades naturales de enlace que refuerzan las agrupaciones temáticas:
artículos = [
{‘title’: ‘Conceptos básicos de Python’, ‘text’: ‘Introducción a la programación en Python...’},
{‘title’: ‘Python avanzado’, ‘text’: ‘Técnicas avanzadas de Python...’},
{‘title’: ‘Guía JavaScript’, ‘text’: ‘Aprendiendo los fundamentos de JavaScript...’}
]
embeddings = model.encode([a[‘texto’] for a in artículos])
# Buscar artículos similares al primero
incrustación_objetivo = incrustaciones[0]
similitudes = [util.cos_sim(target_embedding, emb).item() for emb in embeddings[1:]]
para i, sim en enumerar(similitudes, 1):
print(f”{artículos[i][‘título’]}: {sim:.3f}”)
Los artículos con puntuaciones de similitud superiores a 0,6-0,7 son buenos candidatos para enlaces internos. De este modo se crean grupos de contenidos semánticos que demuestran a los motores de búsqueda su experiencia en el tema.
Mejora del SEO local con PNL
Las búsquedas basadas en la localización requieren una optimización semántica específica. Python NLP extrae entidades de localización y garantiza un contexto geográfico adecuado.
Extracción de entidades geográficas
spaCy identifica automáticamente las menciones de ubicación:
importar spacy
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Visite nuestras oficinas de Seattle, Portland y San Francisco’
doc = nlp(texto)
locations = [ent.text for ent in doc.ents if ent.label_ == ‘GPE’]
print(f'Localidades mencionadas: {localidades}’)
GPE (Entidad Geopolítica) captura ciudades, estados y países. FAC captura instalaciones y edificios.
Para el SEO local, asegúrese de que las entidades de localización aparecen de forma natural en todo el contenido. Las páginas de servicios deben mencionar las ciudades, barrios y puntos de referencia regionales en los que se presta servicio.
Análisis de la intención de búsqueda local
Las consultas locales a menudo incluyen una intención implícita de ubicación sin palabras explícitas de ubicación. “Cafeterías” implica “cafeterías cerca de mí”.”
El análisis de las SERP para las consultas revela cuándo los motores de búsqueda aplican la intención local:
- Los paquetes de mapas en los resultados indican la intención local
- Las listas de empresas dominan las clasificaciones
- Los resultados varían según la ubicación del buscador
El contenido dirigido a estas consultas necesita fuertes señales locales: menciones de direcciones, descripciones de áreas de servicio y entidades localmente relevantes.
Supervisión de las clasificaciones semánticas y el rendimiento
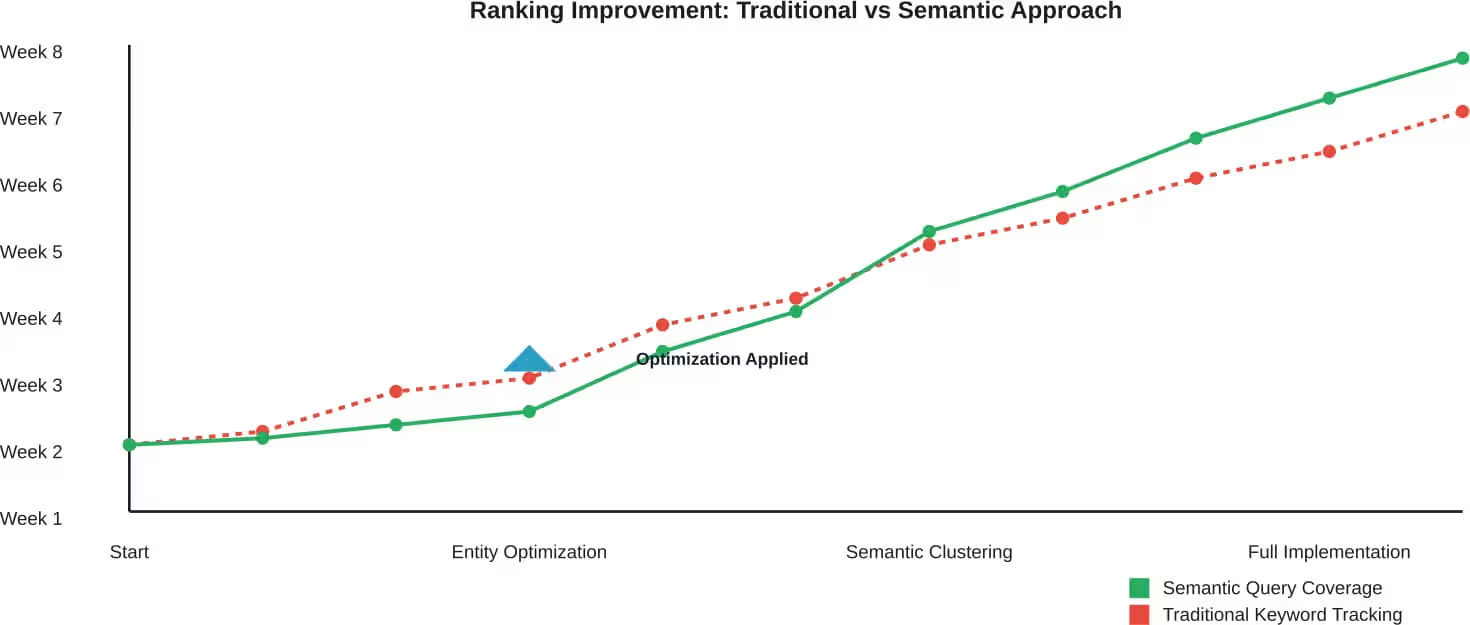
El seguimiento del éxito del SEO semántico requiere métricas diferentes a las del seguimiento tradicional de palabras clave. Supervise las señales de autoridad tópica, la visibilidad de las entidades y el crecimiento del tráfico semántico.
Rastreo de rango basado en entidades
En lugar de rastrear palabras clave individuales, controle la clasificación del contenido para consultas relacionadas con entidades. Si el objetivo es la entidad “programación Python”, realice un seguimiento de las clasificaciones para:
- Consultas sobre entidades básicas (“Programación en Python”)
- Consultas de entidades relacionadas (“tutoriales de Python”, “bibliotecas de Python”)
- Variaciones semánticas de cola larga
Una mejor asociación de entidades impulsa el tráfico en múltiples consultas relacionadas, no sólo en las palabras clave objetivo.
Análisis del rendimiento de los contenidos
Compare las métricas de contenido antes y después de la optimización semántica:
- Tiempo medio en la página (mejora del compromiso)
- Páginas por sesión (eficacia de los enlaces internos)
- Tasa de rebote (concordancia de relevancia)
- Impresiones para consultas relacionadas (ampliación de la autoridad temática)
La optimización semántica suele aumentar la amplitud del tráfico -el número de consultas diferentes que generan visitas- y no sólo el volumen.
Flujos de trabajo comunes de Python NLP SEO
Una aplicación eficaz combina múltiples técnicas en flujos de trabajo repetibles. Estos procesos convierten guiones aislados en enfoques de optimización sistemáticos.
Nuevo flujo de trabajo de creación de contenidos
Antes de escribir nuevos contenidos:
- Recopilación de las 10 páginas mejor clasificadas para la consulta deseada
- Extraer entidades de todas las páginas mediante spaCy
- Identificar entidades comunes (presencia 70%+)
- Agrupación semántica de palabras clave relacionadas
- Analizar la estructura del contenido de las SERP (encabezados, formato)
- Determinar la intención de búsqueda dominante
- Calcular la longitud media de los contenidos y su legibilidad
Cree contenidos que se ajusten a las expectativas de formato, cubran las entidades esperadas y aborden la intención identificada. Este enfoque basado en datos reduce las conjeturas.
Flujo de trabajo de optimización de contenidos existente
Para contenidos existentes de bajo rendimiento:
- Realice un análisis de legibilidad (identifique las frases que deben simplificarse).
- Extraer la cobertura actual de la entidad
- Comparación con la cobertura de las entidades de la competencia
- Identificar las entidades que faltan en los primeros resultados
- Compruebe la similitud semántica con los contenidos mejor clasificados
- Encontrar oportunidades de enlaces internos mediante incrustaciones
- Actualizar el contenido con las lagunas cubiertas
Este enfoque sistemático garantiza que la optimización aborde las deficiencias reales en lugar de introducir cambios aleatorios.
Mejores prácticas y consideraciones sobre la aplicación
Para aplicar con éxito la PNL en Python es necesario equilibrar la automatización con el juicio editorial. Los scripts proporcionan información basada en datos, pero la calidad del contenido depende en última instancia de la experiencia humana.
La calidad de los datos es importante
La calidad del análisis automatizado depende totalmente de la calidad de los datos de entrada. El scraping del contenido de la competencia requiere una extracción precisa del contenido, excluyendo la navegación, los anuncios y los pies de página. Muchos sitios estructuran el contenido de forma diferente, lo que requiere una lógica de extracción personalizada.
Pruebe las secuencias de comandos en muestras pequeñas antes de ejecutarlas a escala. Verifique manualmente la precisión de la extracción de entidades. Compruebe que los cálculos de legibilidad reflejan la dificultad de lectura real. Los datos de entrada incorrectos dan lugar a análisis engañosos.
No optimice en exceso
Las herramientas de PNL revelan oportunidades de optimización, pero atiborrar de contenido cada entidad identificada crea una redacción poco natural. Dé prioridad a las entidades y temas más relevantes. No hay que llenar todos los vacíos semánticos.
Los motores de búsqueda detectan patrones de sobreoptimización. Los contenidos atiborrados de entidades con fines de manipulación obtienen malos resultados. La cobertura natural de conceptos realmente relevantes funciona mejor que las menciones forzadas.
Combinar el análisis automatizado con el juicio humano
Los scripts de Python identifican qué temas tratan los competidores y qué entidades mencionan. Los redactores humanos determinan cómo abordar esos temas con naturalidad y si realmente son importantes para el público objetivo.
Las puntuaciones automatizadas de legibilidad sirven de orientación, pero el contexto es importante. Los contenidos técnicos para audiencias expertas utilizan legítimamente un lenguaje complejo. La simplificación no siempre es adecuada.
Mantenga actualizados los modelos
Las bibliotecas y modelos de PNL se actualizan con frecuencia. spaCy publica nuevas versiones con mayor precisión. Transformers añade regularmente nuevos modelos preentrenados. La actualización periódica de las dependencias garantiza el acceso a las mejoras.
Las actualizaciones de los modelos pueden modificar ligeramente los resultados. Pruebe las versiones actualizadas antes de desplegarlas en los flujos de trabajo de producción para comprender cualquier cambio de comportamiento.
Avanzando con Python NLP para SEO
La web semántica sigue evolucionando. Los algoritmos de búsqueda son cada vez más sofisticados a la hora de comprender el contexto y evaluar la experiencia. Las herramientas de PLN de Python ofrecen las capacidades analíticas necesarias para seguir el ritmo.
Comience con implementaciones sencillas. Extraiga entidades de los contenidos mejor clasificados. Calcule la legibilidad de las páginas existentes. Aumente a medida que se familiarice con las herramientas.
La ventaja competitiva procede de una aplicación coherente, no de guiones perfectos. Los sitios que aplican sistemáticamente el análisis semántico a la planificación y optimización de contenidos acumulan ventajas con el tiempo.
Los motores de búsqueda recompensan los contenidos exhaustivos y bien estructurados que demuestran conocimientos sobre un tema. Python NLP automatiza la búsqueda de contenidos completos sobre cualquier tema. El resto es ejecución.
La implementación no requiere equipos de ciencia de datos ni infraestructuras complejas. Las bibliotecas discutidas se ejecutan en cualquier ordenador. Unos cientos de líneas de código Python pueden transformar los flujos de trabajo de contenidos.
El futuro semántico de las búsquedas ya está aquí. Las herramientas que parecían de vanguardia hace unos años son ahora una apuesta segura. Los sitios que dominan estas técnicas establecen una autoridad tópica que las tácticas tradicionales de palabras clave no pueden igualar.
Empiece hoy mismo a crear su conjunto de herramientas de PNL en Python. Extraiga esas entidades. Agrupe esas palabras clave. Analice la estructura del contenido. Los datos le mostrarán exactamente cómo es una cobertura temática completa.









