


ملخص سريع: تتيح لغة Python تحليلًا متقدمًا في البرمجة اللغوية العصبية لتحسين محركات البحث الدلالية من خلال مكتبات مثل spaCy وNLTK وCugging Face Transformers. تقوم هذه الأدوات باستخراج الكيانات، وتحليل مقاصد البحث، وتجميع الكلمات المفتاحية دلاليًا، وتحسين المحتوى من أجل الملاءمة الموضعية بما يتجاوز مطابقة الكلمات المفتاحية التقليدية. تساعد أتمتة هذه المهام باستخدام نصوص Python البرمجية المواقع على تحقيق سلطة موضعية وترتيب أفضل في خوارزميات البحث الحديثة.
تطورت محركات البحث إلى ما هو أبعد من مجرد مطابقة الكلمات الرئيسية منذ سنوات. فهي الآن تقوم بتحليل المعنى وفهم السياق وتقييم العمق الموضعي. لم تعد تكتيكات تحسين محركات البحث التقليدية تفي بالغرض.
غيّر Python كل شيء لتحسين المحتوى. تقوم مكتبات معالجة اللغة الطبيعية بفك شفرة كيفية تفسير خوارزميات البحث لدلالات المحتوى. وما هو عائق الدخول؟ أقل مما يعتقده معظم الناس.
تتطلب معالجة النص الخام بذكاء أكثر من مجرد مطابقة الأنماط. فالكلمات التي تبدو مختلفة غالباً ما تعني أشياء متشابهة. الكلمات نفسها بترتيب مختلف تنقل معاني مختلفة تماماً. وفقًا لوثائق spaCy، يتطلب حل هذه المشاكل بفعالية إضافة المعرفة اللغوية إلى تحليل الأحرف الخام.
يوضح هذا الدليل بالضبط كيف تقوم مكتبات البرمجة اللغوية العصبية في بايثون بتحويل سير عمل تحسين محركات البحث الدلالية. لا زخرفة ولا إحصائيات مخترعة. فقط استراتيجيات تنفيذ عملية مدعومة بوثائق مكتبة حقيقية.
فهم أساسيات البرمجة اللغوية العصبية وأساسيات تحسين محركات البحث الدلالية
تعمل معالجة اللغة الطبيعية على تعليم الآلات فهم اللغة البشرية. يطبق مُحسّنات محرّكات البحث الدلالية هذا الفهم لإنشاء محتوى يتوافق مع هدف البحث والتوقعات الموضعية.
إليك الأمر - لم تعد محركات البحث تطابق الكلمات الرئيسية فقط. فهي تقوم بتحليل الكيانات والعلاقات والسياق. يجب أن تناقش صفحة عن “برمجة بايثون” بشكل طبيعي المفاهيم ذات الصلة مثل المتغيرات والوظائف والمكتبات. يشير فقدان هذه الروابط الدلالية إلى تغطية غير كاملة.
كيف تعالج محركات البحث اللغة من الناحية الدلالية
تستخدم خوارزميات البحث الحديثة نماذج المحولات لفهم معنى الاستعلام. تُعد BERT، التي طورتها Google AI Language في عام 2018، بمثابة أساس لحل أكثر من 11 مهمة من أكثر مهام البرمجة اللغوية العصبية شيوعًا بما في ذلك تحليل المشاعر والتعرف على الكيانات المسماة.
المنهجية ثنائية الاتجاه مهمة. يقوم BERT بتحليل السياق من كلا الاتجاهين حول كل كلمة، على غرار الطريقة التي يملأ بها البشر الفراغات في الجمل من خلال قراءة النص المحيط. وفقًا لوثائق Hugging Face، يُقدّم DistilBERT إصدارًا أخف وزنًا يعمل بسرعة 601 تيرابايت 3 تيرابايت مع الحفاظ على أكثر من 951 تيرابايت 3 تيرابايت من أداء BERT.
تطبق محركات البحث هذه النماذج على كل من الاستعلامات والمحتوى. فهي تستخرج الكيانات، وتفهم العلاقات، وتقيّم ما إذا كان المحتوى يغطي موضوعاً ما بشكل شامل.
سبب قصور البحث التقليدي عن الكلمات المفتاحية
كان تحسين كثافة الكلمات المفتاحية منطقيًا عندما كانت الخوارزميات تحسب تكرار الكلمات. ليس بعد الآن.
حديث حقيقي: إن حشو الكلمات المفتاحية المستهدفة في جميع أنحاء المحتوى يضر بالترتيب بشكل فعال الآن. تكتشف خوارزميات البحث أنماط اللغة غير الطبيعية. فهي تعطي الأولوية للمحتوى الذي يغطي الحقول الدلالية بشكل طبيعي.
يحدد النهج الدلالي مجموعات المفاهيم. بالنسبة لموضوع مثل “التعلم الآلي”، تتضمن المصطلحات ذات الصلة الشبكات العصبية وبيانات التدريب والخوارزميات والتحقق من صحة النموذج. تستخرج أدوات Python NLP هذه العلاقات تلقائيًا.
استخدام البرمجة اللغوية العصبية لتحسين محركات البحث
يعد استخدام Python في البرمجة اللغوية العصبية وتحسين محركات البحث الدلالي جزءًا واحدًا فقط من استراتيجية أوسع نطاقًا، و لينغريو يساعد على دمج هذه التقنيات في أطر عمل كاملة لتحسين محركات البحث التي تحقق النتائج. يعتمد النجاح على مدى تطابق المحتوى مع هدف البحث.
- تجميع الكلمات الرئيسية وتخطيط المقاصد
- تحسين المحتوى الدلالي
- أطر عمل تحسين محركات البحث القابلة للتطوير
إذا كنت تريد تحويل البيانات إلى تصنيفات, اتصل ب LENGREO للبدء.
مكتبات بايثون الأساسية للبرمجة اللغوية العصبية وتحسين محركات البحث الدلالي
تهيمن ثلاث منظومات مكتبات على البرمجة اللغوية العصبية للبايثون: NLTK للمهام التأسيسية، و spaCy لخطوط الإنتاج، و Hugging Face Transformers للنماذج الحديثة.
يخدم كل منها حالات استخدام مختلفة. يعتمد اختيار الأداة المناسبة على احتياجات التحليل المحددة.
NLTK: الأساس
توفر مجموعة أدوات اللغة الطبيعية وصولاً شاملاً للخوارزميات اللغوية. وهي مصممة لتعلّم مفاهيم البرمجة اللغوية العصبية وحلول النماذج الأولية.
يتطلب التثبيت أمر واحد فقط:
تثبيت nltk
تتفوق NLTK في المعالجة المسبقة للنصوص، والترميز، والتحليل اللغوي الأساسي. يبدأ منحنى التعلُّم بلطف، مما يجعلها في متناول المبتدئين في مجال البرمجة اللغوية العصبية. ومع ذلك، فإن سرعة المعالجة تتخلف عن البدائل الحديثة.
تشمل أفضل التطبيقات لتحسين محركات البحث تنظيف النصوص وإزالة الكلمات المتوقفة وتحليل التردد الأساسي. تجعل الوثائق الشاملة والموارد التعليمية من NLTK مثالية لفهم أساسيات البرمجة اللغوية العصبية قبل الانتقال إلى أدوات الإنتاج.
سباسي المعالجة الجاهزة للإنتاج
وفقًا للوثائق الرسمية ل spaCy، فإن spaCy هي مكتبة مجانية مفتوحة المصدر لمعالجة اللغات الطبيعية المتقدمة في بايثون. وهي مصممة لتطبيقات العالم الحقيقي حيث يكون الأداء مهمًا.
يتبع التثبيت عملية من خطوتين:
تثبيت سبايسي
python -m spacy تنزيل en_core_web_sm
تعطي البنية الأولوية للسرعة. مثل العديد من مكتبات البرمجة اللغوية العصبية، تقوم spaCy بترميز جميع السلاسل إلى قيم تجزئة، مما يقلل من استخدام الذاكرة ويحسن الكفاءة. للحصول على تمثيلات سلسلة قابلة للقراءة للسمات، أضف شرطة سفلية إلى اسم السمة.
تؤدي معالجة مستند إلى إنشاء كائن مستند يحتوي على رموز وكيانات وعلاقات نحوية:
استيراد سبايسي
nlp = spacy.load(‘en_core_web_sm’)
النص = ‘اشترت مايكروسوفت أكتيفيجن مقابل $68.7 مليار في 18 يناير’
doc = nlp(نص)
بالنسبة إلى ent في doc.ents:
طباعة(ent.text، ent.label_)
يحدد هذا النص البرمجي “Microsoft” و“Activision” كمؤسسات، و“$P68.7 مليار” كمؤسسة، و“18 يناير” كتاريخ. أبلغ المسوقون الذين يستخدمون spaCy في Python عن دورات تحسين المحتوى بشكل أسرع 25-35% من خلال إنشاء مرادفات آلية وتحليل المجال الدلالي.
محولات تعانق الوجه: أحدث الموديلات
توفر مكتبة Transformers إمكانية الوصول إلى نماذج مُدرَّبة مسبقًا مثل BERT وGPT والمتغيرات المتخصصة. تفهم هذه النماذج السياق على مستويات لا يمكن للخوارزميات التقليدية أن تتطابق معها.
التركيب:
محولات تثبيت الأنابيب
تتفوق نماذج المحولات في فهم مقاصد البحث، وتوليد عبارات متشابهة دلاليًا، وتحليل عمق المحتوى. تعمل المتطلبات الحسابية أعلى من spaCy، لكن جودة الفهم الدلالي تبرر تكلفة التحليلات الهامة.
بالنسبة لتطبيقات البحث الدلالي، تلتقط التضمينات القائمة على المحولات المعنى بشكل أكثر فعالية من ناقلات الكلمات التقليدية. وهذا يتيح تحليل أفضل لفجوة المحتوى ومطابقة المعنى.
| المكتبة | التركيب | الأفضل لـ | منحنى التعلم | تطبيقات تحسين محركات البحث |
|---|---|---|---|---|
| NLTK | تثبيت nltk | أساسيات التعلم | مناسب للمبتدئين | المعالجة المسبقة للنصوص، تحليل التردد |
| سباسي | تثبيت سبايسي | خطوط أنابيب الإنتاج | معتدل | استخراج الكيان، تحليل التبعية، تحليل التبعيات |
| المحولات | محولات تثبيت الأنابيب | الدلالات المتقدمة | متقدم | تحليل المقاصد، التشابه الدلالي |
التعرف على الكيانات المسماة لتحسين المحتوى
يحدد التعرف على الكيانات المسماة (NER) الكيانات المذكورة في النص ويصنفها. تستخدم محركات البحث تقنيات مماثلة لفهم ما يناقشه المحتوى.
تشمل الكيانات الأشخاص والمؤسسات والمواقع والتواريخ والمنتجات وغيرها. تشير التغطية الشاملة للكيانات إلى سلطة موضوعية.
استخراج الكيانات باستخدام spaCy
تحدد نماذج spaCy المدربة مسبقاً الكيانات خارج الصندوق. لا تستغرق العملية سوى بضعة أسطر من التعليمات البرمجية:
استيراد سبايسي
من سبايسي استيراد الإزاحة
nlp = spacy.load(‘en_core_web_sm’)
النص = ‘أعلنت Apple عن iPhone 15 في كوبرتينو في 12 سبتمبر 2023’
doc = nlp(نص)
بالنسبة إلى ent في doc.ents:
طباعة(و'{ent.text}: {ent.label_}’)
وهذا يحدد شركة Apple كمؤسسة، وiPhone 15 كمنتج، وKupertino كموقع، والتاريخ. ويكشف تحليل محتوى المنافسين عن الكيانات التي يغطونها والفجوات الموجودة.
بناء خرائط تغطية الكيانات
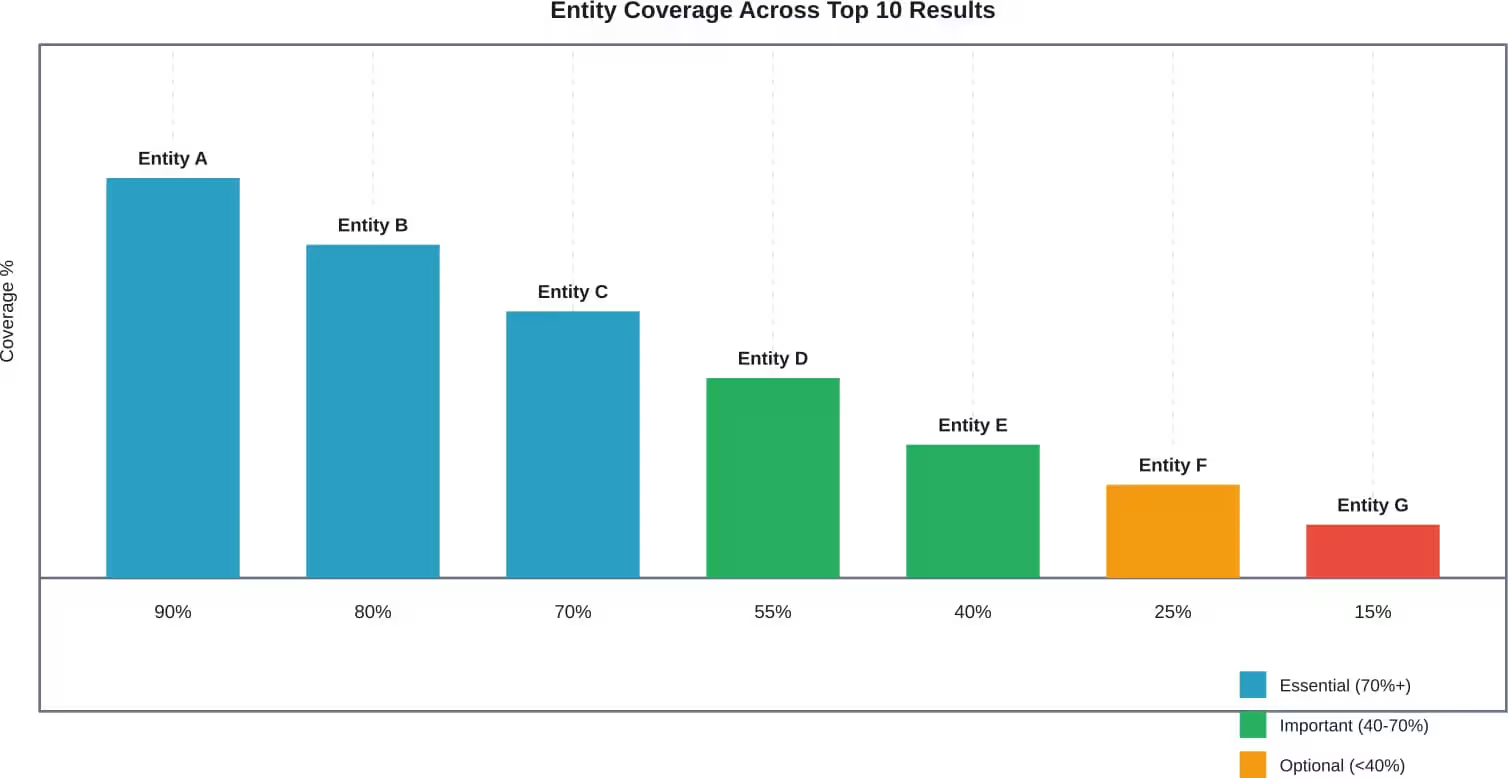
تتطلب السلطة الموضعية ذكر الكيانات ذات الصلة بشكل طبيعي. يمكن لبرامج Python النصية تحليل الصفحات ذات الترتيب الأعلى واستخراج أنماط تكرار الكيانات.
يعمل النهج على النحو التالي: كشط أعلى 10 نتائج لاستعلام مستهدف، واستخراج الكيانات من كل منها، وحساب تكرار الكيانات عبر النتائج، وتحديد الكيانات الموجودة في 70%+ من أعلى النتائج.
تمثل الكيانات التي تظهر في معظم النتائج العليا التغطية الموضعية المتوقعة. من المحتمل أن يبدو المحتوى الذي يفتقد هذه الكيانات غير مكتمل لخوارزميات البحث. إن إضافتها بشكل طبيعي - دون إجبار الإشارات - يعزز الصلة الدلالية.
تجميع الكلمات الرئيسية الدلالية مع بايثون
يقوم تجميع الكلمات المفتاحية بتجميع مصطلحات البحث ذات الصلة بناءً على التشابه الدلالي بدلاً من مجرد تداخل الكلمات. يكشف هذا عن كيفية تفكير الباحثين في الموضوعات وكيفية تنظيم المحتوى.
ينظر التجميع التقليدي إلى الكلمات المشتركة. أما التجميع الدلالي فيحلل المعنى. لا تحتوي عبارة “أفضل الهواتف الذكية” و “أفضل الهواتف المحمولة” على كلمات مشتركة ولكنها تعبر عن نفس المعنى.
التجميع القائم على TF-IDF
يقيس تردد المصطلح-تكرار المستند العكسي أهمية الكلمات عبر المستندات. الكلمات التي تظهر بشكل متكرر في مستند واحد ولكن نادراً ما تظهر في مستندات أخرى تسجل درجات عالية.
تعمل هذه التقنية لتجميع الكلمات المفتاحية الأولية:
من sklearn.feature_extraction.text استيراد TfidfVectorizer
من sklearn.cluster.cluster استيراد KMeans
الكلمات المفتاحية = [‘البرنامج التعليمي للبايثون’، ‘تعلم البايثون’، ‘دليل البايثون,
‘أساسيات التعلم الآلي’، ‘مقدمة في التعلم الآلي’، ‘البدء في التعلم الآلي’]
المتجه = TfidfVectorizer()
X = Vectorizer.fit_transform(الكلمات الرئيسية)
kmeans = KMeans(n_clusters=2)
kmeans.fit(X)
طباعة(kmeans.labels_)
يقوم هذا بتجميع الكلمات الرئيسية في مجموعات. يتم تجميع الكلمات المفتاحية الثلاث الأولى معًا (تعلُّم لغة بايثون)، بينما يتم تجميع الكلمات المفتاحية الثلاث الأخيرة بشكل منفصل (مقدمة التعلم الآلي).
التجميع الدلالي المتقدم مع التضمينات
تلتقط التضمينات القائمة على المحولات التشابه الدلالي بشكل أكثر دقة. فهي تفهم أن كلمة “سيارة” و“سيارة” تعني الشيء نفسه على الرغم من اختلاف الأحرف.
تعمل مكتبة محولات الجمل على تبسيط ذلك:
من محولات الجملة_التحويلات استيراد محول الجملة
من sklearn.cluster.cluster استيراد AgglomerativeClustering
الطراز = محول الجملة(‘all-MiniLM-L6-v2’)
الكلمات المفتاحية = [‘أفضل الحواسيب المحمولة لعام 2026’، ‘أفضل الحواسيب المحمولة هذا العام,
‘دليل شراء كمبيوتر محمول’، ‘كيفية اختيار جهاز كمبيوتر’]
التضمينات = model.encode.encode(keywords)
التجميع = AgglomerativeClustering(n_clusters=2)
التسميات = clustering.fit_predict(embeddings)
تعمل هذه الطريقة على تجميع الاستعلامات المتشابهة دلاليًا حتى عندما تستخدم صياغة مختلفة تمامًا. يتم تجميع استعلامات مقارنة المنتجات بشكل منفصل عن الأدلة الإرشادية.
بناء مراكز المحتوى من المجموعات
بمجرد تجميع الكلمات الرئيسية بشكل دلالي، قم بتنظيم المحتوى وفقًا لذلك. تصبح كل مجموعة محورًا للمحتوى مع صفحة أساسية ومقالات داعمة.
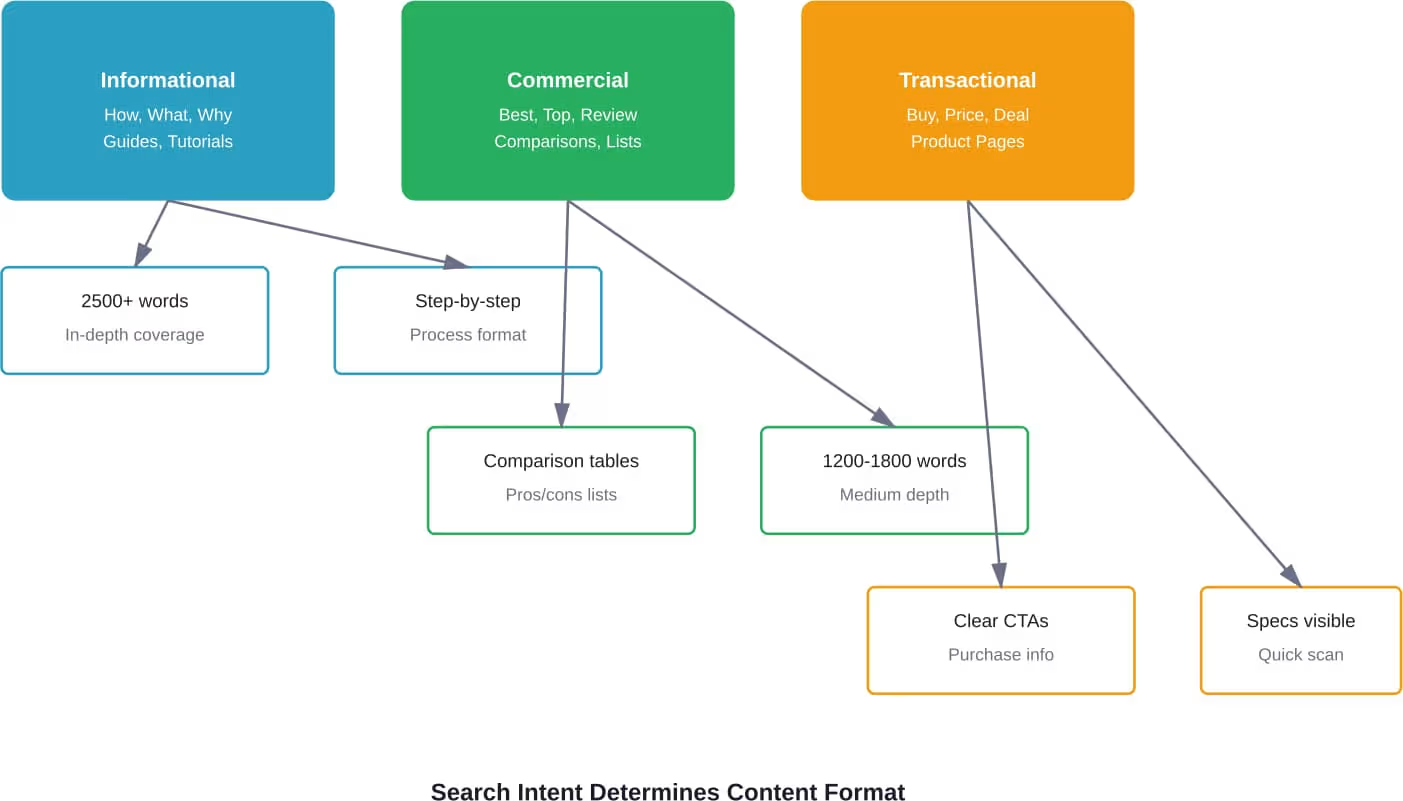
تكشف المجموعات عن أنماط نوايا البحث. تتجمع الاستعلامات المعلوماتية معًا. تشكل مصطلحات المقاصد التجارية مجموعات منفصلة. يُعلم ذلك اختيار نوع المحتوى وبنية الربط الداخلي.
تحليل نية البحث باستخدام البرمجة اللغوية العصبية
يحدد هدف البحث نوع المحتوى الذي يلبي الاستعلام. تصنّف أدوات معالجة اللغات الطبيعية للبايثون القصد تلقائيًا من خلال تحليل أنماط الاستعلام والمحتوى الأعلى تصنيفًا.
توجد أربعة أنواع أساسية من النوايا: المعلوماتية (التعلّم)، والملاحية (البحث عن مواقع محددة)، والتجارية (البحث عن المنتجات)، والمعاملات (الاستعداد للشراء).
تصنيف النوايا من خلال تحليل الاستعلام
تكشف بنية الاستعلام عن القصد. تشير الأسئلة التي تبدأ ب “كيف” أو “ماذا” أو “لماذا” إلى القصد الإعلامي. تشير العبارات التي تحتوي على “الأفضل” أو “الأفضل” أو “مراجعة” إلى القصد البحثي التجاري.
يستخدم المصنف البسيط مطابقة الأنماط:
إعادة الاستيراد
تعريف تصنيف_القصد(استعلام):
استعلام_أسفل = query.lower()
الأنماط_المعلوماتية = [r’^كيف’، r’^ماذا’، r’^لماذا’، r’^لماذا’، r’^متى’، r'دليل'، r'دليل'، r'برنامج تعليمي']
الأنماط_التجارية = [r'best’, r'top’, r'review’, r'compare’, r'vs’]
أنماط_المعاملات = [r'buy’, r'buy’, r'price’, r'cheap’, r'deal’]
للنمط في أنماط_المعاملات:
إذا كان re.search(pattern, query_lower):
إرجاع ‘المعاملات’
للنمط في الأنماط_التجارية:
إذا كان re.search(pattern, query_lower):
إرجاع ‘تجاري’
للنمط في الأنماط_المعلوماتية:
إذا كان re.search(pattern, query_lower):
إرجاع ‘معلومات’
إرجاع ‘ملاحي’
طباعة(classify_intent(‘كيف تتعلم بايثون’)) # إعلامي
طباعة(classify_intent(‘أفضل دورات بيثون’)) # التجارية
تحليل محتوى سيرب للتحقق من صحة النوايا
تتحقق أنواع المحتوى الأعلى ترتيبًا من صحة تصنيف القصد. إذا كانت جميع النتائج العليا عبارة عن قوائم، فإن الاستعلام يتوقع محتوى المقارنة. إذا كانت الدروس التعليمية هي المسيطرة، فإن المحتوى التعليمي هو الأفضل أداءً.
يستخلص التحليل الآلي لسيرب الأنماط:
- عد علامات الاستفهام في العناوين (محتوى على غرار الأسئلة الشائعة)
- تحديد مؤشرات القائمة (خطوات مرقمة ونقاط مرقمة)
- الكشف عن إشارات المنتجات وأسعارها (المحتوى التجاري)
- قياس متوسط طول المحتوى (توقعات العمق)
تعمل مطابقة تنسيق المحتوى مع أنماط SERP السائدة على تحسين إمكانات الترتيب. لن يتم تصنيف برنامج تعليمي مفصّل لاستعلام يتوقع الباحثون فيه مقارنات سريعة بين المنتجات.
تحليل فجوة المحتوى باستخدام بايثون
تمثل فجوات المحتوى الموضوعات التي يغطيها المنافسون والتي يفتقدها موقعك. يؤدي تحديد هذه الثغرات وسدها إلى بناء سلطة موضوعية وجذب زيارات بحث إضافية.
يستغرق التحليل اليدوي للفجوات ساعات. يقوم برنامج Python بأتمتة العملية في دقائق.
كشط هياكل محتوى المنافسين
يكشف تحليل عناوين المنافسين عن تغطيتهم الموضوعية. يستخرج الحساء الجميل هياكل العناوين بكفاءة:
من bs4 bs4 استيراد الحساء الجميل
طلبات الاستيراد
عنوان url = ‘https://competitor.com/target-article’
الاستجابة = الطلبات.get(url)
الحساء = الحساء الجميل (محتوى الاستجابة، ‘html.parser’)
العناوين = []
بالنسبة للعنوان في soup.find_all([‘h2’، ‘h3’]):
headings.append(title.get_text().strip())
لـ h في العناوين
طباعة(ح)
قم بتشغيل هذا على العديد من الصفحات ذات الترتيب الأعلى. استخرج جميع عناوين H2 و H3. قارن مواضيعها بالمحتوى الموجود لديك.
العثور على التغطية الموضعية المفقودة
بمجرد جمع عناوين المنافسين، حدد الموضوعات الشائعة الغائبة عن المحتوى الخاص بك. تمثل الموضوعات التي تظهر في 60%+ من أهم النتائج ولكنها غائبة عن صفحاتك ثغرات واضحة.
يقوم البرنامج النصي لتحليل التكرار بحساب تكرار حدوث موضوع العنوان:
من المجموعات استيراد العداد
إعادة الاستيراد
جميع_عناوين_المنافسين = [
# العناوين من المنافس 1
[‘مقدمة’، ‘دليل الإعداد’، ‘التقنيات المتقدمة’، ‘الأخطاء الشائعة’],
# عناوين من المنافس 2
[‘الشروع في العمل’، ‘دليل الإعداد’، ‘استكشاف الأخطاء وإصلاحها’، ‘أفضل الممارسات’],
# العناوين من المنافس 3
[‘نظرة عامة’، ‘التثبيت’، ‘التقنيات المتقدمة’، ‘الأخطاء الشائعة’]
]
العناوين_المسطحة = [ح للقائمة الفرعية في كل_العناوين_المنافسة لـ ح في القائمة الفرعية]
العناوين_العناوين = عداد (العناوين_المسطحة)
بالنسبة للعنوان، العدد في head_counts.most_common():
النسبة المئوية = (العدد / العدد (all_competitor_headings)) * 100
طباعة(f'{عنوان}: {count} التكرارات ({النسبة المئوية:.0f}%)’)
يجب إضافة العناوين التي تظهر بشكل متكرر عبر المنافسين ولكنها مفقودة من المحتوى الخاص بك. وهذا لا يعني نسخ هيكلها - بل يعني ضمان تغطية شاملة للمواضيع الفرعية المتوقعة.
تحسين سهولة قراءة المحتوى وهيكله
تؤثر سهولة القراءة على كل من تفاعل المستخدم وتصنيفات البحث. تقيس أدوات بايثون سهولة القراءة بموضوعية وتحدد فرص التحسين.
تأخذ محركات البحث في الاعتبار وقت المكوث وإشارات المشاركة. يؤدي المحتوى الذي يصعب قراءته إلى إبعاد الزائرين بسرعة، مما يرسل إشارات سلبية للترتيب.
حساب درجات سهولة القراءة
تحسب مكتبة textstat مقاييس سهولة القراءة القياسية:
استيراد textstat
النص = ”’المحتوى الخاص بك يذهب هنا. يمكن أن يكون هذا مقالاً كاملاً
أو مجرد قسم تريد تحليله من أجل سهولة قراءته.”
flesch_reading_ease = textstat.flesch_reading_ease(text)
درجة_kincincaid_kincaid_grade = textstat.flesch_kincaid_grade_grade(text)
طباعة (f'Flesch Reading Ease: {flesch_reading_ease})
طباعة(و'مستوى الصف: {flesch_kincincaid_grade}’)
تشير درجات Flesch Ease للقراءة أعلى من 60 إلى محتوى يسهل الوصول إليه. تشير الدرجات الأقل من 30 إلى صعوبة القراءة التي قد تفقد الجمهور. يُظهر مستوى درجة فليش-كينكايد مستوى الصف الدراسي في الولايات المتحدة المطلوب لفهم النص.
بالنسبة لمعظم محتوى الويب، استهدف الصفوف من 8 إلى 10. قد تبرر المواضيع التقنية مستويات أعلى، ولكن حتى المواضيع المعقدة تستفيد من الكتابة الواضحة.
تحليل طول الجملة وتعقيدها
يؤثر متوسط طول الجملة على سهولة القراءة. الجمل الطويلة جدًا تتعب القراء. الجمل القصيرة جداً تبدو متقطعة.
يحلل spaCy بنية الجملة:
استيراد سبايسي
nlp = spacy.load(‘en_core_web_sm’)
النص = ”’نص مقالتك هنا”’.’
doc = nlp(نص)
أطوال_الجملة = [len(sent) ل sent في doc.sents]
متوسط_الطول_المتوسط = مجموع (أطوال_الجمل) / طول (أطوال_الجمل)
طباعة(f'متوسط طول الجملة: {متوسط الطول:.1f} كلمات’)
طباعة(f'أطول جملة: {الحد الأقصى (أطوال_الجمل)} الكلمات’))
طباعة(f'أقصر جملة: {min(طول_الجملة)} كلمات’))
استهدف أن يتراوح متوسط طول الجملة بين 15-20 كلمة. امزج بين الجمل الأقصر القوية والجمل التفصيلية الأطول. فالجمل التي تتجاوز 35-40 كلمة غالبًا ما تربك القراء ويجب تقسيمها.
بناء أدوات تحليل المحتوى المؤتمتة لتحسين محركات البحث SEO
يؤدي الجمع بين تقنيات البرمجة اللغوية العصبية في أدوات تحليل موحدة إلى أتمتة مهام التحسين المتكررة. يمكن لنص برمجي واحد استخراج الكيانات وتصنيف المقاصد وقياس قابلية القراءة وتحديد الثغرات.
إنشاء برنامج نصي لتدقيق المحتوى
نص تدقيق شامل يحلل المحتوى الموجود على نطاق واسع:
استيراد سبايسي
استيراد textstat
من المجموعات استيراد العداد
nlp = spacy.load(‘en_core_web_sm’)
تعريف تحليل_المحتوى (نص):
doc = nlp(نص)
# استخراج الكيانات
الكيانات = [(ent.text, ent.label_) لـ ent في doc.ents]
الكيانات_الكثافة = عداد([التسمية ل _، التسمية في الكيانات])
# سهولة القراءة #
سهولة القراءة = textstat.flesch_reading_ease(text)
التقدير_المستوى = textstat.flesch_kincincaid_grade(text)
# هيكل #
عدد_الجمل = len(list(doc.sents))
word_count = len([token for token in doc if not token.is_punct])
إرجاع {
‘عدد_الكلمات’: عدد_الكلمات,
‘عدد_الجمل’: عدد_الجمل,
‘Readability_score’: سهولة القراءة,
‘مستوى_التقدير’: مستوى_التقدير,
‘عدد_الكيانات’: dict(عدد_الكيانات),
‘unique_entities’: len(len(set([text for text, _ in entities]))
}
# الاستخدام على المحتوى
النتائج = تحليل_المحتوى(your_article_text)
طباعة (النتائج)
يوفر هذا مقاييس قابلة للتنفيذ: عدد الكلمات، وعدد الجمل، ودرجات سهولة القراءة، وتنوع الكيانات، وتوزيع أنواع الكيانات. قم بتشغيله عبر جميع محتويات الموقع لتحديد الصفحات ذات الأداء الضعيف.
لوحة معلومات مقارنة المنافسين
يكشف تحليل محتوى المنافسين إلى جانب المحتوى الخاص بك عن نقاط القوة والضعف النسبية. برنامج نصي للمقارنة يعالج عناوين URL متعددة:
طلبات الاستيراد
من bs4 bs4 استيراد الحساء الجميل
def scrape_and_analyze(url):
الاستجابة = الطلبات.get(url)
الحساء = الحساء الجميل (محتوى الاستجابة، ‘html.parser’)
# استخراج المحتوى الرئيسي (ضبط المحدد للمواقع المستهدفة)
المحتوى = soup.find.find(‘article’).get_text()
إرجاع تحليل_المحتوى(المحتوى)
المنافسين_المنافسين = [
‘https://competitor1.com/article’,
‘https://competitor2.com/article’
]
بالنسبة لـ url في URL في URL_urls_urls المنافس:
طباعة(f’\nتحليل: {url}’)
النتائج = scrape_and_analyze(url)
طباعة (و”الكلمات: {النتائج [‘عدد الكلمات’]}”)
طباعة(و”قابلية القراءة: {results[‘readability_score’]: .1f}”)
طباعة (و”الكيانات: {النتائج [‘كيانات_فريدة’]}”)
قارن مقاييسك بمتوسطات المنافسين. إذا كان متوسط كلمات المنافسين 2500 كلمة ومعدل كلماتك يحتوي على 1200 كلمة، فإن زيادة عمق المحتوى قد يحسن الترتيب. إذا كانوا يذكرون 25 كيانًا فريدًا بينما يغطي منافسيك 12 كيانًا، فإن زيادة اتساع نطاق المحتوى الموضعي قد يساعدك.
| متري | المحتوى الخاص بك | متوسط متوسط متوسط المنافسين | الإجراء المطلوب |
|---|---|---|---|
| عدد الكلمات | 1,850 | 2,600 | توسيع نطاق التغطية |
| درجة سهولة القراءة | 58 | 65 | تبسيط اللغة |
| الكيانات الفريدة | 14 | 22 | إضافة الكيانات ذات الصلة |
| متوسط طول الجملة | 24 كلمة | 18 كلمة | تقصير الجمل |
| العناوين (H2+H3) | 8 | 13 | تحسين الهيكل |
الاستفادة من المحولات للبحث الدلالي
أحدثت نماذج المحولات ثورة في الفهم الدلالي. فهي تعمل على تشغيل محركات البحث الحديثة وتمكّن تقنيات تحسين المحتوى المتقدمة.
وفقًا للأبحاث التي أجريت على البحث الدلالي، تتفوق المناهج القائمة على المحولات بشكل كبير على الأساليب المعجمية التقليدية في مهام استرجاع المعلومات.
توليد التضمينات الدلالية
تقوم التضمينات بتحويل النص إلى متجهات عددية تلتقط المعنى. تنتج النصوص المتشابهة دلاليًا متجهات متشابهة، حتى مع اختلاف الصياغة.
تقوم محولات الجمل بتوليد هذه التضمينات:
من محولات الجملة_التحويلات استيراد محول الجملة، الاستخدام
الطراز = محول الجملة(‘all-MiniLM-L6-v2’)
الجمل = [
‘بايثون لغة برمجة’,
‘تُستخدم بايثون في البرمجة’,
‘الثعابين من الزواحف’
]
التضمينات = model.encode.encode(sentences)
# احسب التشابه بين الجملة الأولى والجمل الأخرى
التشابه_1_2 = util.cos_sim(embeddings[0]، embeddings[1])
التشابه_1_3 = util.cos_sim(embeddings[0]، embeddings[2])
طباعة(f'تشابه (1-2): {similarity_1_2.item():.3f})’)
طباعة(f'تشابه (1-3): {similarity_1_3.item():.3f})’)
تُظهر الجملتان الأوليان تشابهًا عاليًا على الرغم من اختلاف الكلمات. أما الجملة الثالثة فتُظهر تشابهًا منخفضًا - أي أنها تُظهر تشابهًا دلاليًا مختلفًا.
العثور على محتوى مرتبط دلالياً
تحدد التضمينات المقالات ذات الصلة للربط الداخلي. قم بتحويل جميع مقالات الموقع إلى تضمينات، ثم ابحث عن المقالات ذات التشابه الدلالي العالي.
وهذا يكشف عن فرص الربط الطبيعية التي تعزز المجموعات الموضعية:
المقالات = [
{‘title’: ‘أساسيات بايثون’، ‘النص’: ‘مقدمة في برمجة بايثون...’},
{‘title’: ‘بايثون متقدم’، ‘النص’: ‘تقنيات بايثون المتقدمة...’},
{‘title’: ‘دليل جافا سكريبت’، ‘النص’: ‘تعلّم أساسيات جافا سكريبت...}
]
التضمينات = model.encode([a[‘text] ل a في المقالات])
# ابحث عن مقالات مشابهة للأولى
تضمين_هدف_التضمين = التضمينات [0]
أوجه التشابه = [util.cos_sim(target_embedding, emb).item() ل emb في التضمينات [1:]
ل i، sim في تعداد (أوجه التشابه، 1):
طباعة (و”{مقالات [i] [‘title’]}: {sim:.3f}”)
المقالات التي تزيد درجات التشابه فيها عن 0.6-0.7 تكون مرشحة قوية للارتباط الداخلي. يؤدي ذلك إلى بناء مجموعات محتوى دلالية تُظهر الخبرة الموضعية لمحركات البحث.
تحسين تحسين محركات البحث المحلية باستخدام البرمجة اللغوية العصبية
تتطلب عمليات البحث المستندة إلى الموقع تحسينًا دلاليًا محددًا. تستخرج البرمجة اللغوية العصبية للبايثون كيانات الموقع وتضمن السياق الجغرافي المناسب.
استخراج الكيانات الجغرافية
يحدد موقع spaCy إشارات الموقع تلقائياً:
استيراد سبايسي
nlp = spacy.load(‘en_core_web_sm’)
النص = ‘قم بزيارة مكاتبنا في سياتل وبورتلاند وسان فرانسيسكو’
doc = nlp(نص)
المواقع = [ent.text ل ent في doc.ents إذا كان ent.label_ == ‘GPE’]
طباعة (و'المواقع المذكورة: {المواقع}’)
GPE (الكيان الجغرافي السياسي) يلتقط المدن والولايات والبلدان. FAC يلتقط المنشآت والمباني.
بالنسبة لتحسين محركات البحث المحلية، تأكد من ظهور كيانات الموقع بشكل طبيعي في جميع أنحاء المحتوى. يجب أن تذكر صفحات الخدمة المدن والأحياء والمعالم الإقليمية المخدومة.
تحليل نوايا البحث المحلي
غالبًا ما تتضمن الاستعلامات المحلية قصد الموقع الجغرافي الضمني دون كلمات صريحة عن الموقع الجغرافي. “المقاهي” تعني “المقاهي القريبة مني”.”
يكشف تحليل SERPs لطلبات البحث عن الاستعلامات عن وقت تطبيق محركات البحث للقصد المحلي:
- تشير حزم الخرائط في النتائج إلى النية المحلية
- قوائم الأعمال التجارية تهيمن على التصنيفات
- تختلف النتائج حسب موقع الباحث
يحتاج المحتوى الذي يستهدف هذه الاستعلامات إلى إشارات محلية قوية: إشارات العناوين، وأوصاف منطقة الخدمة، والكيانات ذات الصلة محليًا.
مراقبة التصنيفات الدلالية والأداء الدلالي
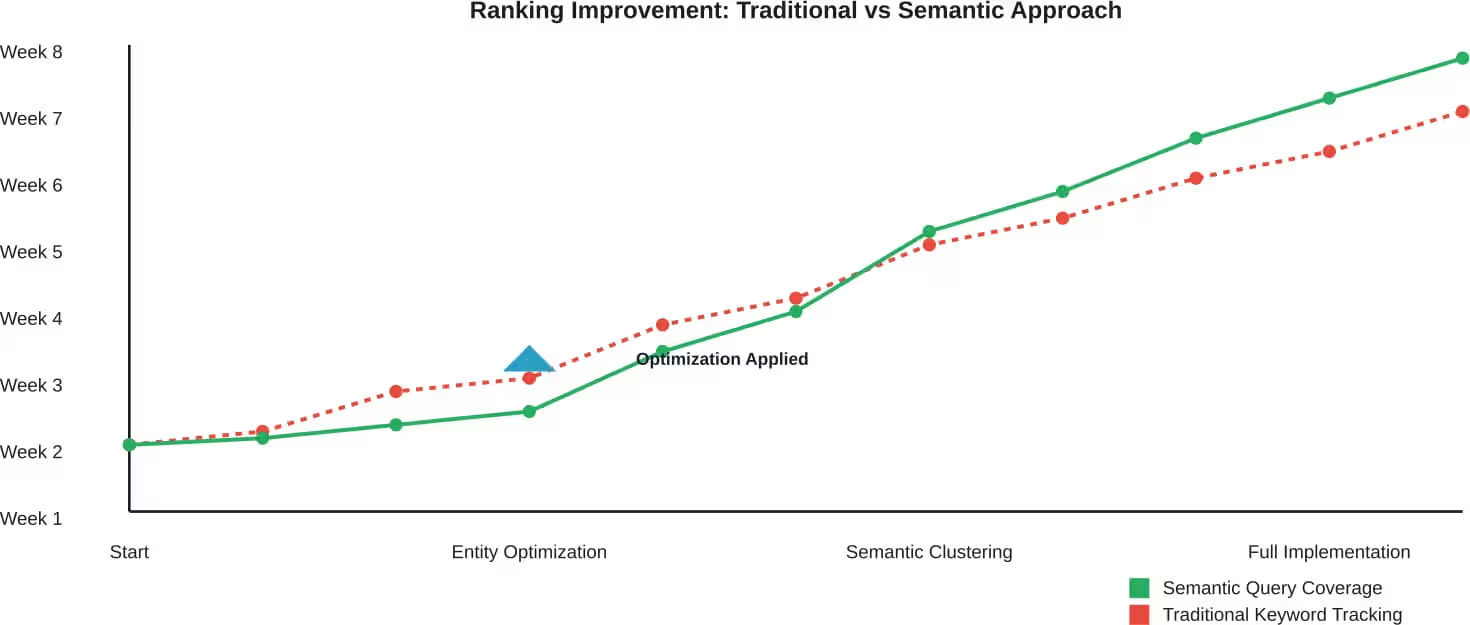
يتطلب تتبع نجاح تحسين محركات البحث الدلالية مقاييس مختلفة عن تتبع الكلمات المفتاحية التقليدية. راقب إشارات السلطة الموضوعية، وظهور الكيان، ونمو حركة المرور الدلالية.
تتبع الرتب المستند إلى الكيان
بدلًا من تتبع الكلمات المفتاحية الفردية، راقب مدى جودة ترتيب المحتوى للاستعلامات المتعلقة بالكيان. في حالة استهداف كيان “برمجة بايثون”، تتبّع تصنيفات الكيانات:
- استعلامات الكيانات الأساسية (“برمجة بايثون”)
- استعلامات الكيانات ذات الصلة (“دروس بايثون التعليمية”، “مكتبات بايثون”)
- اختلافات دلالات الذيل الطويل
يؤدي الارتباط المحسّن بين الكيانات إلى زيادة عدد الزيارات عبر العديد من الاستعلامات ذات الصلة، وليس فقط الكلمات المفتاحية المستهدفة.
تحليل أداء المحتوى
قارن مقاييس المحتوى قبل التحسين الدلالي وبعده:
- متوسط الوقت على الصفحة (تحسين المشاركة)
- الصفحات لكل جلسة (فعالية الارتباط الداخلي)
- معدل الارتداد (مطابقة الصلة)
- الانطباعات الخاصة بالاستعلامات ذات الصلة (توسيع نطاق السلطة الموضعية)
عادةً ما يؤدي التحسين الدلالي إلى زيادة عدد الزيارات - أي عدد الاستفسارات المختلفة التي تؤدي إلى الزيارات - بدلاً من مجرد زيادة الحجم.
مهام سير عمل تحسين محركات البحث الشائعة في البرمجة اللغوية العصبية للغة بايثون
يجمع التنفيذ الفعال بين تقنيات متعددة في عمليات سير عمل قابلة للتكرار. تعمل هذه العمليات على تحويل البرامج النصية المعزولة إلى أساليب تحسين منهجية.
سير عمل إنشاء المحتوى الجديد
قبل كتابة محتوى جديد:
- كشط أعلى 10 صفحات مرتبة في الترتيب بالنسبة للاستعلام المستهدف
- استخراج الكيانات من جميع الصفحات باستخدام spaCy
- تحديد الكيانات المشتركة (وجود 70%+)
- تجميع الكلمات الرئيسية ذات الصلة دلالياً
- تحليل بنية محتوى سيرب (العناوين، التنسيق)
- تحديد هدف البحث السائد
- حساب متوسط طول المحتوى وسهولة القراءة
أنشئ محتوى يطابق توقعات التنسيق، ويغطي الكيانات المتوقعة، ويعالج القصد المحدد. يقلل هذا النهج القائم على البيانات من التخمين.
سير عمل تحسين المحتوى الحالي
بالنسبة للمحتوى الحالي الضعيف الأداء:
- إجراء تحليل سهولة القراءة (تحديد الجمل المراد تبسيطها)
- استخراج تغطية الكيان الحالي
- مقارنة بتغطية الكيانات المنافسة
- تحديد الكيانات المفقودة من أعلى النتائج
- التحقق من التشابه الدلالي للمحتوى الأعلى تصنيفًا
- البحث عن فرص الربط الداخلي عبر التضمينات
- تحديث المحتوى مع سد الثغرات
يضمن هذا النهج المنهجي أن يعالج التحسين أوجه القصور الفعلية بدلاً من إجراء تغييرات عشوائية.
أفضل ممارسات واعتبارات التنفيذ
يتطلب التطبيق الناجح لبرمجة اللغة الطبيعية للبايثون تحقيق التوازن بين الأتمتة والحكم التحريري. توفر البرامج النصية رؤى تعتمد على البيانات، لكن جودة المحتوى تعتمد في النهاية على الخبرة البشرية.
مسائل جودة البيانات
تعتمد جودة التحليل الآلي بالكامل على جودة البيانات المدخلة. يتطلب كشط محتوى المنافسين استخراج المحتوى بدقة - باستثناء التنقل والإعلانات والتذييلات. تقوم العديد من المواقع ببناء المحتوى بشكل مختلف، مما يتطلب منطق استخراج مخصص.
اختبر البرامج النصية على عينات صغيرة قبل تشغيلها على نطاق واسع. تحقق من دقة استخراج الكيانات يدوياً. تحقق من أن حسابات سهولة القراءة تعكس صعوبة القراءة الفعلية. بيانات الإدخال السيئة تنتج تحليلاً مضللاً.
لا تبالغ في التقدير
تكشف أدوات البرمجة اللغوية العصبية عن فرص التحسين، ولكن حشر كل كيان تم تحديده في المحتوى يخلق كتابة غير طبيعية. إعطاء الأولوية للكيانات والمواضيع الأكثر صلة. لا يتطلب ملء كل فجوة دلالية.
تكتشف محركات البحث أنماط التحسين المفرط. يؤدي المحتوى المحشو بالكيانات لأغراض التلاعب أداءً ضعيفًا. التغطية الطبيعية للمفاهيم ذات الصلة الحقيقية تعمل بشكل أفضل من الإشارات القسرية.
الجمع بين التحليل الآلي والحكم البشري
تحدد نصوص بايثون المواضيع التي يغطيها المتنافسون والكيانات التي يذكرونها. ويحدد المحررون البشريون كيفية تناول تلك الموضوعات بشكل طبيعي وما إذا كانت مهمة بالفعل للجمهور المستهدف.
توفر درجات سهولة القراءة الآلية إرشادات، لكن السياق مهم. يستخدم المحتوى التقني للجمهور المتخصص لغة معقدة بشكل مشروع. التبسيط ليس مناسبًا دائمًا.
تحديث النماذج باستمرار
يتم تحديث مكتبات ونماذج البرمجة اللغوية العصبية بشكل متكرر، حيث تُصدر spaCy إصدارات جديدة بدقة محسّنة. تضيف المحولات نماذج جديدة مدربة مسبقًا بانتظام. يضمن تحديث التبعيات بشكل دوري الوصول إلى التحسينات.
قد تغير تحديثات النموذج المخرجات قليلاً. اختبر الإصدارات المحدثة قبل نشرها على عمليات سير عمل الإنتاج لفهم أي تغييرات سلوكية.
المضي قدمًا مع البرمجة اللغوية العصبية للغة بايثون لتحسين محركات البحث
يستمر تطور الويب الدلالي في التطور. تزداد خوارزميات البحث تطوراً في فهم السياق وتقييم الخبرات. وتوفر أدوات معالجة اللغات الطبيعية للبايثون القدرات التحليلية اللازمة لمواكبة ذلك.
ابدأ بالتطبيقات البسيطة. استخرج الكيانات من المحتوى الأعلى تصنيفًا. احسب قابلية القراءة للصفحات الموجودة. قم بالبناء من هناك مع تزايد الراحة مع الأدوات.
تأتي الميزة التنافسية من التطبيق المتسق وليس من النصوص المثالية. فالمواقع التي تطبق التحليل الدلالي بشكل منهجي على تخطيط المحتوى وتحسينه تضاعف المزايا بمرور الوقت.
تكافئ محركات البحث المحتوى الشامل والمنظم بشكل جيد والذي يوضح الخبرة الموضعية. تعمل البرمجة اللغوية العصبية للبايثون على أتمتة العثور على التغطية الشاملة لأي موضوع. الباقي هو التنفيذ.
لا يتطلب التنفيذ فرق علم البيانات أو بنية تحتية معقدة. تعمل المكتبات التي تمت مناقشتها على أي جهاز كمبيوتر. يمكن لبضع مئات من الأسطر من كود بايثون تحويل سير عمل المحتوى.
لقد أصبح المستقبل الدلالي للبحث هنا بالفعل. الأدوات التي كانت تبدو متطورة منذ بضع سنوات مضت أصبحت الآن من أساسيات البحث. فالمواقع التي تتقن هذه التقنيات تُنشئ سلطة موضعية لا يمكن أن تضاهيها أساليب الكلمات المفتاحية التقليدية.
ابدأ في بناء مجموعة أدوات البرمجة اللغوية العصبية للبايثون اليوم. استخرج تلك الكيانات. قم بتجميع تلك الكلمات المفتاحية. حلل بنية المحتوى تلك. ستظهر لك البيانات بالضبط كيف تبدو التغطية الموضعية الشاملة.









