


Kurze Zusammenfassung: Python ermöglicht fortschrittliche NLP-Analysen für semantische SEO durch Bibliotheken wie spaCy, NLTK und Hugging Face Transformers. Diese Tools extrahieren Entitäten, analysieren Suchintentionen, clustern Keywords semantisch und optimieren Inhalte auf thematische Relevanz über das traditionelle Keyword-Matching hinaus. Die Automatisierung dieser Aufgaben mit Python-Skripten hilft Websites, thematische Autorität und bessere Platzierungen in modernen Suchalgorithmen zu erreichen.
Suchmaschinen haben sich schon vor Jahren über die einfache Suche nach Schlüsselwörtern hinaus entwickelt. Sie analysieren jetzt die Bedeutung, verstehen den Kontext und bewerten die thematische Tiefe. Traditionelle SEO-Taktiken reichen nicht mehr aus.
Python hat alles für die Optimierung von Inhalten verändert. Bibliotheken zur Verarbeitung natürlicher Sprache entschlüsseln, wie Suchalgorithmen die Semantik von Inhalten interpretieren. Und die Einstiegshürde? Niedriger als die meisten Leute denken.
Die intelligente Verarbeitung von Rohtext erfordert mehr als nur den Abgleich von Mustern. Wörter, die unterschiedlich aussehen, bedeuten oft ähnliche Dinge. Die gleichen Wörter in unterschiedlicher Reihenfolge vermitteln völlig unterschiedliche Bedeutungen. Laut der spaCy-Dokumentation können diese Probleme nur dann effektiv gelöst werden, wenn die Analyse von Rohzeichen durch linguistisches Wissen ergänzt wird.
In diesem Leitfaden wird genau beschrieben, wie Python-NLP-Bibliotheken semantische SEO-Workflows verändern. Keine Floskeln, keine erfundenen Statistiken. Nur praktische Implementierungsstrategien, die durch echte Bibliotheksdokumentation unterstützt werden.
Verständnis von NLP und semantischen SEO-Grundlagen
Bei der Verarbeitung natürlicher Sprache lernen Maschinen, die menschliche Sprache zu verstehen. Semantische SEO nutzt dieses Verständnis, um Inhalte zu erstellen, die der Suchabsicht und den thematischen Erwartungen entsprechen.
Die Sache ist jedoch die: Suchmaschinen suchen nicht mehr nur nach Schlüsselwörtern. Sie analysieren Entitäten, Beziehungen und den Kontext. Eine Seite über “Python-Programmierung” sollte natürlich verwandte Konzepte wie Variablen, Funktionen und Bibliotheken behandeln. Wenn diese semantischen Zusammenhänge fehlen, bedeutet das eine unvollständige Abdeckung.
Wie Suchmaschinen Sprache semantisch verarbeiten
Moderne Suchalgorithmen verwenden Transformer-Modelle, um die Bedeutung von Anfragen zu verstehen. BERT, das 2018 von Google AI Language entwickelt wurde, dient als Grundlage für die Lösung von mehr als 11 der gängigsten NLP-Aufgaben, darunter Sentimentanalyse und Named Entity Recognition.
Die bidirektionale Methodik ist wichtig. BERT analysiert den Kontext aus beiden Richtungen um jedes Wort herum, ähnlich wie Menschen Lücken in Sätzen füllen, indem sie den umgebenden Text lesen. Laut der Dokumentation von Hugging Face bietet DistilBERT eine abgespeckte Version, die 60% schneller läuft und dabei über 95% der Leistung von BERT beibehält.
Suchmaschinen wenden diese Modelle sowohl auf Suchanfragen als auch auf Inhalte an. Sie extrahieren Entitäten, verstehen Beziehungen und bewerten, ob der Inhalt ein Thema umfassend abdeckt.
Warum traditionelle Keyword-Recherche zu kurz greift
Die Optimierung der Schlüsselwortdichte war sinnvoll, als Algorithmen noch die Worthäufigkeit zählten. Jetzt nicht mehr.
Hand aufs Herz: Das Einstreuen von Schlüsselwörtern in den Inhalt schadet jetzt aktiv der Platzierung. Die Suchalgorithmen erkennen unnatürliche Sprachmuster. Sie bevorzugen Inhalte, die semantische Felder auf natürliche Weise abdecken.
Ein semantischer Ansatz identifiziert Begriffscluster. Zu einem Thema wie “maschinelles Lernen” gehören verwandte Begriffe wie neuronale Netze, Trainingsdaten, Algorithmen und Modellvalidierung. NLP-Tools in Python extrahieren diese Beziehungen automatisch.
NLP für bessere SEO nutzen
Die Verwendung von Python für NLP und semantische SEO ist nur ein Teil einer umfassenderen Strategie, und LENGREO hilft dabei, diese Techniken in vollständige SEO-Rahmenwerke zu integrieren, die zu Ergebnissen führen. Der Erfolg hängt davon ab, wie gut die Inhalte der Suchabsicht entsprechen.
- Schlüsselwort-Clustering und Intent Mapping
- Optimierung des semantischen Inhalts
- skalierbare SEO-Frameworks
Wenn Sie Daten in Rankings umwandeln wollen, Kontakt zu LENGREO um loszulegen.
Unverzichtbare Python-Bibliotheken für NLP und semantisches SEO
Drei Bibliotheks-Ökosysteme dominieren Python NLP: NLTK für grundlegende Aufgaben, spaCy für Produktionspipelines und Hugging Face Transformers für modernste Modelle.
Jedes dieser Werkzeuge dient unterschiedlichen Zwecken. Die Wahl des richtigen Tools hängt von den spezifischen Analyseanforderungen ab.
NLTK: Das Fundament
Das Natural Language Toolkit bietet einen umfassenden Zugang zu linguistischen Algorithmen. Es ist für das Erlernen von NLP-Konzepten und das Prototyping von Lösungen konzipiert.
Die Installation erfordert einen einzigen Befehl:
pip install nltk
NLTK eignet sich hervorragend für die Textvorverarbeitung, Tokenisierung und grundlegende linguistische Analysen. Die Lernkurve beginnt sanft und macht es auch für NLP-Neulinge zugänglich. Die Verarbeitungsgeschwindigkeit bleibt jedoch hinter modernen Alternativen zurück.
Zu den besten Anwendungen für die Suchmaschinenoptimierung gehören die Textbereinigung, das Entfernen von Stoppwörtern und grundlegende Frequenzanalysen. Die ausführliche Dokumentation und die Bildungsressourcen machen NLTK zum idealen Werkzeug, um die NLP-Grundlagen zu verstehen, bevor man zu Produktionswerkzeugen übergeht.
spaCy: Produktionsreife Verarbeitung
Laut der offiziellen spaCy-Dokumentation ist spaCy eine freie, quelloffene Bibliothek für fortgeschrittene natürliche Sprachverarbeitung in Python. Sie wurde für reale Anwendungen entwickelt, bei denen es auf Leistung ankommt.
Die Installation erfolgt in zwei Schritten:
pip install spacy
python -m spacy herunterladen en_core_web_sm
Bei der Architektur steht die Geschwindigkeit im Vordergrund. Wie viele NLP-Bibliotheken kodiert spaCy alle Zeichenketten in Hash-Werte, was die Speichernutzung reduziert und die Effizienz erhöht. Um lesbare String-Darstellungen von Attributen zu erhalten, fügen Sie einen Unterstrich an den Attributnamen an.
Bei der Verarbeitung eines Dokuments wird ein Doc-Objekt erstellt, das Token, Entitäten und syntaktische Beziehungen enthält:
Importspatzen
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Microsoft hat Activision am 18. Januar für $68,7 Milliarden gekauft’.’
doc = nlp(text)
for ent in doc.ents:
print(ent.text, ent.label_)
Dieses Skript identifiziert “Microsoft” und “Activision” als Unternehmen, “$68,7 Milliarden” als Geld und “18. Januar” als Datum. Vermarkter, die spaCy in Python verwenden, berichten von 25-35% schnelleren Content-Optimierungszyklen durch automatische Synonymgenerierung und semantische Feldanalyse.
Transformatoren mit umarmendem Gesicht: Hochmoderne Modelle
Die Transformers-Bibliothek bietet Zugang zu vortrainierten Modellen wie BERT, GPT und speziellen Varianten. Diese Modelle verstehen den Kontext auf einem Niveau, das traditionelle Algorithmen nicht erreichen können.
Einbau:
pip install transformers
Transformer-Modelle zeichnen sich durch das Verstehen von Suchintentionen, die Generierung semantisch ähnlicher Phrasen und die Analyse der Inhaltstiefe aus. Die Rechenanforderungen sind höher als bei SpaCy, aber die Qualität des semantischen Verständnisses rechtfertigt die Kosten für kritische Analysen.
Bei semantischen Suchanwendungen erfassen transformatorbasierte Einbettungen die Bedeutung besser als herkömmliche Wortvektoren. Dies ermöglicht eine bessere Analyse von Inhaltslücken und einen besseren Abgleich von Absichten.
| Bibliothek | Einrichtung | Am besten für | Lernkurve | SEO-Anwendungen |
|---|---|---|---|---|
| NLTK | pip install nltk | Grundlagen des Lernens | Einsteigerfreundlich | Textvorverarbeitung, Häufigkeitsanalyse |
| spaCy | pip install spacy | Produktionspipelines | Mäßig | Entitätsextraktion, Parsing von Abhängigkeiten |
| Transformatoren | pip install transformers | Erweiterte Semantik | Fortgeschrittene | Absichtsanalyse, semantische Ähnlichkeit |
Named Entity Recognition für die Optimierung von Inhalten
Die Erkennung von benannten Entitäten (Named Entity Recognition, NER) identifiziert und klassifiziert die in einem Text erwähnten Entitäten. Suchmaschinen verwenden ähnliche Techniken, um zu verstehen, worüber Inhalte diskutiert werden.
Zu den Entitäten gehören Personen, Organisationen, Orte, Daten, Produkte und vieles mehr. Die umfassende Abdeckung von Entitäten signalisiert thematische Kompetenz.
Extrahieren von Entitäten mit spaCy
spaCy's vortrainierte Modelle identifizieren Entitäten sofort nach der Installation. Der Prozess erfordert nur wenige Zeilen Code:
Importspatzen
von spacy importieren displacy
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Apple kündigte das iPhone 15 am 12. September 2023 in Cupertino an’.’
doc = nlp(text)
for ent in doc.ents:
print(f'{ent.text}: {ent.label_}’)
Dabei werden Apple als Unternehmen, das iPhone 15 als Produkt, Cupertino als Standort und das Datum identifiziert. Die Analyse der Inhalte von Wettbewerbern zeigt, welche Unternehmen sie abdecken und welche Lücken bestehen.
Gebäude Entity Coverage Maps
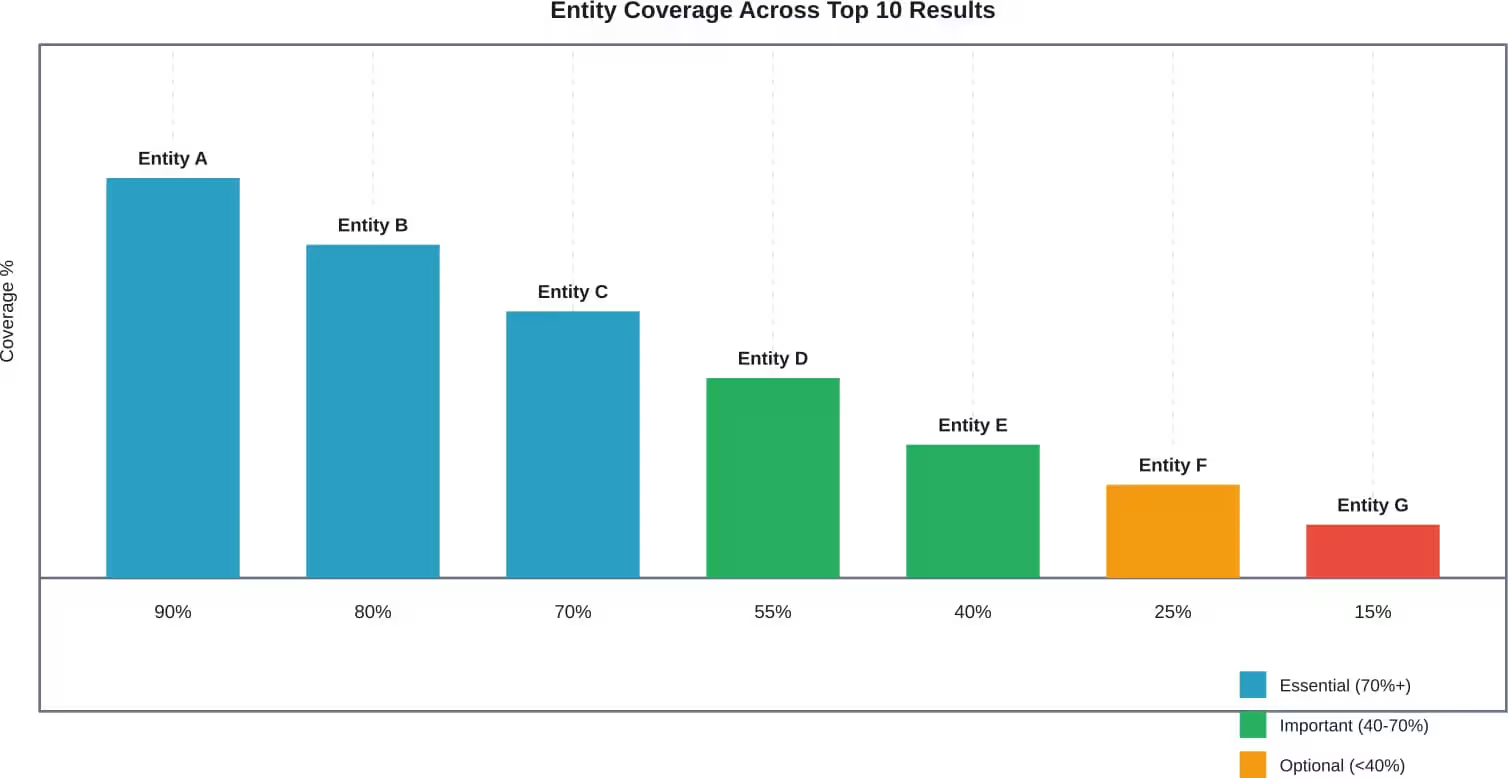
Thematische Autorität erfordert eine natürliche Erwähnung relevanter Entitäten. Python-Skripte können Top-Ranking-Seiten analysieren und Entitätshäufigkeitsmuster extrahieren.
Der Ansatz funktioniert wie folgt: Scrapen der 10 besten Ergebnisse für eine Zielabfrage, Extrahieren von Entitäten aus jedem Ergebnis, Zählen der Häufigkeit von Entitäten in allen Ergebnissen und Identifizieren von Entitäten, die in 70%+ der besten Ergebnisse vorhanden sind.
Entitäten, die in den meisten Top-Ergebnissen erscheinen, stellen die erwartete thematische Abdeckung dar. Inhalte ohne diese Entitäten erscheinen den Suchalgorithmen wahrscheinlich unvollständig. Wenn sie auf natürliche Weise hinzugefügt werden - ohne dass die Erwähnung erzwungen wird -, erhöht sich die semantische Relevanz.
Semantisches Keyword Clustering mit Python
Beim Keyword Clustering werden verwandte Suchbegriffe auf der Grundlage semantischer Ähnlichkeit und nicht nur aufgrund von Wortüberschneidungen gruppiert. Dies zeigt, wie Suchende über Themen denken und wie Inhalte strukturiert sein sollten.
Beim traditionellen Clustering werden gemeinsame Wörter betrachtet. Beim semantischen Clustering wird die Bedeutung analysiert. “Beste Smartphones” und “Top-Mobiltelefone” enthalten keine gemeinsamen Wörter, drücken aber die gleiche Absicht aus.
TF-IDF-basiertes Clustering
Term Frequency - Inverse Document Frequency misst die Bedeutung von Wörtern in verschiedenen Dokumenten. Wörter, die in einem Dokument häufig, in anderen aber selten vorkommen, werden hoch bewertet.
Diese Technik funktioniert bei der anfänglichen Gruppierung von Schlüsselwörtern:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.cluster import KMeans
keywords = [‘python tutorial’, ‘python lernen’, ‘python guide’,
‘Grundlagen des maschinellen Lernens’, ‘ML-Einführung’, ‘Start mit ML’]
vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(Schlüsselwörter)
kmeans = KMeans(n_clusters=2)
kmeans.fit(X)
print(kmeans.labels_)
Diese gruppiert die Stichwörter in Clustern. Die ersten drei Schlüsselwörter werden zusammen gruppiert (Python-Lernen), während die letzten drei getrennt gruppiert werden (Einführung in das maschinelle Lernen).
Fortgeschrittenes semantisches Clustering mit Einbettungen
Transformatorbasierte Einbettungen erfassen die semantische Ähnlichkeit genauer. Sie verstehen, dass “Automobil” und “Auto” trotz unterschiedlicher Schriftzeichen das Gleiche bedeuten.
Die Bibliothek Sentence Transformers vereinfacht dies:
from sentence_transformers import SentenceTransformer
from sklearn.cluster import AgglomerativeClustering
model = SentenceTransformer(‘all-MiniLM-L6-v2’)
keywords = [‘beste Laptops 2026’, ‘Top-Notebooks dieses Jahr’,
‘Laptop-Kaufberatung’, ‘Wie man einen Computer auswählt’]
Einbettungen = model.encode(keywords)
clustering = AgglomerativeClustering(n_clusters=2)
labels = clustering.fit_predict(Einbettungen)
Diese Methode gruppiert semantisch ähnliche Suchanfragen, auch wenn sie völlig unterschiedliche Formulierungen verwenden. Produktvergleichsanfragen werden getrennt von Anleitungen geclustert.
Aufbau von Content-Hubs aus Clustern
Sobald die Schlüsselwörter semantisch geclustert sind, strukturieren Sie den Inhalt entsprechend. Jedes Cluster wird zu einem Content-Hub mit einer Säulenseite und unterstützenden Artikeln.
Cluster zeigen Muster der Suchabsicht auf. Informationelle Suchanfragen werden in Gruppen zusammengefasst. Begriffe mit kommerziellen Absichten bilden separate Cluster. Dies gibt Aufschluss über die Auswahl des Inhaltstyps und die Architektur der internen Verlinkung.
Analyse von Suchintentionen mit NLP
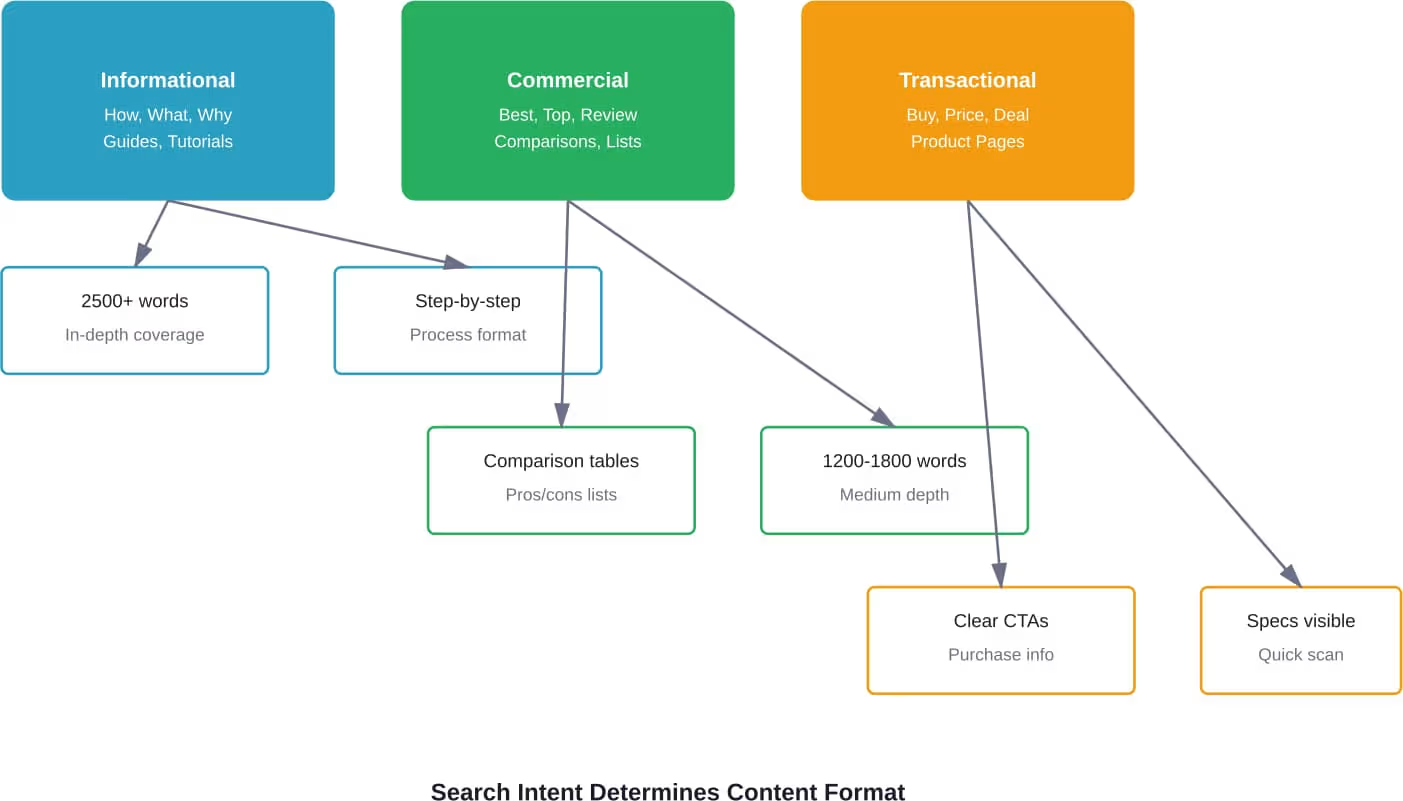
Die Suchabsicht bestimmt, welche Art von Inhalt eine Suchanfrage erfüllt. Python-NLP-Tools klassifizieren die Absicht automatisch, indem sie Abfragemuster und Top-Ranking-Inhalte analysieren.
Es gibt vier Hauptarten von Absichten: Information (Lernen), Navigation (Auffinden bestimmter Websites), Werbung (Produktrecherche) und Transaktion (Kaufbereitschaft).
Absichtsklassifizierung durch Abfrageanalyse
Die Struktur der Anfrage verrät die Absicht. Fragen, die mit “wie”, “was” oder “warum” beginnen, signalisieren eine Informationsabsicht. Sätze, die “best”, “top” oder “review” enthalten, deuten auf eine kommerzielle Rechercheabsicht hin.
Ein einfacher Klassifikator verwendet Mustervergleiche:
Importware
def classify_intent(query):
query_lower = query.lower()
informational_patterns = [r’^how’, r’^what’, r’^why’, r’^when’, r'guide’, r'tutorial’]
commercial_patterns = [r'best’, r'top’, r'review’, r'compare’, r'vs’]
transactional_patterns = [r'buy’, r'purchase’, r'price’, r'cheap’, r'deal’]
for pattern in transactional_patterns:
if re.search(pattern, query_lower):
return ‘Transaktionsbezogen’
for pattern in commercial_patterns:
if re.search(pattern, query_lower):
return ‘Kommerziell’
for pattern in informational_patterns:
if re.search(pattern, query_lower):
return ‘Informationell’
return ‘Navigieren’
print(classify_intent(‘wie lerne ich python’)) # Informativ
print(classify_intent(‘beste python kurse’)) # Kommerziell
SERP-Inhaltsanalyse zur Absichtsüberprüfung
Top-Ranking-Inhaltstypen bestätigen die Absichtsklassifizierung. Handelt es sich bei allen Top-Ergebnissen um Listenartikel, erwartet die Suchanfrage vergleichende Inhalte. Wenn Tutorials dominieren, schneiden Lehrinhalte am besten ab.
Die automatisierte SERP-Analyse extrahiert Muster:
- Zählen von Fragezeichen in Titeln (FAQ-ähnlicher Inhalt)
- Identifizieren Sie Listenindikatoren (nummerierte Schritte, Aufzählungspunkte)
- Produkterwähnungen und Preise aufspüren (kommerzielle Inhalte)
- Messung der durchschnittlichen Länge des Inhalts (Erwartungen an die Tiefe)
Die Anpassung des Inhaltsformats an die vorherrschenden SERP-Muster verbessert das Ranking-Potenzial. Eine ausführliche Anleitung wird nicht für eine Suchanfrage ranken, bei der Suchende schnelle Produktvergleiche erwarten.
Inhaltliche Lückenanalyse mit Python
Inhaltslücken sind Themen, die Ihre Konkurrenten abdecken und die auf Ihrer Website fehlen. Die Identifizierung und Schließung dieser Lücken erhöht die thematische Autorität und sorgt für zusätzlichen Suchverkehr.
Eine manuelle Lückenanalyse dauert Stunden. Mit Python lässt sich der Prozess in wenigen Minuten automatisieren.
Scraping von Content-Strukturen der Konkurrenz
Die Analyse der Überschriften von Wettbewerbern zeigt deren thematische Abdeckung. Beautiful Soup extrahiert effizient Überschriftenstrukturen:
von bs4 importieren BeautifulSoup
Einfuhrgesuche
url = ‘https://competitor.com/target-article’
Antwort = requests.get(url)
soup = BeautifulSoup(response.content, ‘html.parser’)
Überschriften = []
for heading in soup.find_all([‘h2’, ‘h3’]):
headings.append(heading.get_text().strip())
für h in Überschriften:
drucken(h)
Führen Sie dies für mehrere Seiten mit den besten Rankings durch. Extrahieren Sie alle H2 und H3 Überschriften. Vergleichen Sie deren Themen mit Ihrem vorhandenen Inhalt.
Suche nach fehlender thematischer Deckung
Sobald die Überschriften der Konkurrenten gesammelt sind, sollten Sie gemeinsame Themen ermitteln, die in Ihrem Inhalt fehlen. Themen, die in 60%+ der Top-Ergebnisse erscheinen, aber auf Ihren Seiten fehlen, stellen klare Lücken dar.
Ein Skript zur Häufigkeitsanalyse zählt das Auftreten von Überschriftenthemen:
from collections import Zähler
Importware
all_competitor_headings = [
# Überschriften von Mitbewerber 1
[‘Einführung’, ‘Einrichtungsanleitung’, ‘Fortgeschrittene Techniken’, ‘Häufige Fehler’],
# Überschriften von Mitbewerber 2
[‘Getting Started’, ‘Setup Guide’, ‘Troubleshooting’, ‘Best Practices’],
# Überschriften von Mitbewerber 3
[‘Übersicht’, ‘Installation’, ‘Fortgeschrittene Techniken’, ‘Häufige Fehler’]
]
flat_headings = [h for sublist in all_competitor_headings for h in sublist]
heading_counts = Counter(flat_headings)
for heading, count in heading_counts.most_common():
Prozentsatz = (count / len(all_competitor_headings)) * 100
print(f'{Überschrift}: {Anzahl} Vorkommen ({Prozentsatz:.0f}%)’)
Überschriften, die bei Wettbewerbern häufig vorkommen, aber in Ihrem Inhalt fehlen, sollten hinzugefügt werden. Das bedeutet nicht, deren Struktur zu kopieren, sondern eine umfassende Abdeckung der erwarteten Unterthemen sicherzustellen.
Optimierung der Lesbarkeit und Struktur von Inhalten
Die Lesbarkeit wirkt sich sowohl auf das Engagement der Nutzer als auch auf die Platzierung in den Suchergebnissen aus. Python-Tools messen die Lesbarkeit objektiv und zeigen Verbesserungsmöglichkeiten auf.
Suchmaschinen berücksichtigen Verweildauer und Engagement-Signale. Schwer zu lesende Inhalte führen dazu, dass Besucher schnell wieder abwandern, was sich negativ auf das Ranking auswirkt.
Berechnung der Lesbarkeitswerte
Die textstat-Bibliothek berechnet Standard-Lesbarkeitsmetriken:
importieren Sie textstat
text = ”’Ihr Inhalt steht hier. Dies kann ein vollständiger Artikel sein
oder nur einen Abschnitt, den Sie auf seine Lesbarkeit hin analysieren wollen.”
flesch_reading_ease = textstat.flesch_reading_ease(text)
flesch_kincaid_grade = textstat.flesch_kincaid_grade(text)
print(f'Flesch Reading Ease: {flesch_reading_ease}’)
print(f'Klassenstufe: {flesch_kincaid_grade}’)
Flesch Reading Ease"-Werte über 60 weisen auf zugängliche Inhalte hin. Werte unter 30 deuten auf eine schwierige Lektüre hin, die das Publikum verlieren könnte. Die Flesch-Kincaid-Niveaustufe gibt an, welche US-Schulstufe zum Verständnis des Textes erforderlich ist.
Für die meisten Webinhalte sollten Sie die Klassen 8-10 anstreben. Technische Themen können ein höheres Niveau rechtfertigen, aber auch komplexe Themen profitieren von einer klaren Sprache.
Satzlänge und Komplexitätsanalyse
Eine durchschnittliche Satzlänge wirkt sich auf die Lesbarkeit aus. Sehr lange Sätze ermüden die Leser. Zu viele kurze Sätze wirken abgehackt.
spaCy analysiert die Satzstruktur:
Importspatzen
nlp = spacy.load(‘en_core_web_sm’)
text = ”’Ihr Artikeltext hier.”’
doc = nlp(text)
sentence_lengths = [len(sent) for sent in doc.sents]
durchschnittliche_Länge = Summe(Satz_Längen) / len(Satz_Längen)
print(f'Durchschnittliche Satzlänge: {durchschnittliche_Länge:.1f} Wörter’)
print(f'Längster Satz: {max(satz_längen)} wörter’)
print(f'Kürzester Satz: {min(satz_längen)} wörter’)
Streben Sie eine durchschnittliche Satzlänge von 15-20 Wörtern an. Mischen Sie kürzere, prägnante Sätze mit längeren, detaillierten Sätzen. Sätze mit mehr als 35-40 Wörtern verwirren die Leser oft und sollten aufgeteilt werden.
Automatisierte SEO-Inhaltsanalyse-Tools erstellen
Die Kombination von NLP-Techniken in einheitlichen Analysetools automatisiert sich wiederholende Optimierungsaufgaben. Ein einziges Skript kann Entitäten extrahieren, die Absicht klassifizieren, die Lesbarkeit messen und Lücken identifizieren.
Erstellen eines Skripts zur Inhaltskontrolle
Ein umfassendes Audit-Skript analysiert die vorhandenen Inhalte in großem Umfang:
Importspatzen
importieren Sie textstat
from collections import Zähler
nlp = spacy.load(‘en_core_web_sm’)
def analyze_content(text):
doc = nlp(text)
# Extraktion von Entitäten
entities = [(ent.text, ent.label_) for ent in doc.ents]
entity_counts = Counter([label for _, label in entities])
# Lesbarkeit
Lesbarkeit = textstat.flesch_reading_ease(text)
grade_level = textstat.flesch_kincaid_grade(text)
# Struktur
sentence_count = len(list(doc.sents))
word_count = len([token for token in doc if not token.is_punct])
zurück {
‘word_count’: wort_zahl,
‘Satz_Zahl’: Satz_Zahl,
‘readability_score’: Lesbarkeit,
‘grade_level’: grade_level,
‘entity_counts’: dict(entity_counts),
‘unique_entities’: len(set([text for text, _ in entities]))
}
# Verwendung für den Inhalt
Ergebnisse = analyze_content(Ihr_Artikel_Text)
drucken(Ergebnisse)
Dies liefert verwertbare Metriken: Wortanzahl, Satzanzahl, Lesbarkeitsbewertungen, Entitätenvielfalt und Entitätstypverteilung. Führen Sie es für alle Inhalte der Website aus, um leistungsschwache Seiten zu identifizieren.
Dashboard für Wettbewerbervergleiche
Die Analyse der Inhalte von Mitbewerbern zusammen mit Ihren eigenen zeigt relative Stärken und Schwächen auf. Ein Vergleichsskript verarbeitet mehrere URLs:
Einfuhrgesuche
von bs4 importieren BeautifulSoup
def scrape_and_analyze(url):
Antwort = requests.get(url)
soup = BeautifulSoup(response.content, ‘html.parser’)
# Hauptinhalt extrahieren (Selektor für Zielseiten anpassen)
Inhalt = soup.find(‘Artikel’).get_text()
return analyze_content(Inhalt)
competitor_urls = [
‘https://competitor1.com/article’,
‘https://competitor2.com/article’
]
for url in competitor_urls:
print(f’\nAnalysieren: {url}’)
Ergebnisse = scrape_and_analyze(url)
print(f ”Wörter: {Ergebnisse[‘Wort_Zahl’]}”)
print(f ”Lesbarkeit: {Ergebnisse[‘readability_score’]:.1f}”)
print(f ”Entities: {results[‘unique_entities’]}”)
Vergleichen Sie Ihre Metriken mit den Durchschnittswerten der Mitbewerber. Wenn die Mitbewerber im Durchschnitt 2.500 Wörter haben und Ihre Seite 1.200, kann eine Erweiterung der Inhaltstiefe die Platzierung verbessern. Wenn sie 25 einzigartige Einheiten erwähnen und Ihre Seite 12 abdeckt, könnte eine größere thematische Breite helfen.
| Metrisch | Ihr Inhalt | Mitbewerber Avg | Erforderliche Maßnahmen |
|---|---|---|---|
| Wortzahl | 1,850 | 2,600 | Abdeckung ausweiten |
| Bewertung der Lesbarkeit | 58 | 65 | Vereinfachung der Sprache |
| Einzigartige Entitäten | 14 | 22 | Relevante Entitäten hinzufügen |
| Durchschnittliche Urteilslänge | 24 Wörter | 18 Wörter | Sätze kürzen |
| Überschriften (H2+H3) | 8 | 13 | Verbesserung der Struktur |
Nutzung von Transformatoren für die semantische Suche
Transformer-Modelle haben das semantische Verständnis revolutioniert. Sie treiben moderne Suchmaschinen an und ermöglichen fortschrittliche Techniken zur Optimierung von Inhalten.
Untersuchungen zur semantischen Suche haben ergeben, dass transformatorbasierte Ansätze die traditionellen lexikalischen Methoden bei der Informationsbeschaffung deutlich übertreffen.
Generierung semantischer Einbettungen
Einbettungen wandeln Text in numerische Vektoren um, die die Bedeutung erfassen. Semantisch ähnliche Texte erzeugen ähnliche Vektoren, selbst bei unterschiedlichem Wortlaut.
Sentence Transformers erzeugt diese Einbettungen:
from sentence_transformers import SentenceTransformer, util
model = SentenceTransformer(‘all-MiniLM-L6-v2’)
sätze = [
‘Python ist eine Programmiersprache’,
‘Python wird zum Programmieren verwendet’,
‘Schlangen sind Reptilien’.’
]
Einbettungen = model.encode(sätze)
# Berechnung der Ähnlichkeit zwischen dem ersten und den anderen Sätzen
similarity_1_2 = util.cos_sim(Einbettungen[0], Einbettungen[1])
similarity_1_3 = util.cos_sim(einbettungen[0], einbettungen[2])
print(f'Ähnlichkeit (1-2): {Ähnlichkeit_1_2.item():.3f}’)
print(f'Ähnlichkeit (1-3): {Ähnlichkeit_1_3.item():.3f}’)
Die ersten beiden Sätze weisen trotz unterschiedlicher Wörter eine hohe Ähnlichkeit auf. Der dritte Satz weist eine geringe Ähnlichkeit auf, da er eine unterschiedliche semantische Bedeutung aufweist.
Suche nach semantisch verwandten Inhalten
Einbettungen identifizieren verwandte Artikel für die interne Verlinkung. Konvertieren Sie alle Artikel der Website in Einbettungen und finden Sie dann Teile mit hoher semantischer Ähnlichkeit.
Dadurch werden natürliche Verknüpfungsmöglichkeiten aufgedeckt, die thematische Cluster verstärken:
Artikel = [
{‘title’: ‘Python-Grundlagen’, ‘Text’: ‘Einführung in die Python-Programmierung...’},
{‘title’: ‘Fortgeschrittenes Python’, ‘text’: ‘Fortgeschrittene Python-Techniken...’},
{‘title’: ‘JavaScript-Anleitung’, ‘text’: ‘JavaScript-Grundlagen lernen...’}
]
Einbettungen = model.encode([a[‘text’] for a in articles])
# Ähnliche Artikel wie der erste finden
target_embedding = Einbettungen[0]
similarities = [util.cos_sim(target_embedding, emb).item() for emb in embeddings[1:]]
for i, sim in enumerate(similarities, 1):
print(f”{Artikel[i][‘Titel’]}: {sim:.3f}”)
Artikel mit Ähnlichkeitswerten von über 0,6 bis 0,7 sind gute Kandidaten für interne Links. Auf diese Weise werden semantische Inhaltscluster gebildet, die den Suchmaschinen thematisches Fachwissen vermitteln.
Lokale SEO-Verbesserung mit NLP
Ortsbezogene Suchen erfordern eine spezielle semantische Optimierung. Python NLP extrahiert Ortsangaben und sorgt für den richtigen geografischen Kontext.
Extrahieren von geografischen Entitäten
spaCy identifiziert Standort-Erwähnungen automatisch:
Importspatzen
nlp = spacy.load(‘en_core_web_sm’)
text = ‘Besuchen Sie unsere Büros in Seattle, Portland und San Francisco’.’
doc = nlp(text)
locations = [ent.text for ent in doc.ents if ent.label_ == ‘GPE’]
print(f'Genannte Orte: {Orte}’)
GPE (Geo-Political Entity) erfasst Städte, Staaten und Länder. FAC erfasst Einrichtungen und Gebäude.
Achten Sie bei der lokalen Suchmaschinenoptimierung darauf, dass die Ortsangaben im Inhalt natürlich erscheinen. Auf den Serviceseiten sollten die bedienten Städte, Stadtteile und regionalen Sehenswürdigkeiten erwähnt werden.
Analyse der lokalen Suchintention
Lokale Suchanfragen beinhalten oft eine implizite Ortsabsicht ohne explizite Ortsangaben. “Coffee Shops” impliziert “Coffee Shops in meiner Nähe”.”
Die Analyse der SERPs für Suchanfragen zeigt, wann Suchmaschinen eine lokale Absicht verfolgen:
- Kartenpakete in den Ergebnissen zeigen lokale Absichten an
- Unternehmenseinträge dominieren die Rankings
- Ergebnisse variieren je nach Standort des Suchenden
Inhalte, die auf diese Suchanfragen abzielen, brauchen starke lokale Signale: Adresserwähnungen, Beschreibungen von Servicegebieten und lokal relevante Unternehmen.
Überwachung von semantischen Rankings und Leistung
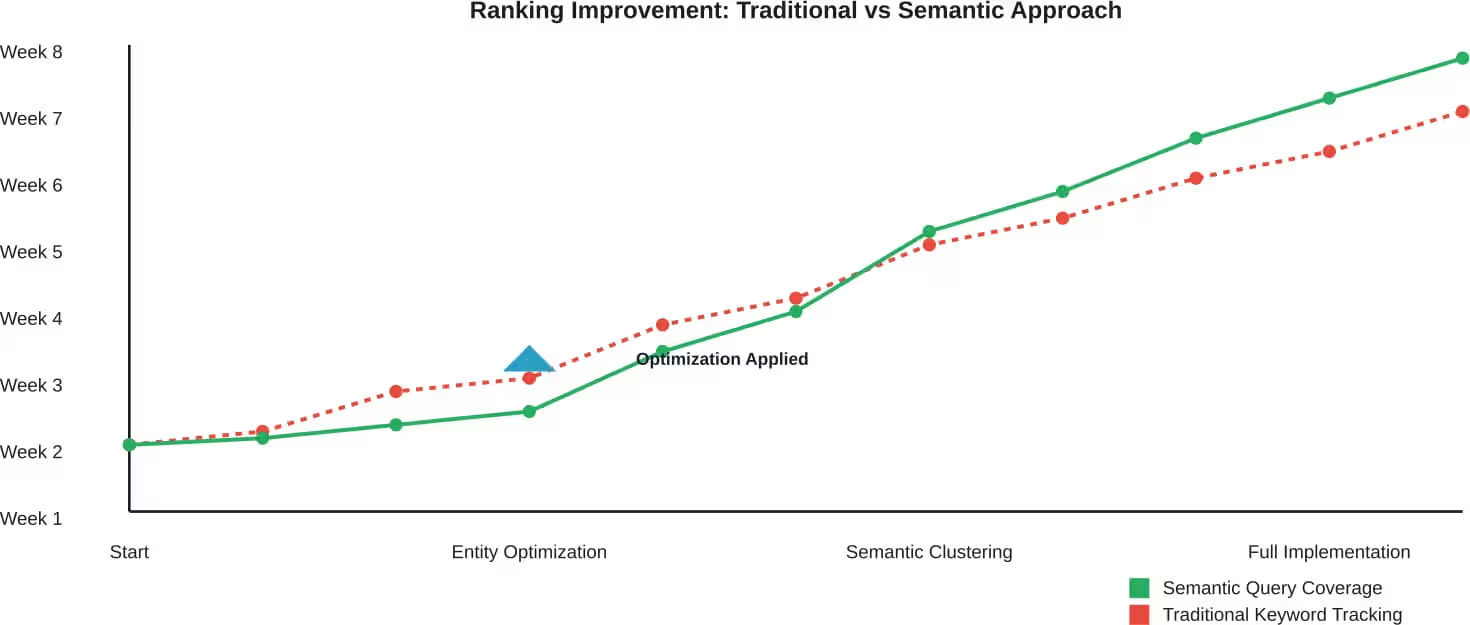
Die Verfolgung des semantischen SEO-Erfolgs erfordert andere Metriken als das traditionelle Keyword-Tracking. Überwachen Sie thematische Autoritätssignale, die Sichtbarkeit von Entitäten und das Wachstum des semantischen Traffics.
Entity-basierte Rangverfolgung
Anstatt einzelne Schlüsselwörter zu verfolgen, sollten Sie beobachten, wie gut der Inhalt für entitätsbezogene Suchanfragen rangiert. Wenn Sie auf die Entität “Python-Programmierung” abzielen, verfolgen Sie die Rankings für:
- Kernabfragen von Entitäten (“Python-Programmierung”)
- Verwandte Suchanfragen (“Python-Tutorials”, “Python-Bibliotheken”)
- Langschwänzige semantische Variationen
Verbesserte Entity-Assoziationen fördern den Traffic über mehrere verwandte Suchanfragen, nicht nur über die Zielkeywords.
Inhaltliche Leistungsanalyse
Vergleichen Sie die Metriken der Inhalte vor und nach der semantischen Optimierung:
- Durchschnittliche Verweildauer auf der Seite (Verbesserung des Engagements)
- Seiten pro Sitzung (Wirksamkeit interner Links)
- Absprungrate (Relevanzabgleich)
- Impressionen für verwandte Suchanfragen (Erweiterung der thematischen Autorität)
Die semantische Optimierung erhöht in der Regel die Breite des Datenverkehrs - die Anzahl der verschiedenen Suchanfragen, die zu Besuchen führen - und nicht nur das Volumen.
Übliche Python NLP SEO Arbeitsabläufe
Eine wirksame Umsetzung kombiniert mehrere Techniken zu wiederholbaren Arbeitsabläufen. Diese Prozesse verwandeln isolierte Skripte in systematische Optimierungsansätze.
Neuer Workflow zur Erstellung von Inhalten
Bevor Sie neue Inhalte schreiben:
- Scrapen Sie die 10 bestplatzierten Seiten für Ihre Suchanfrage
- Extrahieren von Entitäten aus allen Seiten mit spaCy
- Identifizierung gemeinsamer Einheiten (70%+ Präsenz)
- Semantische Cluster verwandter Schlüsselwörter
- Analysieren der SERP-Inhaltsstruktur (Überschriften, Format)
- Bestimmen Sie die vorherrschende Suchabsicht
- Berechnung der durchschnittlichen Inhaltslänge und Lesbarkeit
Erstellen Sie Inhalte, die den Erwartungen an das Format entsprechen, die erwarteten Entitäten abdecken und die identifizierte Absicht ansprechen. Dieser datengesteuerte Ansatz reduziert das Rätselraten.
Bestehender Workflow zur Optimierung von Inhalten
Für leistungsschwache bestehende Inhalte:
- Lesbarkeitsanalyse durchführen (zu vereinfachende Sätze identifizieren)
- Aktuellen Erfassungsbereich extrahieren
- Vergleich mit dem Versicherungsschutz von Wettbewerbern
- Identifizieren Sie fehlende Entitäten aus den Top-Ergebnissen
- Prüfen Sie die semantische Ähnlichkeit zu den am besten bewerteten Inhalten
- Interne Verlinkungsmöglichkeiten über Einbettungen finden
- Aktualisieren Sie den Inhalt und füllen Sie Lücken
Dieser systematische Ansatz stellt sicher, dass die Optimierung tatsächliche Mängel behebt und nicht nur zufällige Änderungen vornimmt.
Bewährte Praktiken und Überlegungen zur Implementierung
Die erfolgreiche Implementierung von Python NLP erfordert ein Gleichgewicht zwischen Automatisierung und redaktioneller Beurteilung. Skripte liefern datengestützte Erkenntnisse, aber die Qualität der Inhalte hängt letztlich von der menschlichen Expertise ab.
Datenqualität ist wichtig
Die Qualität der automatisierten Analyse hängt vollständig von der Qualität der Eingabedaten ab. Das Scraping von Wettbewerbern erfordert eine genaue Extraktion von Inhalten - ohne Navigation, Werbung und Fußzeilen. Viele Websites sind unterschiedlich strukturiert, was eine angepasste Extraktionslogik erfordert.
Testen Sie Skripte an kleinen Stichproben, bevor Sie sie im großen Maßstab ausführen. Überprüfen Sie die Genauigkeit der Entitätsextraktion manuell. Prüfen Sie, ob die Berechnungen der Lesbarkeit die tatsächliche Leseschwierigkeit widerspiegeln. Schlechte Eingabedaten führen zu irreführenden Analysen.
Nicht überoptimieren
NLP-Tools zeigen Optimierungsmöglichkeiten auf, aber wenn man jede identifizierte Entität in den Inhalt packt, entsteht ein unnatürlicher Text. Priorisieren Sie die relevantesten Entitäten und Themen. Nicht jede semantische Lücke muss gefüllt werden.
Suchmaschinen erkennen Überoptimierungsmuster. Inhalte, die zu Manipulationszwecken mit Entitäten gefüllt werden, schneiden schlecht ab. Eine natürliche Abdeckung wirklich relevanter Konzepte funktioniert besser als erzwungene Erwähnungen.
Kombinieren Sie automatisierte Analysen mit menschlichem Urteilsvermögen
Python-Skripte ermitteln, welche Themen die Wettbewerber behandeln und welche Unternehmen sie erwähnen. Menschliche Redakteure bestimmen, wie diese Themen auf natürliche Weise angesprochen werden können und ob sie für die Zielgruppe tatsächlich wichtig sind.
Automatisierte Lesbarkeitsbewertungen bieten eine Orientierungshilfe, aber der Kontext ist wichtig. Technische Inhalte für ein Fachpublikum verwenden zu Recht eine komplexe Sprache. Eine Vereinfachung ist nicht immer angebracht.
Modelle auf dem neuesten Stand halten
NLP-Bibliotheken und -Modelle werden häufig aktualisiert. spaCy veröffentlicht neue Versionen mit verbesserter Genauigkeit. Transformers fügt regelmäßig neue vortrainierte Modelle hinzu. Regelmäßige Aktualisierungen der Abhängigkeiten gewährleisten den Zugang zu Verbesserungen.
Modellaktualisierungen können die Ausgabe leicht verändern. Testen Sie die aktualisierten Versionen, bevor Sie sie in Produktionsworkflows einsetzen, um alle Verhaltensänderungen zu verstehen.
Vorwärtskommen mit Python NLP für SEO
Das semantische Web entwickelt sich weiter. Die Suchalgorithmen werden immer ausgefeilter, um den Kontext zu verstehen und Fachwissen zu bewerten. Python-NLP-Tools bieten die analytischen Fähigkeiten, die erforderlich sind, um Schritt zu halten.
Beginnen Sie mit einfachen Implementierungen. Extrahieren Sie Entitäten aus hochrangigen Inhalten. Berechnen Sie die Lesbarkeit für bestehende Seiten. Bauen Sie darauf auf, wenn Sie sich mit den Werkzeugen vertraut gemacht haben.
Der Wettbewerbsvorteil entsteht durch konsequente Anwendung, nicht durch perfekte Skripte. Websites, die bei der Planung und Optimierung von Inhalten systematisch semantische Analysen anwenden, verschaffen sich mit der Zeit Vorteile.
Suchmaschinen belohnen umfassende, gut strukturierte Inhalte, die thematisches Fachwissen erkennen lassen. Python NLP automatisiert die Suche danach, wie eine umfassende Berichterstattung zu einem beliebigen Thema aussieht. Der Rest ist Ausführung.
Für die Umsetzung sind weder Data-Science-Teams noch eine komplexe Infrastruktur erforderlich. Die diskutierten Bibliotheken laufen auf jedem Computer. Ein paar hundert Zeilen Python-Code können Content-Workflows verändern.
Die semantische Zukunft der Suche ist bereits da. Tools, die vor ein paar Jahren noch als innovativ galten, gehören heute zum Standard. Websites, die diese Techniken beherrschen, erlangen eine thematische Autorität, die mit traditionellen Keyword-Taktiken nicht erreicht werden kann.
Beginnen Sie noch heute mit dem Aufbau Ihres Python NLP-Toolkits. Extrahieren Sie diese Entitäten. Clustern Sie diese Schlüsselwörter. Analysieren Sie die Inhaltsstruktur. Die Daten werden Ihnen genau zeigen, wie eine umfassende thematische Abdeckung aussieht.









