Korte samenvatting: Een robots.txt-bestand is een tekstbestand dat in de hoofdmap van een website wordt geplaatst en dat zoekmachinecrawlers vertelt welke pagina's of secties wel of niet toegankelijk zijn. Het wordt voornamelijk gebruikt om crawlerverkeer te beheren en overbelasting van de server te voorkomen, niet om pagina's te verbergen voor zoekresultaten. Volgens Google Search Central helpt robots.txt om te bepalen hoe zoekmachines uw site crawlen, maar om pagina's daadwerkelijk te blokkeren voor weergave in zoekresultaten, hebt u noindex-tags of wachtwoordbeveiliging nodig.
Zoekmachines sturen dagelijks geautomatiseerde bots om websites te crawlen. Deze crawlers indexeren inhoud, volgen links en bepalen wat er in de zoekresultaten verschijnt. Maar het zit zo: niet elke pagina op een website hoeft te worden gecrawld. Sommige pagina's verspillen bronnen van crawlers en sommige pagina's zouden helemaal niet geïndexeerd moeten worden.
Dat is waar robots.txt om de hoek komt kijken.
Dit kleine tekstbestand geeft instructies aan webcrawlers over welke delen van een site ze kunnen openen. Het bestaat al sinds het begin van de jaren 90 en blijft een fundamenteel onderdeel van technische SEO. Als je begrijpt hoe robots.txt werkt, kun je indexeringsrampen voorkomen, de crawlefficiëntie verbeteren en gevoelige delen van een website beschermen.
Laten we eens kijken wat robots.txt precies is, hoe het werkt en waarom het belangrijk is voor SEO in 2026.
Het bestand Robots.Txt begrijpen
Volgens Google Search Central vertelt een robots.txt-bestand zoekmachinecrawlers welke URL's op een site toegankelijk zijn voor de crawler. Het wordt voornamelijk gebruikt om crawlerverkeer te beheren en te voorkomen dat servers worden overbelast met verzoeken.
Het bestand staat in de hoofdmap van een website. Voor een site als example.com staat het robots.txt-bestand op example.com/robots.txt. Zoekmachines controleren deze locatie voordat ze andere pagina's crawlen.
Dit is wat robots.txt uniek maakt: het is een tekstbestand dat het Robots Exclusion Protocol (REP) volgt. Het REP is ontstaan uit een consensus uit 1994 en wordt nu algemeen erkend door grote zoekmachines zoals Google, Bing en anderen.
Hoe Robots.Txt eigenlijk werkt
Wanneer een zoekmachinebot een website wil crawlen, volgt hij een specifieke volgorde:
- De bot probeert toegang te krijgen tot het robots.txt-bestand op het hoofddomein
- Als het bestand bestaat, leest en parseert de bot de instructies
- De bot volgt de richtlijnen die van toepassing zijn op zijn user-agent
- Alleen dan worden toegestane pagina's gecrawld
Volgens robotstxt.org is de standaard ontstaan uit een consensus tussen robotauteurs en geïnteresseerden in 1994. Technisch gezien is het vrijwillig - robots kiezen zelf of ze het respecteren - maar alle legitieme zoekmachines respecteren robots.txt-richtlijnen.

Wat Robots.Txt wel en niet kan doen
Er bestaat een veelvoorkomende misvatting over robots.txt. Veel site-eigenaren denken dat het voorkomt dat pagina's in zoekresultaten verschijnen. Dat is niet zo.
Google Search Central stelt expliciet dat robots.txt geen mechanisme is om webpagina's uit Google te houden. Als andere sites naar een geblokkeerde pagina linken, kan deze nog steeds in de zoekresultaten verschijnen, alleen zonder beschrijving.
Om indexering daadwerkelijk te voorkomen, moeten sites gebruik maken van:
- Noindex metatags in de HTML-pagina
- X-Robots-Tag HTTP-headers
- Wachtwoordbeveiliging of verificatievereisten
Robots.txt regelt het crawlgedrag, niet het indexeren. Dat is een cruciaal onderscheid.
De basissyntaxis van Robots.Txt
Het robots.txt-bestand gebruikt een eenvoudige syntaxis. Zelfs zonder technische kennis is het formaat leesbaar en logisch.
Hier is een basisvoorbeeld:
User-agent: *
Niet toestaan: /admin/
Niet toestaan: /temp/
Toestaan: /temp/public/
Sitemap: https://www.example.com/sitemap.xml
Laten we elk deel decoderen.
Richtlijn User-Agent
De user-agent regel specificeert op welke crawler de volgende regels van toepassing zijn. Het sterretje (*) betekent alle bots. Specifieke bots kunnen op naam worden ingesteld:
- Googlebot (de belangrijkste crawler van Google)
- Googlebot-Image (Google's crawler voor afbeeldingen)
- Bingbot (de crawler van Microsoft Bing)
- AhrefsBot (SEO-tool crawler van Ahrefs)
Er kunnen meerdere user-agent secties bestaan in één bestand, elk met verschillende regels.
Richtlijn niet toestaan
De richtlijn Disallow vertelt bots welke URL's of paden ze niet kunnen openen. Een paar voorbeelden:
| Richtlijn | Wat het blokkeert |
|---|---|
| Niet toestaan: /admin/ | Alle URL's die beginnen met /admin/ |
| Disallow: /*.pdf$ | Alle PDF-bestanden op de hele site |
| Niet toestaan: / | Alles op de site |
| Niet toestaan: | Niets (staat alles toe) |
Richtlijn toestaan
De Allow richtlijn maakt uitzonderingen op de Disallow regels. Het is vooral nuttig voor het toestaan van toegang tot specifieke submappen binnen geblokkeerde secties.
Bijvoorbeeld:
User-agent: *
Niet toestaan: /private/
Toestaan: /private/publieke-bronnen/
Hiermee wordt de hele map /private/ geblokkeerd, behalve de map /private/public-resources/.
Sitemap-richtlijn
Het opnemen van sitemaplocaties helpt zoekmachines om belangrijke pagina's efficiënter te vinden en te crawlen. Er kunnen meerdere sitemap-regels worden toegevoegd:
Sitemap: https://example.com/sitemap.xml
Sitemap: https://example.com/sitemap-images.xml
Volgens de documentatie van Google wordt het opnemen van sitemaps in robots.txt beschouwd als een best practice voor crawlefficiëntie.
Waarom Robots.Txt belangrijk is voor SEO
Het beheren van de manier waarop zoekmachines een website crawlen, heeft een directe invloed op de SEO-prestaties. Robots.txt biedt controle over dit proces.
Kruipbudgetverspilling voorkomen
Zoekmachines wijzen een crawlbudget toe aan elke site - het aantal pagina's dat hun bots zullen crawlen tijdens een bepaalde periode. Grote sites met duizenden pagina's kunnen dit budget snel uitputten door inhoud van lage waarde.
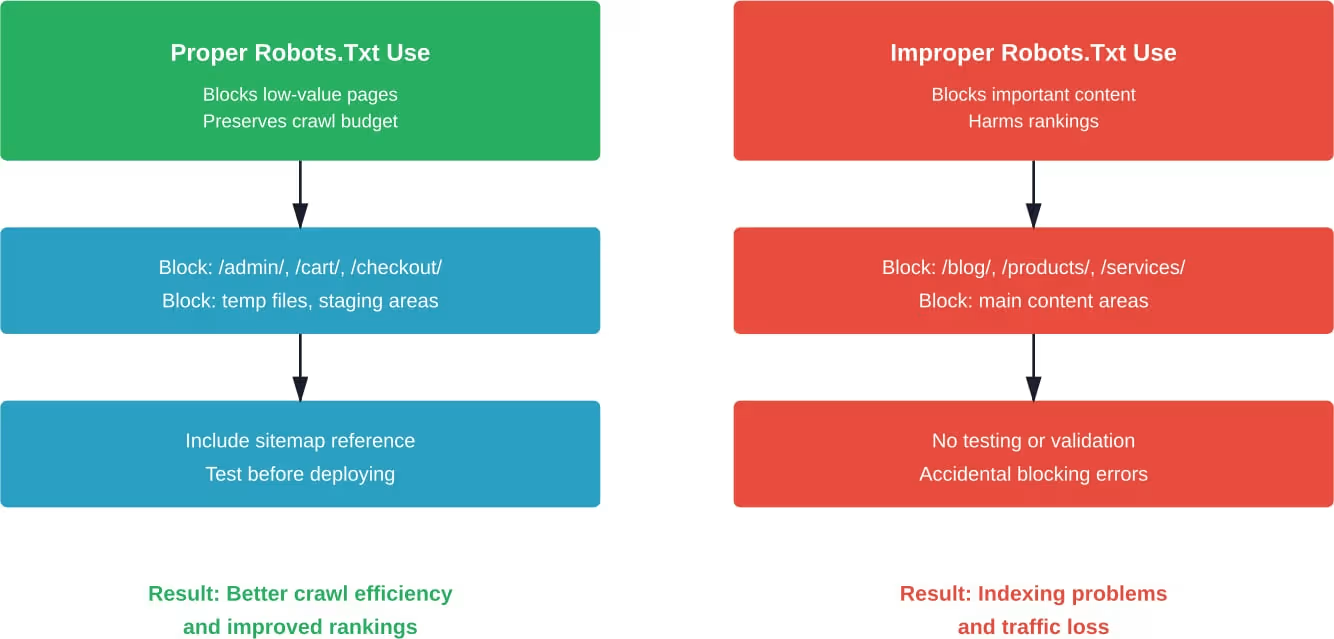
Door robots.txt te gebruiken, kunnen crawlers de toegang tot dubbele pagina's, staging-gebieden of adminsecties blokkeren, zodat er crawlbudget overblijft voor belangrijke inhoud. Dit is vooral belangrijk voor e-commercesites met gefacetteerde navigatie die duizenden URL-variaties creëren.
Serverbronnen beschermen
Agressief crawlen kan de systeembronnen belasten, vooral voor kleinere sites of sites met beperkte hosting. Volgens het Bing Webmaster Blog helpt het regelen van de crawlsnelheid via robots.txt (en crawlvertragingsrichtlijnen) om problemen met de belasting van de webserver op te vangen.
Als een site plat gaat omdat bots hem overspoelen met verzoeken, is dat een SEO-ramp. Rankings dalen, gebruikers krijgen foutpagina's en herstel kost tijd.
Problemen met dubbele inhoud vermijden
Wanneer zoekmachines meerdere versies van dezelfde inhoud crawlen en indexeren, ontstaan er problemen met dubbele inhoud. Hoewel Google beweert dat het goed omgaat met duplicaten, waarom zou je het risico nemen?
Het blokkeren van URL's op basis van parameters, afdrukversies of sessie-ID-variaties voorkomt onnodige dubbele indexering.
Technische SEO verbeteren en zichtbaarheid vergroten
Inzicht in robots.txt is slechts één onderdeel van technische SEO, en LENGREO richt zich op het optimaliseren van het volledige technische fundament om de crawlability en rankings te verbeteren. Technische problemen kunnen zelfs de beste content beperken, dus een solide basis is cruciaal voor SEO-succes op de lange termijn.
- crawl- en indexoptimalisatie
- site structuur verbeteringen
- prestaties en snelheid
Als je technische problemen wilt oplossen en de zichtbaarheid in de zoekresultaten wilt verbeteren, gratis advies bij LENGREO.
Algemene Robots.Txt-gebruiksgevallen
Verschillende websites hebben verschillende behoeften. Hier zijn praktische scenario's waarbij robots.txt essentieel is.
Zoekfuncties en filterpagina's blokkeren
E-commercesites genereren talloze URL's door middel van gefacetteerde navigatie - filteren op grootte, kleur, prijsklasse en andere kenmerken. Elke combinatie creëert een unieke URL die de linkwaarde vermindert en crawlbudget verspilt.
Voorbeeld robots.txt voor een e-commercesite:
User-agent: *
Niet toestaan: /*?filter=
Niet toestaan: /*?sort=
Niet toestaan: /zoeken?*
Niet toestaan: /cart
Niet toestaan: /kassa
Staging- en ontwikkelingsgebieden beschermen
Ontwikkelingssites, staging-omgevingen en testgebieden mogen nooit in zoekresultaten verschijnen. Door ze te blokkeren voorkomt u dat ze per ongeluk worden geïndexeerd:
User-agent: *
Niet toestaan: /staging/
Niet toestaan: /dev/
Niet toestaan: /test/
Controle over het crawlen van PDF- en mediabestanden
Sommige sites hebben honderden PDF's of downloadbare bronnen. Als deze niet bedoeld zijn voor zoekzichtbaarheid, blokkeer ze dan:
User-agent: *
Disallow: /*.pdf$
Disallow: /*.doc$
Niet toestaan: /*.xls$
Specifieke bots blokkeren
Niet alle crawlers zijn welkom. Sommige scrapen inhoud, sommige zijn kwaadaardig en andere verspillen bronnen zonder waarde toe te voegen:
Gebruiker-agent: AhrefsBot
Niet toestaan: /
Gebruiker-agent: SemrushBot
Niet toestaan: /
User-agent: *
Niet toestaan: /admin/
Hierdoor worden specifieke SEO-tool crawlers geblokkeerd, terwijl de belangrijkste zoekmachines wel worden toegelaten.
Beste praktijken voor Robots.Txt-bestanden
Het maken van een effectief robots.txt-bestand vereist het volgen van vastgestelde richtlijnen en het vermijden van veelvoorkomende valkuilen.
Locatie en toegankelijkheid
Het robots.txt-bestand moet in de hoofddirectory van het domein worden geplaatst. Het werkt niet in submappen. Voor example.com moet het bestand staan op example.com/robots.txt, niet op example.com/pages/robots.txt.
Het bestand moet toegankelijk zijn via HTTP/HTTPS. Volgens Google's interpretatie van de robots.txt-specificatie, als het bestand een 404-fout retourneert, neemt Google aan dat er geen crawlbeperkingen bestaan en gaat over tot het crawlen van alles.
Gevoeligheid van hoofdletters en kleine letters
Directives zijn hoofdlettergevoelig. Niet toestaan: /Admin/ blokkeert /admin/ niet. Gebruik altijd kleine letters voor consistentie, tenzij specifiek hoofdlettergebruik vereist is.
Wildcard en patroonmatching
De moderne robots.txt-syntax ondersteunt jokertekens voor flexibelere regels:
| Patroon | Betekenis | Voorbeeld |
|---|---|---|
| * | Komt overeen met elke reeks | Niet toestaan: /*.jpg$ blokkeert alle JPG-bestanden |
| $ | Einde URL | Niet toestaan: /*.pdf$ blokkeert PDF's, maar niet /file.pdf?v=1 |
Testen vóór implementatie
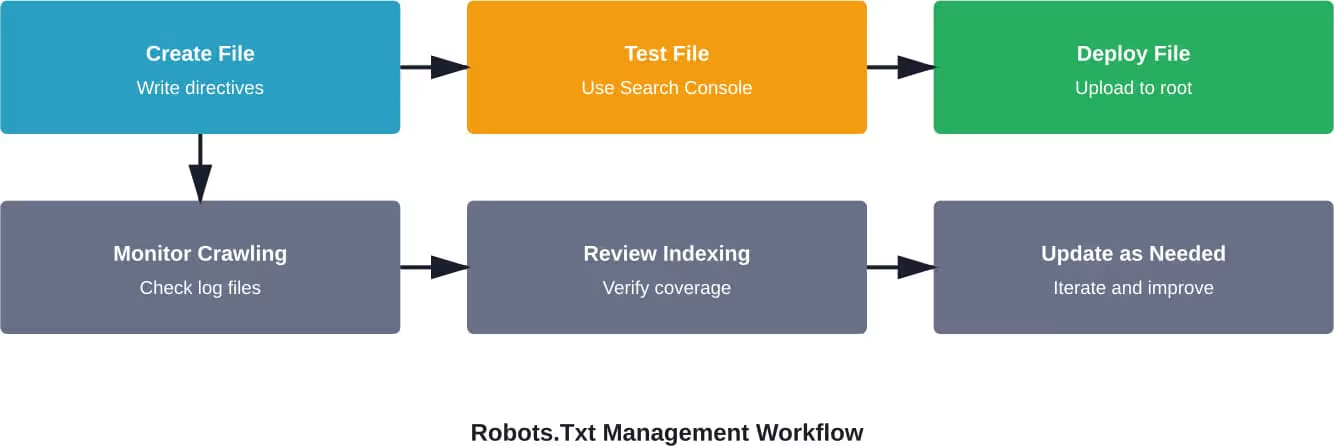
Gebruik robots.txt nooit zonder te testen. Google Search Console bevat een robots.txt-tester die precies laat zien hoe Googlebot het bestand interpreteert. Fouten hier kunnen catastrofaal zijn - het per ongeluk blokkeren van de hele site is grote bedrijven overkomen.
De kruipvertragingsrichtlijn
Hoewel niet officieel ondersteund door Google, erkennen Bing en andere zoekmachines de crawlvertragingsrichtlijn. Volgens de Bing Webmaster Blog regelt deze het tempo waarin bots een site crawlen:
User-agent: *
Kruipvertraging: 10
Dit vertelt bots om 10 seconden te wachten tussen verzoeken. Gebruik dit spaarzaam - de meeste sites hebben dit niet nodig en het kan de indexering vertragen.
Robots.Txt Versus Meta Robots Tags
Inzicht in het verschil tussen robots.txt en meta robots tags voorkomt verwarring en indexeringsfouten.
Robots.txt controleert het crawlen - of bots toegang hebben tot een pagina. Meta robots tags bepalen de indexering - of een pagina wordt weergegeven in zoekresultaten.
Deze twee mechanismen werken onafhankelijk van elkaar:
| Scenario | Robots.Tekst | Meta Tag | Resultaat |
|---|---|---|---|
| Crawling en indexering blokkeren | Niet toestaan: /pagina/ | N.V.T. | Pagina niet gecrawld; kan nog steeds verschijnen in resultaten indien extern gelinkt |
| Crawling toestaan, indexering voorkomen | Sta toe. | noindex | Pagina gecrawld maar niet geïndexeerd |
| Crawling blokkeren, indexering voorkomen | Niet toestaan: /pagina/ | noindex | Probleem: bot ziet noindex-tag niet omdat crawlen wordt geblokkeerd |
Dit is de cruciale fout die u moet vermijden: een pagina blokkeren in robots.txt en tegelijkertijd een noindex-tag gebruiken. De bot ziet de noindex-instructie nooit omdat de toegang tot de pagina wordt geblokkeerd. Als externe links naar die URL verwijzen, kan deze nog steeds in de zoekresultaten verschijnen.
Volgens de documentatie van Google Search Central over meta-robot-tags is de juiste aanpak om indexering te voorkomen om crawling toe te staan, zodat bots de noindex-richtlijn kunnen lezen.
Veelvoorkomende fouten in Robots.Txt die SEO schade toebrengen
Zelfs ervaren ontwikkelaars maken fouten in robots.txt. Deze fouten hebben ernstige gevolgen.
CSS- en JavaScript-bestanden blokkeren
Jaren geleden raadden sommige SEO's aan om CSS en JavaScript te blokkeren in robots.txt. Dit wordt nu als schadelijk beschouwd. Google moet pagina's volledig renderen om de inhoud en gebruikerservaring te begrijpen.
Het blokkeren van deze bronnen kan resulteren in:
- Verkeerde beoordelingen van mobiele vriendelijkheid
- Het niet detecteren van inhoud boven de vouw
- Onbegrip voor paginaopmaak en bruikbaarheid
Google raadt expliciet af om CSS- en JavaScript-bestanden te blokkeren.
Per ongeluk de hele site blokkeren
Eén typefout kan verwoestend zijn:
User-agent: *
Niet toestaan: /
Dit blokkeert alles. Het gebeurt vaker dan zou moeten, tijdens migraties van sites, bij het bijwerken van bestanden of wanneer iemand die niet bekend is met de syntax wijzigingen aanbrengt.
Test altijd eerst in een staging-omgeving.
Robots.Txt gebruiken om gevoelige informatie te verbergen
Robots.txt is openbaar toegankelijk. Iedereen kan het robots.txt-bestand van een site bekijken door domain.com/robots.txt te bezoeken. Door het te gebruiken om gevoelige directories te verbergen, adverteert u in feite hun bestaan.
Gebruik voor echt gevoelige inhoud de juiste verificatie en toegangscontrole, niet robots.txt.
De verschillen tussen subdomeinen vergeten
Elk subdomein heeft zijn eigen robots.txt-bestand nodig. Het bestand op example.com/robots.txt is niet van toepassing op blog.example.com. Voor elk subdomein zijn aparte bestanden nodig.
Hoe zoekmachines omgaan met Robots.Txt-fouten
Wat gebeurt er wanneer een robots.txt-bestand fouten bevat of niet kan worden geopend?
Volgens Google's interpretatie van de robots.txt-specificatie leiden verschillende HTTP-statuscodes tot verschillend gedrag:
| Statuscode | Antwoord van Google |
|---|---|
| 404 (niet gevonden) | Neemt aan dat er geen beperkingen zijn; kruipt overal doorheen |
| 5xx (Serverfout) | Stopt 12 uur lang met crawlen; blijft proberen het bestand op te halen |
| 403 (Verboden) | Behandelt als Disallow: / en blokkeert alle crawling |
Serverfouten zijn bijzonder problematisch. Als een site downtime heeft en robots.txt een 5xx-fout geeft, stopt Google 12 uur lang met crawlen. Herhaalde fouten kunnen leiden tot langdurige crawlpauzes.
Robots.Txt en moderne SEO uitdagingen
AI-crawlers en grote taalmodellen
Er zijn nieuwe soorten crawlers ontstaan voor het trainen van AI-modellen en grote taalmodellen. Bedrijven als OpenAI, Anthropic en anderen zetten bots in om webinhoud te scrapen.
Deze crawlers respecteren vaak robots.txt, maar niet altijd. Sommige AI-bedrijven hebben specifieke gebruikersagenten geïntroduceerd:
- GPTBot (OpenAI)
- CCBot (Common Crawl)
- antropisch-ai (Antropisch)
Site-eigenaren die zich zorgen maken over AI-training op hun inhoud, kunnen deze specifiek blokkeren:
Gebruiker-agent: GPTBot
Niet toestaan: /
Gebruiker-agent: CCBot
Niet toestaan: /
Maar hier zit het addertje onder het gras: niet alle AI-systemen identificeren zichzelf duidelijk en sommige houden zich niet aan de robots.txt-richtlijnen.
Overwegingen voor mobiel-eerste indexering
Met mobile-first indexing gebruikt Google voornamelijk de mobiele versie van inhoud voor indexering en ranking. Het robots.txt-bestand voor mobiel moet crawlen van bronnen die nodig zijn voor mobiele weergave toestaan.
Als er afzonderlijke mobiele URL's bestaan (m.example.com), heeft dat subdomein zijn eigen robots.txt-configuratie nodig.
Hulpmiddelen voor het beheren en testen van robots.txt
Verschillende tools helpen bij het maken, valideren en controleren van robots.txt-bestanden:
Google Search Console Robots.Txt-tester
Deze gratis tool laat precies zien hoe Googlebot een robots.txt-bestand interpreteert. Het markeert syntaxfouten en maakt het mogelijk om specifieke URL's aan de regels te toetsen.
Bing Webmasterhulpprogramma's
Net als de tool van Google biedt Bing validatie- en testfuncties binnen hun webmasterplatform.
Online Robots.Txt Genereerders
Voor degenen die niet bekend zijn met syntaxis, bieden generatoren sjablonen en interactieve interfaces voor het maken van robots.txt-bestanden. Deze verminderen het risico op syntaxisfouten.
Analyse logbestanden
Het analyseren van serverlogs laat zien hoe crawlers zich werkelijk gedragen. Tools zoals Screaming Frog Log Analyzer of Botify laten zien welke bots bezoeken, welke pagina's ze openen en of robots.txt-richtlijnen worden nageleefd.
Voorbeelden van echte-wereld robots.txt
Kijken naar hoe grote websites hun robots.txt-bestanden structureren biedt praktische inzichten.
Eenvoudige blog of kleine bedrijfssite
User-agent: *
Niet toestaan: /wp-admin/
Toestaan: /wp-admin/admin-ajax.php
Niet toestaan: /wp-login.php
Niet toestaan: /cart/
Niet toestaan: /kassa/
Sitemap: https://example.com/sitemap.xml
Dit WordPress voorbeeld blokkeert beheergebieden en e-commerce kassa's terwijl al het andere wel wordt toegestaan.
Grote e-commerce site
User-agent: *
Niet toestaan: /zoeken
Niet toestaan: /*?*sort=
Niet toestaan: /*?*filter=
Niet toestaan: /cart
Niet toestaan: /kassa
Niet toestaan: /account
Disallow: /*.pdf$
Gebruiker-agent: AhrefsBot
Niet toestaan: /
Sitemap: https://store.example.com/sitemap.xml
Sitemap: https://store.example.com/products-sitemap.xml
Nieuws of publicatiesite
User-agent: *
Niet toestaan: /zoeken
Niet toestaan: /api/
Toestaan: /api/public/
Kruipvertraging: 10
Gebruiker-agent: Googlebot-News
Niet toestaan:
Sitemap: https://news.example.com/news-sitemap.xml
Dit geeft Google News crawlers onbeperkte toegang terwijl het andere bots beperkt.
Conclusie: Robots.Txt beheersen voor betere SEO
Ondanks het feit dat het robots.txt-bestand al meer dan 30 jaar oud is, blijft het een fundamenteel onderdeel van technische SEO. Het biedt nauwkeurige controle over hoe zoekmachines websites openen en crawlen, helpt overbelasting van de server te voorkomen, het crawlbudget te behouden en te voorkomen dat inhoud met een lage waarde wordt geïndexeerd.
Maar het is niet waterdicht. Als u begrijpt wat robots.txt wel en niet kan doen, voorkomt u veelgemaakte fouten die de SEO-prestaties schaden. Het controleert crawling-niet indexering. Het is publiekelijk zichtbaar - geen beveiligingsmaatregel. En het moet zorgvuldig worden getest voordat het wordt gebruikt.
De meest succesvolle aanpak combineert robots.txt met andere hulpmiddelen: noindex-tags om het indexeren te controleren, een goede site-architectuur om de crawlefficiëntie te beheren en regelmatige controle via logbestandanalyse en webmasterhulpprogramma's.
Naarmate zoekmachines zich ontwikkelen en er nieuwe soorten crawlers verschijnen - met name AI-trainingsbots - blijftrobots.txt zich aanpassen. Door op de hoogte te blijven van de specificaties en best practices, behouden websites de controle over de manier waarop geautomatiseerde systemen met hun inhoud omgaan.
Begin met het controleren van bestaande robots.txt-configuraties. Test grondig met Google Search Console en Bing Webmaster Tools. Controleer het crawlgedrag met behulp van logbestanden. En het allerbelangrijkste: documenteer alle wijzigingen zodat toekomstige updates niet per ongeluk kritieke richtlijnen afbreken.
Klaar om crawling te optimaliseren voor betere SEO prestaties? Controleer vandaag nog uw robots.txt-bestand en zorg ervoor dat het overeenkomt met de huidige best practices.