


Kurze Zusammenfassung: Eine robots.txt-Datei ist eine einfache Textdatei im Stammverzeichnis einer Website, die Suchmaschinen-Crawlern mitteilt, auf welche Seiten oder Abschnitte sie zugreifen können und auf welche nicht. Sie wird in erster Linie verwendet, um den Crawler-Verkehr zu steuern und eine Überlastung des Servers zu verhindern, nicht um Seiten aus den Suchergebnissen auszublenden. Laut Google Search Central hilft robots.txt bei der Kontrolle, wie Suchmaschinen Ihre Website crawlen, aber um Seiten tatsächlich von der Anzeige in den Suchergebnissen auszuschließen, benötigen Sie stattdessen noindex-Tags oder einen Passwortschutz.
Suchmaschinen schicken jeden Tag automatisierte Bots zum Crawlen von Websites. Diese Crawler indizieren Inhalte, verfolgen Links und entscheiden, was in den Suchergebnissen erscheint. Die Sache ist jedoch die: Nicht jede Seite einer Website muss gecrawlt werden. Manche Seiten verschwenden Crawler-Ressourcen, und manche sollten überhaupt nicht indiziert werden.
Hier kommt die robots.txt ins Spiel.
Diese kleine Textdatei gibt den Webcrawlern Anweisungen, auf welche Teile einer Website sie zugreifen können. Es gibt sie schon seit den frühen 1990er Jahren und sie ist nach wie vor ein grundlegender Bestandteil der technischen SEO. Wenn Sie verstehen, wie robots.txt funktioniert, können Sie Indexierungskatastrophen verhindern, die Crawling-Effizienz verbessern und sensible Bereiche einer Website schützen.
Lassen Sie uns genau aufschlüsseln, was robots.txt ist, wie es funktioniert und warum es für SEO im Jahr 2026 wichtig ist.
Verstehen der Datei Robots.Txt
Laut Google Search Central teilt eine robots.txt-Datei den Suchmaschinen-Crawlern mit, auf welche URLs der Crawler auf einer Website zugreifen kann. Sie wird in erster Linie verwendet, um den Crawler-Verkehr zu verwalten und eine Überlastung der Server mit Anfragen zu vermeiden.
Die Datei befindet sich im Stammverzeichnis einer Website. Bei einer Website wie example.com würde sich die robots.txt-Datei unter example.com/robots.txt befinden. Suchmaschinen überprüfen diesen Ort, bevor sie andere Seiten crawlen.
Das Besondere an robots.txt ist, dass es sich um eine reine Textdatei handelt, die dem Robots Exclusion Protocol (REP) folgt. Das REP ist aus einem Konsens aus dem Jahr 1994 hervorgegangen und wird heute von den großen Suchmaschinen wie Google, Bing und anderen anerkannt.
Wie Robots.Txt tatsächlich funktioniert
Wenn ein Suchmaschinen-Bot eine Website crawlen will, folgt er einer bestimmten Reihenfolge:
- Der Bot versucht, auf die robots.txt-Datei der Stammdomäne zuzugreifen
- Wenn die Datei existiert, liest und analysiert der Bot die Anweisungen
- Der Bot befolgt die Richtlinien, die für seinen User-Agent gelten
- Erst dann werden die erlaubten Seiten gecrawlt.
Nach Angaben von robotstxt.org entstand der Standard 1994 aus einem Konsens zwischen Robot-Autoren und interessierten Parteien. Technisch gesehen ist er freiwillig - die Bots entscheiden, ob sie ihn respektieren -, aber alle seriösen Suchmaschinen beachten die robots.txt-Richtlinien.

Was Robots.Txt tun kann und was nicht
Es gibt ein weit verbreitetes Missverständnis über robots.txt. Viele Website-Besitzer denken, dass sie das Erscheinen von Seiten in den Suchergebnissen verhindert. Das ist aber nicht der Fall.
Google Search Central weist ausdrücklich darauf hin, dass robots.txt kein Mechanismus ist, um Webseiten von Google fernzuhalten. Wenn andere Websites auf eine gesperrte Seite verlinken, kann diese immer noch in den Suchergebnissen erscheinen - nur ohne eine Beschreibung.
Um die Indizierung tatsächlich zu verhindern, müssen Websites verwenden:
- Noindex-Meta-Tags in der HTML-Seite
- X-Robots-Tag HTTP-Header
- Passwortschutz oder Authentifizierungsanforderungen
Robots.txt steuert das Crawling-Verhalten, nicht die Indexierung. Das ist ein entscheidender Unterschied.
Die Grundsyntax von Robots.Txt
Die robots.txt-Datei verwendet eine unkomplizierte Syntax. Auch ohne technische Kenntnisse ist das Format lesbar und logisch.
Hier ist ein einfaches Beispiel:
Benutzer-Agent: *
Nicht zulassen: /admin/
Nicht zulassen: /temp/
Erlauben: /temp/public/
Inhaltsverzeichnis: https://www.example.com/sitemap.xml
Lassen Sie uns die einzelnen Teile entschlüsseln.
User-Agent-Richtlinie
Die User-Agent-Zeile gibt an, für welchen Crawler die folgenden Regeln gelten. Das Sternchen (*) steht für alle Bots. Bestimmte Bots können mit ihrem Namen angesprochen werden:
- Googlebot (der wichtigste Crawler von Google)
- Googlebot-Image (Googles Bild-Crawler)
- Bingbot (der Crawler von Microsoft Bing)
- AhrefsBot (Ahrefs SEO Werkzeug Crawler)
In einer Datei können mehrere User-Agent-Abschnitte vorhanden sein, die jeweils unterschiedliche Regeln haben.
Richtlinie verbieten
Die Disallow-Direktive teilt Bots mit, auf welche URLs oder Pfade sie nicht zugreifen können. Ein paar Beispiele:
| Richtlinie | Was es blockiert |
|---|---|
| Nicht zulassen: /admin/ | Alle URLs, die mit /admin/ beginnen |
| Nicht zulassen: /*.pdf$ | Alle PDF-Dateien auf der gesamten Website |
| Nicht zulassen: / | Alles auf der Website |
| Nicht zulassen: | Nichts (erlaubt alles) |
Richtlinie zulassen
Die Allow-Direktive erzeugt Ausnahmen von Disallow-Regeln. Sie ist besonders nützlich, um den Zugriff auf bestimmte Unterverzeichnisse innerhalb gesperrter Abschnitte zu erlauben.
Zum Beispiel:
Benutzer-Agent: *
Nicht zulassen: /privat/
Zulassen: /privat/öffentliche-ressourcen/
Dies blockiert das gesamte Verzeichnis /private/ mit Ausnahme des Ordners /private/public-resources/.
Sitemap-Richtlinie
Die Aufnahme von Sitemap-Positionen hilft Suchmaschinen, wichtige Seiten effizienter zu finden und zu crawlen. Es können mehrere Sitemap-Zeilen hinzugefügt werden:
Inhaltsverzeichnis: https://example.com/sitemap.xml
Inhaltsverzeichnis: https://example.com/sitemap-images.xml
Laut der Google-Dokumentation gilt die Aufnahme von Sitemaps in die robots.txt als beste Praxis für die Crawl-Effizienz.
Warum Robots.Txt für SEO wichtig ist
Die Verwaltung der Art und Weise, wie Suchmaschinen eine Website crawlen, wirkt sich direkt auf die SEO-Leistung aus. Robots.txt bietet Kontrolle über diesen Prozess.
Verhindern von Crawl-Budget-Verschwendung
Suchmaschinen weisen jeder Website ein Crawl-Budget zu - die Anzahl der Seiten, die ihre Bots in einem bestimmten Zeitraum crawlen. Große Websites mit Tausenden von Seiten können dieses Budget für minderwertige Inhalte schnell aufbrauchen.
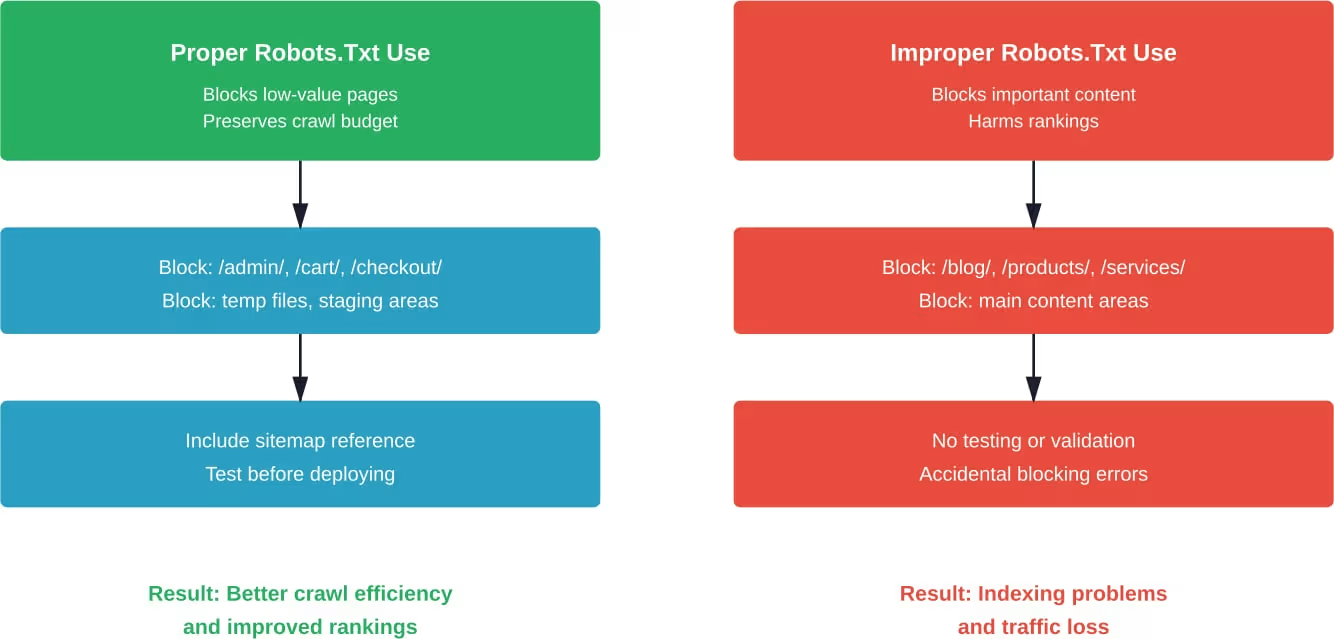
Die Verwendung von robots.txt, um Crawlern den Zugriff auf doppelte Seiten, Staging-Bereiche oder Verwaltungsbereiche zu verwehren, bewahrt das Crawl-Budget für wichtige Inhalte. Dies ist besonders wichtig für E-Commerce-Websites mit facettierter Navigation, die Tausende von URL-Variationen erzeugen.
Schutz der Server-Ressourcen
Aggressives Crawling kann die Serverressourcen belasten, insbesondere bei kleineren Websites oder solchen mit begrenztem Hosting. Laut Bing Webmaster Blog hilft die Steuerung der Crawl-Rate durch robots.txt (und Crawl-Verzögerungsrichtlinien) dabei, Probleme mit der Webserver-Auslastung zu lösen.
Hand aufs Herz: Wenn eine Website ausfällt, weil Bots sie mit Anfragen bombardieren, ist das ein SEO-Desaster. Die Rankings sinken, die Nutzer erhalten Fehlerseiten, und die Wiederherstellung braucht Zeit.
Vermeidung von Problemen mit doppeltem Inhalt
Wenn Suchmaschinen mehrere Versionen desselben Inhalts crawlen und indizieren, entstehen Probleme mit doppelten Inhalten. Google behauptet zwar, dass es mit Duplikaten gut umgehen kann, aber warum sollte man das riskieren?
Das Blockieren von URLs mit Parametern, Druckversionen oder Variationen der Sitzungs-IDs verhindert unnötige doppelte Indizierungen.
Technische SEO beheben und Sichtbarkeit verbessern
Das Verständnis von robots.txt ist nur ein Teil der technischen SEO, und LENGREO konzentriert sich auf die Optimierung des gesamten technischen Fundaments, um die Crawlability und die Rankings zu verbessern. Technische Probleme können selbst den besten Inhalt einschränken, daher ist eine solide Grundlage entscheidend für langfristigen SEO-Erfolg.
- Crawl- und Index-Optimierung
- Verbesserungen der Baustruktur
- Leistung und Geschwindigkeit
Wenn Sie technische Probleme lösen und die Sichtbarkeit in den Suchmaschinen verbessern wollen, Erhalten Sie eine kostenlose Beratung mit LENGREO.
Häufige Robots.Txt Anwendungsfälle
Verschiedene Websites haben unterschiedliche Bedürfnisse. Hier sind praktische Szenarien, in denen sich robots.txt als unerlässlich erweist.
Blockieren von Suchfunktionen und Filterseiten
E-Commerce-Websites generieren unzählige URLs durch facettierte Navigation - Filterung nach Größe, Farbe, Preisklasse und anderen Attributen. Jede Kombination erzeugt eine einzigartige URL, die den Linkwert verwässert und das Crawl-Budget verschwendet.
Beispiel für eine robots.txt für eine E-Commerce-Website:
Benutzer-Agent: *
Nicht zulassen: /*?filter=
Nicht zulassen: /*?sort=
Nicht zulassen: /search?*
Nicht zulassen: /cart
Nicht zulassen: /checkout
Schutz von Bereitstellungs- und Entwicklungsbereichen
Entwicklungsseiten, Staging-Umgebungen und Testbereiche sollten niemals in den Suchergebnissen erscheinen. Ihre Sperrung verhindert eine versehentliche Indizierung:
Benutzer-Agent: *
Nicht zulassen: /staging/
Nicht zulassen: /dev/
Nicht zulassen: /test/
Kontrolle des Crawlings von PDF- und Mediendateien
Einige Websites haben Hunderte von PDFs oder herunterladbare Ressourcen. Wenn diese nicht für die Sichtbarkeit bei der Suche bestimmt sind, sollten Sie sie blockieren:
Benutzer-Agent: *
Nicht zulassen: /*.pdf$
Nicht zulassen: /*.doc$
Nicht zulassen: /*.xls$
Blockieren bestimmter Bots
Nicht alle Crawler sind willkommen. Einige kratzen Inhalte ab, andere sind böswillig, und wieder andere verschwenden Ressourcen, ohne einen Mehrwert zu schaffen:
Benutzer-Agent: AhrefsBot
Nicht zulassen: /
Benutzer-Agent: SemrushBot
Nicht zulassen: /
Benutzer-Agent: *
Nicht zulassen: /admin/
Dies blockiert bestimmte SEO-Tool-Crawler, während die wichtigsten Suchmaschinen zugelassen werden.
Bewährte Praktiken für Robots.Txt-Dateien
Die Erstellung einer effektiven robots.txt-Datei erfordert die Befolgung etablierter Richtlinien und das Vermeiden gängiger Fallstricke.
Standort und Erreichbarkeit
Die robots.txt-Datei muss im Stammverzeichnis der Domäne abgelegt werden. Sie funktioniert nicht in Unterverzeichnissen. Bei example.com muss sich die Datei unter example.com/robots.txt befinden, nicht unter example.com/pages/robots.txt.
Die Datei muss über HTTP/HTTPS zugänglich sein. Nach Googles Auslegung der robots.txt-Spezifikation geht Google davon aus, dass keine Crawling-Beschränkungen bestehen, wenn die Datei einen 404-Fehler zurückgibt, und crawlt alles.
Groß- und Kleinschreibung ist wichtig
Bei Direktiven wird die Groß- und Kleinschreibung beachtet. Nicht zulassen: /Admin/ blockiert nicht /admin/. Verwenden Sie aus Gründen der Konsistenz immer Kleinbuchstaben, es sei denn, eine besondere Großschreibung ist erforderlich.
Platzhalter und Mustervergleiche
Die moderne robots.txt-Syntax unterstützt Wildcards für flexiblere Regeln:
| Muster | Bedeutung | Beispiel |
|---|---|---|
| * | Entspricht einer beliebigen Sequenz | Nicht zulassen: /*.jpg$ blockiert alle JPG-Dateien |
| $ | Ende der URL | Nicht zulassen: /*.pdf$ blockiert PDFs, aber nicht /file.pdf?v=1 |
Tests vor der Bereitstellung
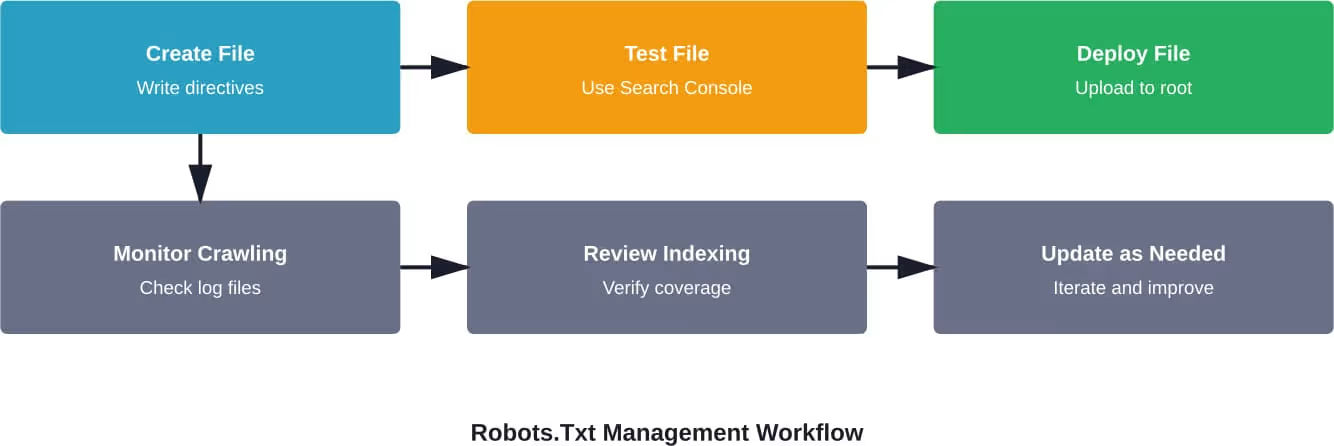
Setzen Sie die robots.txt niemals ohne Test ein. Die Google Search Console enthält einen robots.txt-Tester, der genau zeigt, wie Googlebot die Datei interpretiert. Fehler in diesem Bereich können katastrophale Folgen haben - großen Unternehmen ist es schon passiert, dass versehentlich die gesamte Website blockiert wurde.
Die Crawl-Delay-Richtlinie
Obwohl sie von Google nicht offiziell unterstützt wird, erkennen Bing und andere Suchmaschinen die Crawl-Delay-Direktive an. Laut dem Bing-Webmaster-Blog wird damit die Geschwindigkeit gesteuert, mit der Bots eine Website crawlen:
Benutzer-Agent: *
Kriechgang-Verzögerung: 10
Damit werden die Bots angewiesen, 10 Sekunden zwischen den Anfragen zu warten. Verwenden Sie diese Option sparsam - die meisten Websites benötigen sie nicht, und sie kann die Indizierung verlangsamen.
Robots.Txt vs. Meta-Robots-Tags
Die Kenntnis des Unterschieds zwischen robots.txt und Meta-Robots-Tags verhindert Verwirrung und Indizierungsfehler.
Robots.txt kontrolliert das Crawling - ob Bots auf eine Seite zugreifen können. Meta-Robots-Tags steuern die Indizierung - ob eine Seite in den Suchergebnissen erscheint.
Diese beiden Mechanismen funktionieren unabhängig voneinander:
| Szenario | Roboter.Txt | Meta-Tag | Ergebnis |
|---|---|---|---|
| Crawling und Indizierung blockieren | Nicht zulassen: /page/ | K.A. | Seite nicht gecrawlt; kann dennoch in den Ergebnissen erscheinen, wenn sie extern verlinkt ist |
| Crawling zulassen, Indizierung verhindern | Erlauben Sie | noindex | Seite gecrawlt, aber nicht indiziert |
| Crawling blockieren, Indizierung verhindern | Nicht zulassen: /page/ | noindex | Problem: Der Bot kann das noindex-Tag nicht sehen, weil es für das Crawling blockiert ist |
Der entscheidende Fehler, den es zu vermeiden gilt, ist die Sperrung einer Seite in robots.txt bei gleichzeitiger Verwendung eines noindex-Tags. Der Bot sieht die noindex-Anweisung nie, weil der Zugriff auf die Seite blockiert ist. Wenn externe Links auf diese URL verweisen, kann sie dennoch in den Suchergebnissen erscheinen.
Laut der Google Search Central-Dokumentation zu Meta-Robots-Tags besteht der richtige Ansatz zur Verhinderung der Indexierung darin, das Crawling zuzulassen, damit Bots die noindex-Direktive lesen können.
Häufige Robots.Txt-Fehler, die SEO schaden
Selbst erfahrenen Entwicklern unterlaufen robots.txt-Fehler. Diese Fehler haben schwerwiegende Folgen.
Blockieren von CSS- und JavaScript-Dateien
Vor Jahren haben einige SEOs empfohlen, CSS und JavaScript in der robots.txt zu blockieren. Dies wird jetzt als schädlich angesehen. Google muss die Seiten vollständig rendern, um den Inhalt und die Nutzererfahrung zu verstehen.
Die Blockierung dieser Ressourcen kann dazu führen:
- Falsche Bewertung der Handyfreundlichkeit
- Fehlender Nachweis von Inhalten oberhalb der Falz
- Falsches Verständnis von Seitenlayout und Benutzerfreundlichkeit
Google rät ausdrücklich davon ab, CSS- und JavaScript-Dateien zu blockieren.
Versehentliches Blockieren der gesamten Website
Ein einziger Tippfehler kann verheerend sein:
Benutzer-Agent: *
Nicht zulassen: /
Dies blockiert alles. Das passiert häufiger, als es sollte - bei der Migration von Websites, bei der Aktualisierung von Dateien oder wenn jemand, der mit der Syntax nicht vertraut ist, Änderungen vornimmt.
Testen Sie immer zuerst in einer Staging-Umgebung.
Verwendung von Robots.Txt zum Verbergen sensibler Informationen
Robots.txt ist öffentlich zugänglich. Jeder kann die robots.txt-Datei einer Website einsehen, indem er domain.com/robots.txt besucht. Die Verwendung dieser Datei zum Ausblenden sensibler Verzeichnisse bedeutet, dass ihre Existenz bekannt gemacht wird.
Für wirklich sensible Inhalte sollten Sie eine angemessene Authentifizierung und Zugangskontrolle verwenden, nicht robots.txt.
Vergessen der Unterschiede zwischen Subdomains
Jede Subdomain benötigt ihre eigene robots.txt-Datei. Die Datei unter example.com/robots.txt gilt nicht für blog.example.com. Für jede Subdomain sind separate Dateien erforderlich.
Wie Suchmaschinen mit Robots.Txt-Fehlern umgehen
Was passiert, wenn eine robots.txt-Datei fehlerhaft ist oder nicht aufgerufen werden kann?
Nach Googles Interpretation der robots.txt-Spezifikation lösen unterschiedliche HTTP-Statuscodes unterschiedliche Verhaltensweisen aus:
| Status Code | Googles Antwort |
|---|---|
| 404 (Nicht gefunden) | Nimmt keine Einschränkungen an; krabbelt alles |
| 5xx (Serverfehler) | 12 Stunden lang kein Crawling mehr; versucht weiterhin, die Datei zu holen |
| 403 (Verboten) | Wird als Disallow behandelt: / und blockiert alles Crawling |
Serverfehler sind besonders problematisch. Wenn eine Website ausfällt und die robots.txt einen 5xx-Fehler zurückgibt, stellt Google das Crawling für 12 Stunden komplett ein. Wiederholte Fehler können zu verlängerten Crawling-Pausen führen.
Robots.Txt und moderne SEO-Herausforderungen
AI Crawler und große Sprachmodelle
Es sind neue Arten von Crawlern für das Training von KI-Modellen und großen Sprachmodellen entstanden. Unternehmen wie OpenAI, Anthropic und andere setzen Bots zum Scrapen von Webinhalten ein.
Diese Crawler respektieren oft robots.txt, aber nicht immer. Einige KI-Unternehmen haben spezielle Benutzer-Agenten eingeführt:
- GPTBot (OpenAI)
- CCBot (Common Crawl)
- anthropisch-ai (anthropisch)
Website-Besitzer, die sich Sorgen über KI-Training auf ihren Inhalten machen, können diese gezielt blockieren:
Benutzer-Agent: GPTBot
Nicht zulassen: /
Benutzer-Agent: CCBot
Nicht zulassen: /
Der Haken an der Sache ist jedoch, dass sich nicht alle KI-Systeme eindeutig zu erkennen geben und dass einige die robots.txt-Richtlinien nicht beachten.
Überlegungen zur Mobile-First-Indizierung
Beim Mobile-First-Indexing verwendet Google in erster Linie die mobile Version des Inhalts für die Indexierung und das Ranking. Die robots.txt-Datei für Mobilgeräte muss das Crawlen der für die mobile Darstellung erforderlichen Ressourcen erlauben.
Wenn separate mobile URLs existieren (m.example.com), benötigt diese Subdomain eine eigene robots.txt-Konfiguration.
Werkzeuge zur Verwaltung und Prüfung von Robotern.Txt
Mehrere Tools helfen bei der Erstellung, Validierung und Überwachung von robots.txt-Dateien:
Google Search Console Robots.Txt Tester
Dieses kostenlose Tool zeigt genau, wie Googlebot eine robots.txt-Datei interpretiert. Es hebt Syntaxfehler hervor und ermöglicht das Testen bestimmter URLs anhand der Regeln.
Bing Webmaster-Tools
Ähnlich wie das Google-Tool bietet auch Bing innerhalb seiner Webmaster-Plattform Validierungs- und Testfunktionen an.
Online-Roboter.Txt-Generatoren
Für diejenigen, die mit der Syntax nicht vertraut sind, bieten Generatoren Vorlagen und interaktive Schnittstellen für die Erstellung von robots.txt-Dateien. Dadurch wird das Risiko von Syntaxfehlern verringert.
Analyse von Protokolldateien
Die Analyse von Serverprotokollen zeigt, wie sich Crawler tatsächlich verhalten. Tools wie Screaming Frog Log Analyzer oder Botify zeigen, welche Bots die Website besuchen, auf welche Seiten sie zugreifen und ob die robots.txt-Richtlinien eingehalten werden.
Real-World Robots.Txt Beispiele
Ein Blick darauf, wie große Websites ihre robots.txt-Dateien strukturieren, liefert praktische Erkenntnisse.
Einfacher Blog oder Website für kleine Unternehmen
Benutzer-Agent: *
Nicht zulassen: /wp-admin/
Zulassen: /wp-admin/admin-ajax.php
Nicht zulassen: /wp-login.php
Nicht zulassen: /cart/
Nicht zulassen: /checkout/
Inhaltsverzeichnis: https://example.com/sitemap.xml
Dieses WordPress-Beispiel blockiert den Verwaltungsbereich und die E-Commerce-Kasse, lässt aber alles andere zu.
Große E-Commerce-Website
Benutzer-Agent: *
Nicht zulassen: /search
Nicht zulassen: /*?*sort=
Nicht zulassen: /*?*filter=
Nicht zulassen: /cart
Nicht zulassen: /checkout
Nicht zulassen: /Konto
Nicht zulassen: /*.pdf$
Benutzer-Agent: AhrefsBot
Nicht zulassen: /
Inhaltsverzeichnis: https://store.example.com/sitemap.xml
Inhaltsverzeichnis: https://store.example.com/products-sitemap.xml
Nachrichten oder Verlagsseite
Benutzer-Agent: *
Nicht zulassen: /search
Nicht zulassen: /api/
Erlauben: /api/public/
Kriechgang-Verzögerung: 10
Benutzer-Agent: Googlebot-News
Nicht zulassen:
Inhaltsverzeichnis: https://news.example.com/news-sitemap.xml
Dies ermöglicht den Google News-Crawlern uneingeschränkten Zugang, während andere Bots eingeschränkt werden.
Schlussfolgerung: Beherrschung von Robots.Txt für bessere SEO
Die robots.txt-Datei ist nach wie vor ein grundlegender Bestandteil der technischen Suchmaschinenoptimierung, obwohl sie schon über 30 Jahre alt ist. Sie bietet eine genaue Kontrolle darüber, wie Suchmaschinen auf Websites zugreifen und diese crawlen, und hilft dabei, eine Überlastung des Servers zu verhindern, das Crawl-Budget zu schonen und die Indizierung minderwertiger Inhalte zu vermeiden.
Aber es ist nicht narrensicher. Wenn Sie verstehen, was robots.txt tun kann und was nicht, können Sie häufige Fehler vermeiden, die der SEO-Leistung schaden. Es kontrolliert das Crawling, nicht die Indizierung. Sie ist öffentlich sichtbar und keine Sicherheitsmaßnahme. Und sie muss vor dem Einsatz sorgfältig getestet werden.
Der erfolgreichste Ansatz kombiniert robots.txt mit anderen Werkzeugen: noindex-Tags zur Kontrolle der Indizierung, eine angemessene Website-Architektur zur Steuerung der Crawl-Effizienz und regelmäßige Überwachung durch Analyse der Protokolldateien und Webmaster-Tools.
Da sich Suchmaschinen weiterentwickeln und neue Arten von Crawlern auftauchen - insbesondere KI-Trainingsbots - wird die robots.txt ständig angepasst. Wenn Sie mit den Spezifikationen und bewährten Verfahren auf dem Laufenden bleiben, behalten Websites die Kontrolle darüber, wie automatisierte Systeme mit ihren Inhalten interagieren.
Beginnen Sie mit der Überprüfung der bestehenden robots.txt-Konfigurationen. Testen Sie gründlich mit Google Search Console und Bing Webmaster Tools. Überwachen Sie das Crawling-Verhalten anhand von Protokolldateien. Und das Wichtigste: Dokumentieren Sie alle Änderungen, damit künftige Aktualisierungen nicht versehentlich kritische Direktiven zerstören.
Sind Sie bereit, das Crawling für eine bessere SEO-Leistung zu optimieren? Überprüfen Sie noch heute Ihre robots.txt-Datei und stellen Sie sicher, dass sie mit den aktuellen Best Practices übereinstimmt.









