


Resumen rápido: Un archivo robots.txt es un archivo de texto sin formato situado en el directorio raíz de un sitio web que indica a los rastreadores de los motores de búsqueda a qué páginas o secciones pueden o no acceder. Se utiliza principalmente para gestionar el tráfico de rastreadores y evitar la sobrecarga del servidor, no para ocultar páginas de los resultados de búsqueda. Según Google Search Central, robots.txt ayuda a controlar la forma en que los motores de búsqueda rastrean su sitio, pero para bloquear realmente las páginas de los resultados de búsqueda, necesita etiquetas noindex o protección por contraseña.
Los motores de búsqueda envían robots automatizados a rastrear sitios web todos los días. Estos rastreadores indexan contenidos, siguen enlaces y deciden qué aparece en los resultados de búsqueda. Pero no es necesario rastrear todas las páginas de un sitio web. Algunas páginas malgastan los recursos del rastreador y otras no deberían indexarse en absoluto.
Ahí es donde entra en juego robots.txt.
Este pequeño archivo de texto da instrucciones a los rastreadores web sobre las partes de un sitio a las que pueden acceder. Existe desde principios de los 90 y sigue siendo una parte fundamental del SEO técnico. Entender cómo funciona robots.txt puede evitar desastres de indexación, mejorar la eficiencia de rastreo y mantener protegidas las áreas sensibles de un sitio web.
Analicemos qué es exactamente robots.txt, cómo funciona y por qué es importante para el SEO en 2026.
Comprender el archivo Robots.Txt
Según Google Search Central, un archivo robots.txt indica a los rastreadores de los motores de búsqueda a qué URL pueden acceder en un sitio. Se utiliza principalmente para gestionar el tráfico de rastreadores y evitar sobrecargar los servidores con peticiones.
El archivo se encuentra en el directorio raíz de un sitio web. Para un sitio como ejemplo.com, el archivo robots.txt se ubicaría en ejemplo.com/robots.txt. Los motores de búsqueda comprueban esta ubicación antes de rastrear cualquier otra página.
Esto es lo que hace único a robots.txt: es un archivo de texto sin formato que sigue el Protocolo de Exclusión de Robots (REP). El REP surgió de un consenso en 1994 y ahora está ampliamente reconocido por los principales motores de búsqueda, incluidos Google, Bing y otros.
Cómo funciona Robots.Txt
Cuando un robot de un motor de búsqueda quiere rastrear un sitio web, sigue una secuencia específica:
- El bot intenta acceder al archivo robots.txt en el dominio raíz
- Si el archivo existe, el bot lee y analiza las instrucciones
- El bot sigue las directivas que se aplican a su user-agent
- Sólo entonces procede a rastrear las páginas permitidas
Según robotstxt.org, la norma surgió de un consenso entre autores de robots y partes interesadas en 1994. Técnicamente es voluntaria -los robots eligen respetarla-, pero todos los motores de búsqueda legítimos respetan las directivas robots.txt.

Qué puede y qué no puede hacer Robots.Txt
Existe una idea errónea sobre robots.txt. Muchos propietarios de sitios piensan que impide que las páginas aparezcan en los resultados de búsqueda. Pero no es así.
Google Search Central afirma explícitamente que robots.txt no es un mecanismo para mantener las páginas web fuera de Google. Si otros sitios enlazan a una página bloqueada, ésta puede seguir apareciendo en los resultados de búsqueda, aunque sin una descripción.
Para evitar realmente la indexación, los sitios deben utilizar:
- Etiquetas meta noindex en el HTML de la página
- Cabeceras HTTP X-Robots-Tag
- Protección mediante contraseña o requisitos de autenticación
Robots.txt controla el rastreo, no la indexación. Es una distinción crucial.
La sintaxis básica de Robots.Txt
El archivo robots.txt utiliza una sintaxis sencilla. Incluso sin conocimientos técnicos, el formato es legible y lógico.
He aquí un ejemplo básico:
User-agent: *
No permitir: /admin/
No permitir: /temp/
Permitir: /temp/public/
Mapa del sitio: https://www.example.com/sitemap.xml
Descifremos cada parte.
Directiva User-Agent
La línea user-agent especifica a qué crawler se aplican las siguientes reglas. El asterisco (*) significa todos los robots. Se puede apuntar a bots específicos por su nombre:
- Googlebot (el rastreador principal de Google)
- Googlebot-Image (rastreador de imágenes de Google)
- Bingbot (rastreador de Microsoft Bing)
- AhrefsBot (rastreador de la herramienta SEO Ahrefs)
En un archivo pueden existir varias secciones de agente de usuario, cada una con reglas diferentes.
Directiva Disallow
La directiva Disallow indica a los robots a qué URLs o rutas no pueden acceder. Algunos ejemplos:
| Directiva | Qué bloquea |
|---|---|
| No permitir: /admin/ | Todas las URL que empiezan por /admin/ |
| No permitir: /*.pdf$ | Todos los archivos PDF del sitio |
| No permitir: / | Todo en el sitio |
| Rechazar: | Nada (permite todo) |
Permitir Directiva
La directiva Allow crea excepciones a las reglas Disallow. Es particularmente útil para permitir el acceso a subdirectorios específicos dentro de secciones bloqueadas.
Por ejemplo:
User-agent: *
No permitir: /privado/
Permitir: /recursos privados/públicos/
Esto bloquea todo el directorio /private/ excepto la carpeta /private/public-resources/.
Mapa del sitio Directiva
Incluir ubicaciones en el mapa del sitio ayuda a los motores de búsqueda a encontrar y rastrear las páginas importantes con mayor eficacia. Se pueden añadir varias líneas de mapa del sitio:
Mapa del sitio: https://example.com/sitemap.xml
Mapa del sitio: https://example.com/sitemap-images.xml
Según la documentación de Google, la inclusión de sitemaps en robots.txt se considera una práctica recomendada para mejorar la eficacia del rastreo.
Por qué Robots.Txt es importante para SEO
La gestión de cómo los motores de búsqueda rastrean un sitio web afecta directamente al rendimiento SEO. Robots.txt proporciona control sobre este proceso.
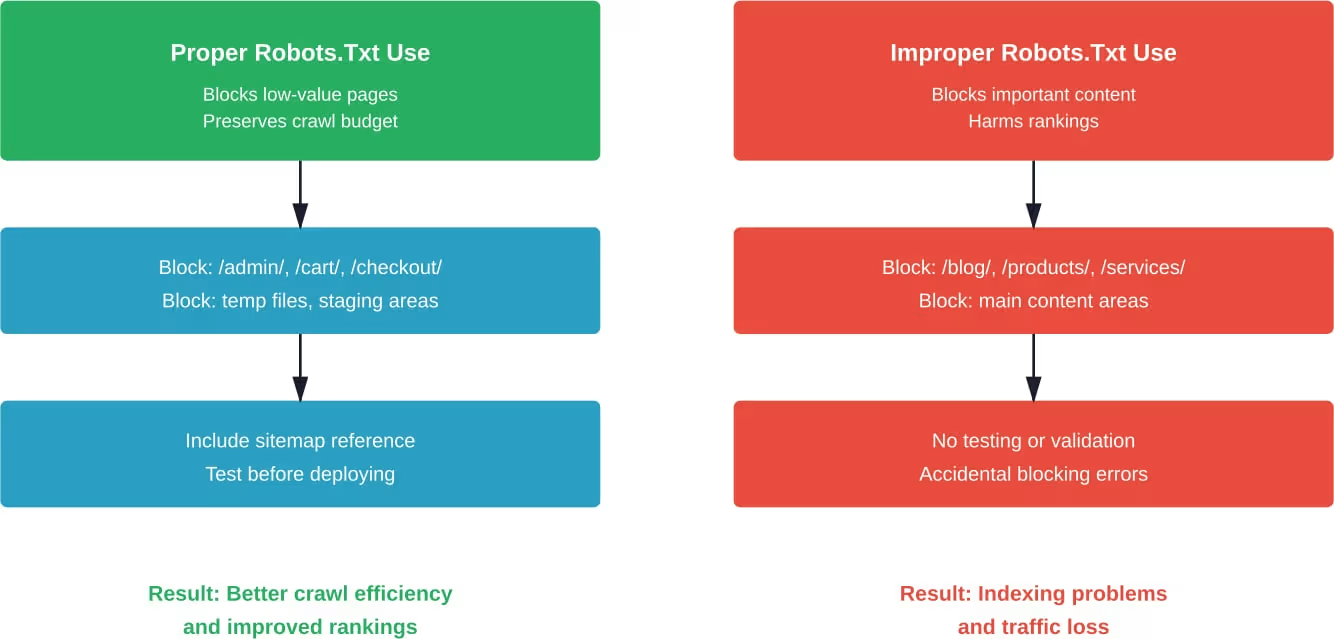
Evitar el despilfarro del presupuesto
Los motores de búsqueda asignan un presupuesto de rastreo a cada sitio: el número de páginas que sus robots rastrearán durante un periodo determinado. Los sitios grandes con miles de páginas pueden agotar rápidamente este presupuesto con contenidos de poco valor.
El uso de robots.txt para bloquear el acceso de los rastreadores a páginas duplicadas, áreas de preparación o secciones de administración preserva el presupuesto de rastreo para el contenido importante. Esto es especialmente importante en los sitios de comercio electrónico con navegación por facetas que crean miles de variaciones de URL.
Protección de los recursos del servidor
Un rastreo agresivo puede sobrecargar los recursos del servidor, especialmente en el caso de los sitios más pequeños o con un alojamiento limitado. Según el blog para webmasters de Bing, controlar la velocidad de rastreo mediante robots.txt (y directivas de retardo de rastreo) ayuda a solucionar los problemas de carga del servidor web.
Hablando claro: si un sitio se cae porque los robots lo están bombardeando con peticiones, es un desastre para el SEO. Las clasificaciones caen, los usuarios reciben páginas de error y la recuperación lleva tiempo.
Evitar problemas de contenido duplicado
Cuando los motores de búsqueda rastrean e indexan varias versiones del mismo contenido, surgen problemas de contenido duplicado. Aunque Google afirma que gestiona bien los duplicados, ¿por qué arriesgarse?
El bloqueo de URL basadas en parámetros, versiones de impresión o variaciones del ID de sesión evita la indexación duplicada innecesaria.
Corregir el SEO técnico y mejorar la visibilidad
Comprender el archivo robots.txt es sólo una parte del SEO técnico, y LENGREO se centra en optimizar toda la base técnica para mejorar la rastreabilidad y la clasificación. Los problemas técnicos pueden limitar incluso el mejor contenido, por lo que tener una base sólida es fundamental para el éxito SEO a largo plazo.
- optimización del rastreo y del índice
- mejoras en la estructura del emplazamiento
- rendimiento y velocidad
Si desea resolver problemas técnicos y mejorar la visibilidad en las búsquedas, consulta gratuita con LENGREO.
Casos comunes de uso de Robots.Txt
Diferentes sitios web tienen diferentes necesidades. Estos son algunos casos prácticos en los que robots.txt resulta esencial.
Bloqueo de funciones de búsqueda y páginas de filtro
Los sitios de comercio electrónico generan innumerables URL a través de la navegación por facetas, filtrando por tamaño, color, gama de precios y otros atributos. Cada combinación crea una URL única que diluye el valor de los enlaces y malgasta el presupuesto de rastreo.
Ejemplo de robots.txt para un sitio de comercio electrónico:
User-agent: *
No permitir: /*?filter=
No permitir: /*?sort=
No permitir: /buscar?*
No permitir: /cart
No permitir: /checkout
Protección de las zonas de estacionamiento y desarrollo
Los sitios de desarrollo, los entornos de ensayo y las zonas de prueba nunca deben aparecer en los resultados de búsqueda. Bloquearlos evita la indexación accidental:
User-agent: *
No permitir: /staging/
No permitir: /dev/
No permitir: /test/
Control del rastreo de archivos PDF y multimedia
Algunos sitios tienen cientos de PDF o recursos descargables. Si no están pensados para ser visibles en las búsquedas, bloquéelos:
User-agent: *
No permitir: /*.pdf$
No permitir: /*.doc$
No permitir: /*.xls$
Bloqueo de robots específicos
No todos los rastreadores son bienvenidos. Algunos raspan contenidos, otros son maliciosos y otros malgastan recursos sin aportar valor:
User-agent: AhrefsBot
No permitir: /
User-agent: SemrushBot
No permitir: /
User-agent: *
No permitir: /admin/
Esto bloquea rastreadores específicos de herramientas SEO mientras permite a los principales motores de búsqueda.
Buenas prácticas para los archivos Robots.Txt
Para crear un archivo robots.txt eficaz es necesario seguir las directrices establecidas y evitar los errores más comunes.
Ubicación y accesibilidad
El archivo robots.txt debe colocarse en el directorio raíz del dominio. No funcionará en subdirectorios. En el caso de ejemplo.com, el archivo debe estar en ejemplo.com/robots.txt, no en ejemplo.com/páginas/robots.txt.
El archivo debe ser accesible a través de HTTP/HTTPS. Según la interpretación de Google de la especificación robots.txt, si el archivo devuelve un error 404, Google asume que no existen restricciones de rastreo y procede a rastrearlo todo.
La distinción entre mayúsculas y minúsculas es importante
Las directivas distinguen entre mayúsculas y minúsculas. No permitir: /Admin/ no bloquea /admin/. Utilice siempre minúsculas por coherencia, a menos que se requieran mayúsculas específicas.
Comodines y concordancia de patrones
La sintaxis moderna de robots.txt admite comodines para reglas más flexibles:
| Patrón | Significado | Ejemplo |
|---|---|---|
| * | Coincide con cualquier secuencia | No permitir: /*.jpg$ bloquea todos los archivos JPG |
| $ | Fin de la URL | No permitir: /*.pdf$ bloquea los PDF, pero no /file.pdf?v=1 |
Pruebas antes de la implantación
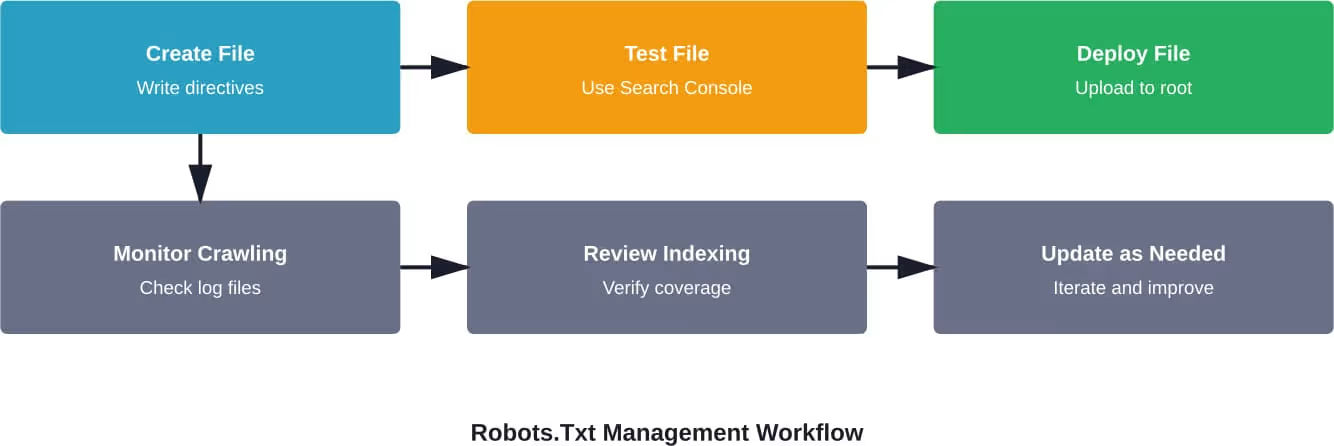
Nunca despliegue robots.txt sin realizar pruebas. Google Search Console incluye un comprobador de robots.txt que muestra exactamente cómo interpreta Googlebot el archivo. Los errores aquí pueden ser catastróficos: el bloqueo accidental de todo el sitio ha ocurrido a grandes empresas.
La Directiva de retardo
Aunque Google no la admite oficialmente, Bing y otros motores de búsqueda reconocen la directiva de retardo de rastreo. Según el blog para webmasters de Bing, esta directiva controla el ritmo al que los robots rastrean un sitio:
User-agent: *
Retraso de arrastre: 10
Indica a los robots que esperen 10 segundos entre peticiones. Utilícelo con moderación: la mayoría de los sitios no lo necesitan y puede ralentizar la indexación.
Robots.Txt Versus Meta Robots Tags
Comprender la diferencia entre las etiquetas robots.txt y meta robots evita confusiones y errores de indexación.
Robots.txt controla el rastreo, es decir, si los robots pueden acceder a una página. Las etiquetas meta robots controlan la indexación, es decir, si una página aparece en los resultados de búsqueda.
Estos dos mecanismos funcionan de forma independiente:
| Escenario | Robots.Txt | Metaetiqueta | Resultado |
|---|---|---|---|
| Bloquear el rastreo y la indexación | No permitir: /page/ | N/A | Página no rastreada; puede seguir apareciendo en los resultados si se enlaza externamente |
| Permitir el rastreo, impedir la indexación | Permitir | noindex | Página rastreada pero no indexada |
| Bloquear el rastreo, impedir la indexación | No permitir: /page/ | noindex | Problema: el bot no puede ver la etiqueta noindex porque está bloqueada para el rastreo |
Este es el error crítico que hay que evitar: bloquear una página en robots.txt y utilizar al mismo tiempo una etiqueta noindex. El bot nunca ve la instrucción noindex porque tiene bloqueado el acceso a la página. Si los enlaces externos apuntan a esa URL, puede seguir apareciendo en los resultados de búsqueda.
Según la documentación de Google Search Central sobre las etiquetas meta robots, el enfoque adecuado para evitar la indexación es permitir el rastreo para que los robots puedan leer la directiva noindex.
Errores comunes de Robots.Txt que perjudican el SEO
Incluso los desarrolladores experimentados cometen errores en robots.txt. Estos errores tienen graves consecuencias.
Bloqueo de archivos CSS y JavaScript
Hace años, algunos SEO recomendaban bloquear CSS y JavaScript en robots.txt. Ahora esto se considera perjudicial. Google necesita renderizar las páginas por completo para comprender el contenido y la experiencia del usuario.
El bloqueo de estos recursos puede provocar:
- Evaluaciones incorrectas de la compatibilidad móvil
- No se detecta el contenido por encima del pliegue
- Incomprensión del diseño de página y la usabilidad
Google desaconseja explícitamente bloquear los archivos CSS y JavaScript.
Bloqueo accidental de todo el sitio web
Una sola errata puede ser devastadora:
User-agent: *
No permitir: /
Esto bloquea todo. Ocurre más a menudo de lo que debería: durante migraciones de sitios, al actualizar archivos o cuando alguien no familiarizado con la sintaxis realiza cambios.
Pruebe siempre primero en un entorno de ensayo.
Uso de Robots.Txt para ocultar información sensible
Robots.txt es de acceso público. Cualquiera puede ver el archivo robots.txt de un sitio visitando domain.com/robots.txt. Usarlo para ocultar directorios sensibles en realidad anuncia su existencia.
Para contenidos realmente sensibles, utilice controles de acceso y autenticación adecuados, no robots.txt.
Olvidarse de las diferencias entre subdominios
Cada subdominio necesita su propio archivo robots.txt. El archivo de ejemplo.com/robots.txt no se aplica a blog.ejemplo.com. Se necesitan archivos independientes para cada subdominio.
Cómo tratan los motores de búsqueda los errores de Robots.Txt
¿Qué ocurre cuando un archivo robots.txt tiene errores o no se puede acceder a él?
Según la interpretación de Google de la especificación robots.txt, los distintos códigos de estado HTTP desencadenan comportamientos diferentes:
| Código de estado | Respuesta de Google |
|---|---|
| 404 (No encontrado) | No asume restricciones; lo rastrea todo |
| 5xx (Error de servidor) | Deja de rastrear durante 12 horas; sigue intentando recuperar el archivo |
| 403 (Prohibido) | Se trata como Disallow: / y bloquea todos los rastreos |
Los errores de servidor son especialmente problemáticos. Si un sitio experimenta un tiempo de inactividad y robots.txt devuelve un error 5xx, Google detiene el rastreo por completo durante 12 horas. Los errores repetidos pueden provocar pausas de rastreo prolongadas.
Robots.Txt y los retos del SEO moderno
Rastreadores de inteligencia artificial y grandes modelos lingüísticos
Han surgido nuevos tipos de rastreadores para entrenar modelos de IA y grandes modelos lingüísticos. Empresas como OpenAI, Anthropic y otras despliegan bots para rastrear contenidos web.
Estos rastreadores suelen respetar robots.txt, pero no siempre. Algunas empresas de IA han introducido usuarios-agentes específicos:
- GPTBot (OpenAI)
- CCBot (rastreo común)
- antrópico-ai (Antrópico)
Los propietarios de sitios web preocupados por el entrenamiento de la IA en sus contenidos pueden bloquearlos específicamente:
Agente de usuario: GPTBot
No permitir: /
Agente de usuario: CCBot
No permitir: /
Pero aquí está el truco: no todos los sistemas de IA se identifican con claridad y algunos pueden no respetar las directivas robots.txt.
Consideraciones sobre Mobile-First Indexing
Con la indexación mobile-first, Google utiliza principalmente la versión móvil del contenido para indexarlo y clasificarlo. El archivo robots.txt para móviles debe permitir el rastreo de los recursos necesarios para la representación en móviles.
Si existen URL móviles independientes (m.ejemplo.com), ese subdominio necesita su propia configuración de robots.txt.
Herramientas para gestionar y probar robots.Txt
Varias herramientas ayudan a crear, validar y supervisar los archivos robots.txt:
Comprobador de Robots.Txt de Google Search Console
Esta herramienta gratuita muestra exactamente cómo Googlebot interpreta un archivo robots.txt. Destaca los errores de sintaxis y permite comprobar URL específicas según las reglas.
Herramientas para webmasters de Bing
Al igual que la herramienta de Google, Bing ofrece funciones de validación y comprobación en su plataforma para webmasters.
Generadores de Robots.Txt en línea
Para quienes no estén familiarizados con la sintaxis, los generadores proporcionan plantillas e interfaces interactivas para crear archivos robots.txt. Esto reduce el riesgo de errores de sintaxis.
Análisis de archivos de registro
El análisis de los registros del servidor revela cómo se comportan realmente los rastreadores. Herramientas como Screaming Frog Log Analyzer o Botify muestran qué bots visitan, a qué páginas acceden y si se respetan las directivas robots.txt.
Robots del mundo real.Txt Ejemplos
Observar cómo estructuran sus archivos robots.txt los principales sitios web proporciona información práctica.
Blog sencillo o sitio para pequeñas empresas
User-agent: *
No permitir: /wp-admin/
Permitir: /wp-admin/admin-ajax.php
No permitir: /wp-login.php
No permitir: /cart/
No permitir: /checkout/
Mapa del sitio: https://example.com/sitemap.xml
Este ejemplo de WordPress bloquea las áreas de administración y de pago de comercio electrónico, mientras que permite todo lo demás.
Gran sitio de comercio electrónico
User-agent: *
No permitir: /buscar
No permitir: /*?*sort=
No permitir: /*?*filter=
No permitir: /cart
No permitir: /checkout
No permitir: /cuenta
No permitir: /*.pdf$
User-agent: AhrefsBot
No permitir: /
Mapa del sitio: https://store.example.com/sitemap.xml
Mapa del sitio: https://store.example.com/products-sitemap.xml
Sitio de noticias o publicaciones
User-agent: *
No permitir: /buscar
No permitir: /api/
Permitir: /api/public/
Retraso de arrastre: 10
User-agent: Googlebot-News
Rechazar:
Mapa del sitio: https://news.example.com/news-sitemap.xml
Esto permite a los rastreadores de Google Noticias acceder sin restricciones, mientras que limita a otros bots.
Conclusión: Dominar Robots.Txt para un mejor SEO
El archivo robots.txt sigue siendo un componente fundamental del SEO técnico a pesar de tener más de 30 años. Proporciona un control preciso sobre cómo los motores de búsqueda acceden y rastrean los sitios web, ayudando a prevenir la sobrecarga del servidor, preservar el presupuesto de rastreo y evitar la indexación de contenido de poco valor.
Pero no es infalible. Entender qué puede y qué no puede hacer el robots.txt evita errores comunes que perjudican el rendimiento SEO. Controla el rastreo, no la indexación. Es visible al público, no una medida de seguridad. Y requiere pruebas cuidadosas antes de su despliegue.
El enfoque más eficaz combina robots.txt con otras herramientas: etiquetas noindex para controlar la indexación, una arquitectura adecuada del sitio para gestionar la eficacia del rastreo y una supervisión periódica mediante el análisis de archivos de registro y herramientas para webmasters.
A medida que los motores de búsqueda evolucionan y surgen nuevos tipos de rastreadores -en particular, robots de entrenamiento de inteligencia artificial-, el archivo robots.txt sigue adaptándose. Mantenerse al día con las especificaciones y las mejores prácticas garantiza que los sitios web mantengan el control sobre la forma en que los sistemas automatizados interactúan con su contenido.
Comience por auditar las configuraciones existentes de robots.txt. Realice pruebas exhaustivas con Google Search Console y Bing Webmaster Tools. Supervise el comportamiento de rastreo a través de los archivos de registro. Y lo más importante, documente cualquier cambio para que las futuras actualizaciones no rompan accidentalmente directivas críticas.
¿Está listo para optimizar el rastreo y mejorar el rendimiento SEO? Revise hoy mismo su archivo robots.txt y asegúrese de que se ajusta a las mejores prácticas actuales.









