


ملخص سريع: ملف robots.txt هو ملف نصي عادي يوضع في الدليل الجذر لموقع ويب يخبر برامج زحف محرك البحث بالصفحات أو الأقسام التي يمكنهم أو لا يمكنهم الوصول إليها. يُستخدم بشكل أساسي لإدارة حركة مرور برامج الزحف ومنع التحميل الزائد على الخادم، وليس لإخفاء الصفحات من نتائج البحث. وفقًا ل Google Search Central، يساعد ملف robots.txt في التحكم في كيفية زحف محركات البحث إلى موقعك، ولكن لحظر ظهور الصفحات فعليًا في نتائج البحث، تحتاج إلى علامات عدم الفهرسة أو حماية كلمة المرور بدلاً من ذلك.
ترسل محركات البحث روبوتات آلية للزحف إلى المواقع الإلكترونية كل يوم. تقوم برامج الزحف هذه بفهرسة المحتوى وتتبع الروابط وتحديد ما يظهر في نتائج البحث. ولكن إليك الأمر - لا تحتاج كل صفحة على موقع الويب إلى الزحف إليها. بعض الصفحات تهدر موارد الزاحف، وبعضها لا ينبغي فهرستها على الإطلاق.
وهنا يأتي دور robots.txt.
يعطي هذا الملف النصي الصغير تعليمات لبرامج زحف الويب حول أجزاء الموقع التي يمكنهم الوصول إليها. وهو موجود منذ أوائل التسعينيات، ولا يزال جزءًا أساسيًا من تحسين محركات البحث التقنية. يمكن أن يؤدي فهم كيفية عمل ملف robots.txt إلى منع كوارث الفهرسة، وتحسين كفاءة الزحف، والحفاظ على المناطق الحساسة في الموقع الإلكتروني محمية.
دعنا نفصِّل ما هو الروبوتات.txt بالضبط، وكيف يعمل، ولماذا هو مهم لتحسين محركات البحث في عام 2026.
فهم ملف Robots.Txt الروبوتات
وفقًا لموقع Google Search Central، يخبر ملف robots.txt برامج زحف محرك البحث بعناوين URL التي يمكن للزاحف الوصول إليها على الموقع. يُستخدم بشكل أساسي لإدارة حركة مرور الزاحف وتجنب إثقال الخوادم بالطلبات.
يوجد الملف في الدليل الجذر لموقع الويب. بالنسبة لموقع مثل example.com، سيكون ملف robots.txt موجودًا في example.com/robots.txt. تتحقق محركات البحث من هذا الموقع قبل الزحف إلى أي صفحات أخرى.
إليك ما يجعل ملف robots.txt فريدًا من نوعه: إنه ملف نصي عادي يتبع بروتوكول استبعاد الروبوتات (REP). انبثق بروتوكول استبعاد الروبوتات من إجماع عام 1994 وهو الآن معترف به على نطاق واسع من قبل محركات البحث الرئيسية بما في ذلك جوجل وبينج وغيرها.
كيف يعمل Robots.Txt في الواقع
عندما يريد روبوت محرك البحث الزحف إلى موقع إلكتروني، فإنه يتبع تسلسلاً محدداً:
- يحاول الروبوت الوصول إلى ملف robots.txt في المجال الجذر
- إذا كان الملف موجودًا، يقرأ الروبوت التعليمات ويحللها
- يتبع الروبوت التوجيهات التي تنطبق على وكيل المستخدم الخاص به
- وعندها فقط ينتقل إلى الزحف إلى الصفحات المسموح بها
وفقًا لموقع robotstxt.org، نشأ المعيار من إجماع بين مؤلفي الروبوتات والأطراف المهتمة في عام 1994. إنه طوعي من الناحية الفنية - تختار الروبوتات احترامه - لكن جميع محركات البحث الشرعية تحترم توجيهات robots.txt.

ما يمكن ل Robots.Txt فعله وما لا يمكن فعله
هناك مفهوم خاطئ شائع حول robots.txt. يعتقد العديد من مالكي المواقع أنه يمنع الصفحات من الظهور في نتائج البحث. لكنه لا يمنع ذلك.
ينص محرك بحث جوجل المركزي صراحةً على أن الروبوتات.txt ليست آلية لإبقاء صفحات الويب خارج جوجل. إذا كانت هناك مواقع أخرى ترتبط بصفحة محظورة، فيمكن أن تستمر في الظهور في نتائج البحث - فقط بدون وصف.
لمنع الفهرسة فعليًا، تحتاج المواقع إلى استخدام:
- العلامات الوصفية Noindex في الصفحة HTML
- عناوين X-Robots-Tag HTTP
- متطلبات حماية كلمة المرور أو المصادقة
يتحكم Robots.txt في سلوك الزحف، وليس الفهرسة. هذا تمييز حاسم.
بناء الجملة الأساسية ل Robots.Txt
يستخدم ملف robots.txt صيغة مباشرة. حتى بدون خبرة تقنية، فإن التنسيق سهل القراءة ومنطقي.
إليك مثالاً بسيطاً:
وكيل المستخدم: *
عدم السماح: /مشرف/
عدم السماح: /temp/
السماح: /temp/public/
خريطة الموقع: https://www.example.com/sitemap.xml
دعونا نفك شفرة كل جزء.
توجيه وكيل المستخدم
يحدد سطر وكيل المستخدم أي زاحف تنطبق عليه القواعد التالية. علامة النجمة (*) تعني جميع برامج التصفح الآلية. يمكن استهداف روبوتات محددة بالاسم:
- جوجل بوت (الزاحف الرئيسي لجوجل)
- Googlebot-Image (زاحف الصور من Google)
- بينغبوت (زاحف مايكروسوفت بينج)
- AhrefsBot (زاحف أداة تحسين محركات البحث Ahrefs)
يمكن أن توجد أقسام متعددة لوكيل المستخدم في ملف واحد، ولكل منها قواعد مختلفة.
عدم السماح بالتوجيه
يخبر توجيه عدم السماح الروبوتات بعناوين URL أو المسارات التي لا يمكنهم الوصول إليها. بعض الأمثلة:
| التوجيهات | ما الذي يحجبه |
|---|---|
| عدم السماح: /مشرف/ | جميع عناوين URL التي تبدأ بـ /admin/ |
| عدم السماح: /*.pdf$ | جميع ملفات PDF على مستوى الموقع |
| عدم السماح: / | كل شيء على الموقع |
| عدم السماح: | لا شيء (يسمح بالجميع) |
السماح بالتوجيهات
ينشئ توجيه السماح استثناءات لقواعد عدم السماح. وهو مفيد بشكل خاص للسماح بالوصول إلى دلائل فرعية محددة داخل الأقسام المحظورة.
على سبيل المثال:
وكيل المستخدم: *
عدم السماح: /خاص/خاص/
السماح: /خاص/خاص/عامة/موارد عامة/
يؤدي هذا إلى حظر الدليل /خاص/ بأكمله باستثناء المجلد /خاص/الموارد العامة/.
توجيه خريطة الموقع
يساعد تضمين مواقع خريطة الموقع محركات البحث في العثور على الصفحات المهمة والزحف إليها بكفاءة أكبر. يمكن إضافة أسطر متعددة لخريطة الموقع:
خريطة الموقع: https://example.com/sitemap.xml
خريطة الموقع: https://example.com/sitemap-images.xml
وفقًا لوثائق جوجل، يُعتبر إدراج خرائط المواقع في robots.txt من أفضل الممارسات لكفاءة الزحف.
لماذا يعتبر Robots.Txt مهمًا لتحسين محركات البحث
تؤثر إدارة كيفية زحف محركات البحث إلى موقع إلكتروني بشكل مباشر على أداء تحسين محركات البحث. يوفر Robots.txt التحكم في هذه العملية.
منع إهدار ميزانية الزحف
تخصص محركات البحث ميزانية زحف لكل موقع، أي عدد الصفحات التي ستزحف إليها الروبوتات خلال فترة معينة. يمكن للمواقع الكبيرة التي تحتوي على آلاف الصفحات أن تستنفد هذه الميزانية بسرعة على محتوى منخفض القيمة.
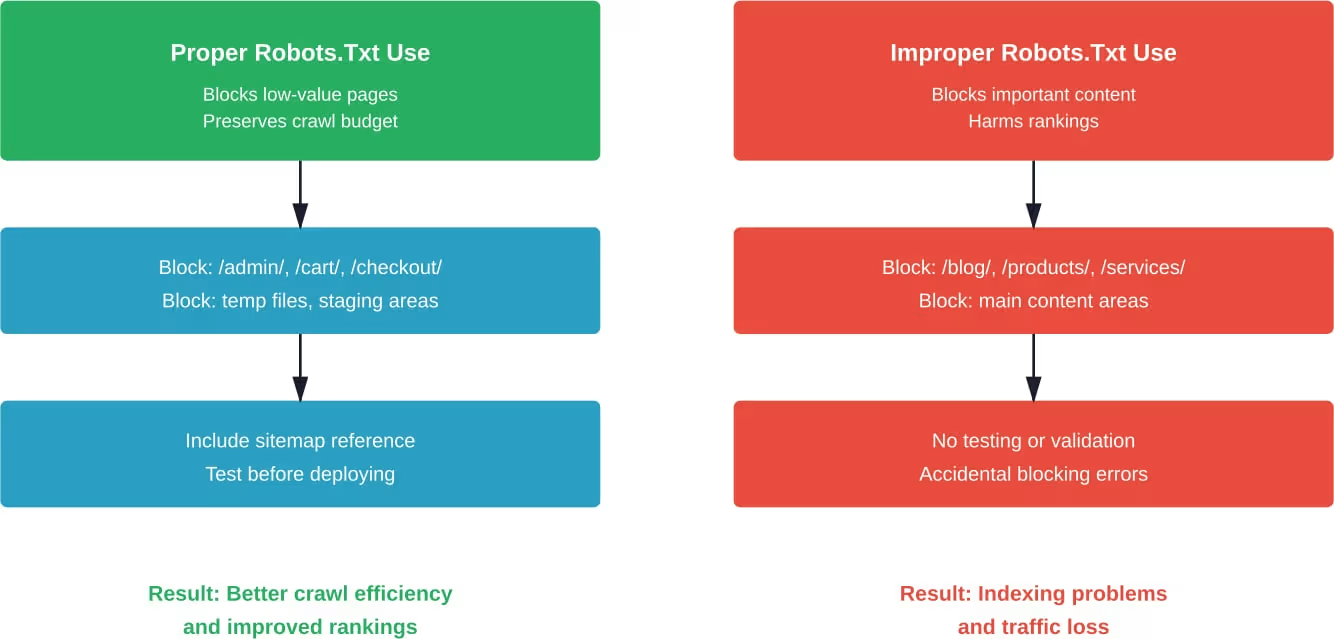
يحافظ استخدام robots.txt لمنع برامج الزحف من الوصول إلى الصفحات المكررة أو مناطق التجهيز أو أقسام الإدارة على ميزانية الزحف للمحتوى المهم. يصبح هذا أمرًا بالغ الأهمية بشكل خاص لمواقع التجارة الإلكترونية ذات التنقل متعدد الأوجه التي تنشئ آلاف من أشكال عناوين URL المختلفة.
حماية موارد الخادم
يمكن أن يؤدي الزحف العدواني إلى إجهاد موارد الخادم، خاصة بالنسبة للمواقع الصغيرة أو تلك التي لديها استضافة محدودة. وفقًا لمدونة Bing Webmaster Blog، يساعد التحكم في معدل الزحف من خلال robots.txt (وتوجيهات تأخير الزحف) في استيعاب مشكلات تحميل خادم الويب.
حديث حقيقي: إذا تعطّل موقع ما لأن الروبوتات تنهال عليه بالطلبات، فهذه كارثة في تحسين محركات البحث. تنخفض التصنيفات، ويحصل المستخدمون على صفحات الخطأ، ويستغرق التعافي وقتاً طويلاً.
تجنب مشكلات المحتوى المكرر
عندما تقوم محركات البحث بالزحف إلى إصدارات متعددة من نفس المحتوى وفهرستها، تنشأ مشكلات المحتوى المكرر. بينما تدّعي جوجل أنها تتعامل مع التكرارات بشكل جيد، فلماذا المخاطرة؟
يؤدي حظر عناوين URL المستندة إلى معلمات أو إصدارات الطباعة أو اختلافات معرّف الجلسة إلى منع الفهرسة المكررة غير الضرورية.
إصلاح تحسين محركات البحث التقنية وتحسين الرؤية
يُعد فهم الروبوتات.txt جزءًا واحدًا فقط من تحسين محركات البحث التقني، و لينغريو يركز على تحسين الأساس التقني الكامل لتحسين قابلية الزحف والتصنيفات. يمكن أن تحد المشكلات التقنية من أفضل محتوى، لذا فإن وجود أساس متين أمر بالغ الأهمية لنجاح تحسين محركات البحث على المدى الطويل.
- تحسين الزحف والفهرس
- تحسينات هيكل الموقع
- الأداء والسرعة
إذا كنت ترغب في حل المشكلات الفنية وتحسين رؤية البحث, احصل على استشارة مجانية مع LENGREO.
حالات استخدام Robots.Txt الشائعة
مواقع الويب المختلفة لها احتياجات مختلفة. فيما يلي سيناريوهات عملية يثبت فيها أن الروبوتات.txt ضرورية.
حظر وظائف البحث وتصفية الصفحات
تُنشئ مواقع التجارة الإلكترونية عددًا لا يحصى من عناوين URL من خلال التصفح متعدد الأوجه - التصفية حسب الحجم واللون ونطاق السعر والسمات الأخرى. كل مجموعة تنشئ عنوان URL فريدًا يخفف من قيمة الروابط ويهدر ميزانية الزحف.
مثال على robots.txt لموقع تجارة إلكترونية:
وكيل المستخدم: *
عدم السماح: /**?مرشح=
عدم السماح: /*؟الفرز=
عدم السماح: /بحث؟*
عدم السماح: /كارت
عدم السماح: /خروج
حماية مناطق الانطلاق والتطوير
يجب ألا تظهر مواقع التطوير والبيئات المرحلية ومناطق الاختبار في نتائج البحث. حظرها يمنع الفهرسة العرضية:
وكيل المستخدم: *
عدم السماح: /التدريج/
عدم السماح: /ديف/
عدم السماح: /test/
التحكم في ملفات PDF وزحف ملفات الوسائط
تحتوي بعض المواقع على مئات من ملفات PDF أو الموارد القابلة للتنزيل. إذا لم تكن مخصصة لرؤية البحث، فاحظرها:
وكيل المستخدم: *
عدم السماح: /*.pdf$
عدم السماح: /*.doc$
عدم السماح: /* .xls$
حظر روبوتات محددة
ليست كل برامج الزحف موضع ترحيب. فبعضها يقوم بكشط المحتوى، وبعضها خبيث، والبعض الآخر يهدر الموارد دون إضافة قيمة:
وكيل المستخدم: AhrefsBot
عدم السماح: /
وكيل المستخدم: SemrushBot
عدم السماح: /
وكيل المستخدم: *
عدم السماح: /مشرف/
هذا يحظر برامج زحف أدوات تحسين محركات البحث المحددة بينما يسمح لمحركات البحث الرئيسية.
أفضل الممارسات لملفات Robots.Txt
يتطلب إنشاء ملف robots.txt فعّال اتباع الإرشادات المعمول بها وتجنب الأخطاء الشائعة.
الموقع وسهولة الوصول
يجب وضع ملف robots.txt في الدليل الجذر للنطاق. لن يعمل في الدلائل الفرعية. بالنسبة إلى example.com، يجب أن يكون الملف في example.com/robots.txt، وليس example.com/pages/robots.txt.
يجب أن يكون الملف متاحًا عبر HTTP/HTTPS. وفقًا لتفسير Google لمواصفات robots.txt، إذا أرجع الملف خطأ 404، يفترض Google عدم وجود قيود على الزحف ويواصل الزحف إلى كل شيء.
مسائل حساسية الحالة
التوجيهات حساسة لحالة الأحرف. عدم السماح: /Admin/ لا يحظر /Admin/. استخدم دائمًا الأحرف الصغيرة من أجل الاتساق ما لم تكن هناك حاجة إلى كتابة أحرف كبيرة محددة.
أحرف البدل ومطابقة الأنماط
تدعم صيغة robots.txt الحديثة أحرف البدل للحصول على قواعد أكثر مرونة:
| النمط | المعنى | مثال على ذلك |
|---|---|---|
| * | يطابق أي تسلسل | عدم السماح: /*.jpg$ يحظر جميع ملفات JPG |
| $ | نهاية عنوان URL | عدم السماح: /*.pdf$ يحظر ملفات PDF، ولكن ليس /file.pdf?v=1 |
الاختبار قبل النشر
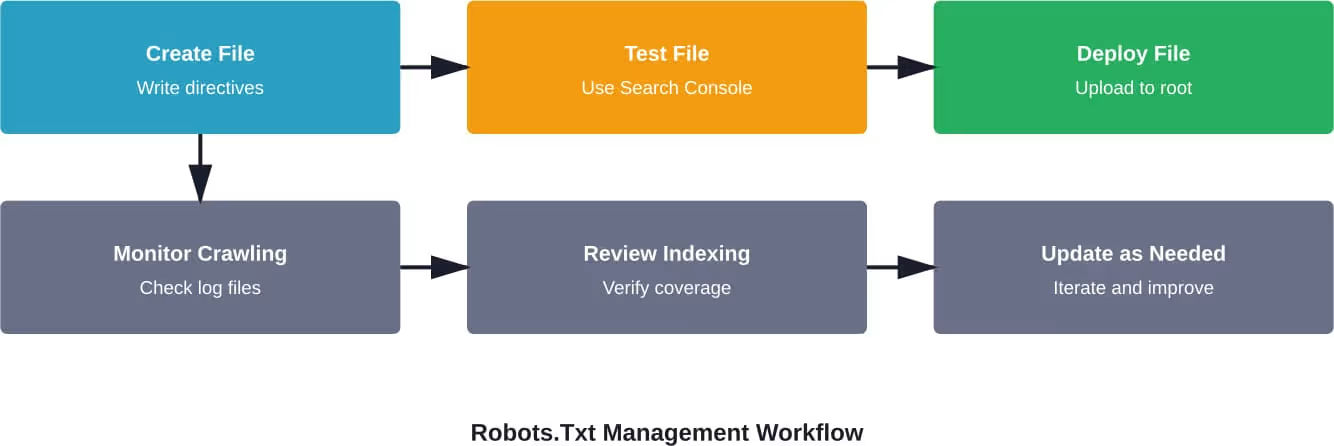
لا تنشر أبدًا ملف robots.txt دون اختباره. يتضمن Google Search Console أداة اختبار robots.txt تعرض بالضبط كيف يفسر Googlebot الملف. يمكن أن تكون الأخطاء هنا كارثية - فقد حدث حظر الموقع بأكمله عن طريق الخطأ لشركات كبرى.
توجيه تأخير الزحف-التأخير
على الرغم من أن Google لا تدعمه Google رسميًا، إلا أن Bing ومحركات البحث الأخرى تعترف بتوجيه تأخير الزحف. وفقًا لمدونة Bing Webmaster Blog، يتحكم هذا التوجيه في سرعة زحف الروبوتات إلى الموقع:
وكيل المستخدم: *
تأخير الزحف 10
هذا يخبر الروبوتات بالانتظار 10 ثوانٍ بين الطلبات. استخدم هذا باعتدال، فمعظم المواقع لا تحتاج إليه، ويمكن أن يبطئ الفهرسة.
الروبوتات.Txt مقابل علامات الروبوتات الوصفية
إن فهم الفرق بين علامات الروبوتات. txt وعلامات الروبوتات الوصفية يمنع حدوث ارتباك وأخطاء في الفهرسة.
يتحكم Robots.txt في الزحف- ما إذا كان يمكن للروبوتات الوصول إلى الصفحة. تتحكم علامات الروبوتات الوصفية في الفهرسة - ما إذا كانت الصفحة ستظهر في نتائج البحث.
تعمل هاتان الآليتان بشكل مستقل:
| السيناريو | روبوتات.Txt | الوسم التعريفي | النتيجة |
|---|---|---|---|
| حظر الزحف والفهرسة | عدم السماح: /صفحة/ | غير متاح | لم يتم الزحف إلى الصفحة؛ قد تظهر في النتائج إذا تم ربطها خارجيًا |
| السماح بالزحف، ومنع الفهرسة | السماح | لا يوجد فهرس | صفحة تم الزحف إليها ولكن لم تتم فهرستها |
| منع الزحف، ومنع الفهرسة | عدم السماح: /صفحة/ | لا يوجد فهرس | المشكلة: لا يستطيع الروبوت رؤية علامة noindex لأنه محظور من الزحف |
إليك الخطأ الفادح الذي يجب تجنبه: حظر صفحة في robots.txt مع استخدام علامة noindex أيضًا. لا يرى الروبوت أبدًا تعليمات عدم الفهرسة لأنه محظور من الوصول إلى الصفحة. إذا كانت الروابط الخارجية تشير إلى عنوان URL هذا، فلا يزال بإمكانه الظهور في نتائج البحث.
وفقًا لوثائق Google Search Central المتعلقة بعلامات الروبوتات الوصفية فإن الطريقة الصحيحة لمنع الفهرسة هي السماح بالزحف حتى تتمكن الروبوتات من قراءة توجيه عدم الفهرسة.
أخطاء Robots.Txt الشائعة التي تضر بتحسين محركات البحث
حتى المطورون المتمرسون يرتكبون أخطاءً في robots.txt. هذه الأخطاء لها عواقب وخيمة.
حظر ملفات CSS و JavaScript
منذ سنوات، أوصى بعض مُحسّنات محرّكات البحث بحظر CSS وجافا سكريبت في robots.txt. هذا يعتبر الآن ضارًا. يحتاج جوجل إلى عرض الصفحات بشكل كامل لفهم المحتوى وتجربة المستخدم.
يمكن أن يؤدي حجب هذه الموارد إلى:
- التقييمات غير الصحيحة لملاءمة الأجهزة المحمولة
- الفشل في اكتشاف المحتوى أعلى الطية
- سوء فهم تخطيط الصفحة وسهولة الاستخدام
تنصح جوجل صراحةً بعدم حظر ملفات CSS وجافا سكريبت.
حجب الموقع بالكامل عن طريق الخطأ
يمكن لخطأ مطبعي واحد أن يكون مدمراً:
وكيل المستخدم: *
عدم السماح: /
هذا يحجب كل شيء. يحدث ذلك أكثر مما ينبغي - أثناء عمليات ترحيل الموقع، أو عند تحديث الملفات، أو عندما يقوم شخص غير معتاد على بناء الجملة بإجراء تغييرات.
اختبر دائمًا في بيئة مرحلية أولاً.
استخدام Robots.Txt لإخفاء المعلومات الحساسة
يمكن الوصول إلى Robots.txt بشكل عام. يمكن لأي شخص عرض ملف robots.txt الخاص بالموقع عن طريق زيارة domain.com/robots.txt. إن استخدامه لإخفاء الدلائل الحساسة يعلن في الواقع عن وجودها.
بالنسبة للمحتوى الحساس حقًا، استخدم المصادقة المناسبة وعناصر التحكم في الوصول، وليس robots.txt.
نسيان اختلافات النطاقات الفرعية
يحتاج كل نطاق فرعي إلى ملف robots.txt الخاص به. لا ينطبق الملف الموجود في example.com/robots.txt على blog.example.com. ملفات منفصلة مطلوبة لكل نطاق فرعي.
كيفية تعامل محركات البحث مع أخطاء Robots.Txt
ماذا يحدث عندما يكون ملف robots.txt به أخطاء أو لا يمكن الوصول إليه؟
وفقًا لتفسير جوجل لمواصفات robots.txt، تؤدي رموز حالة HTTP المختلفة إلى سلوكيات مختلفة:
| رمز الحالة | رد جوجل |
|---|---|
| 404 (لم يتم العثور على) | يفترض عدم وجود قيود؛ يزحف كل شيء |
| 5xx (خطأ في الخادم) | توقف الزحف لمدة 12 ساعة؛ يستمر في محاولة جلب الملف |
| 403 (ممنوع) | يعامل كـ Disallow: / ويحظر كل الزحف |
أخطاء الخادم مشكلة بشكل خاص. إذا تعرض موقع ما لوقت تعطل وأرجع الروبوتات.txt خطأ 5xx، يتوقف جوجل عن الزحف بالكامل لمدة 12 ساعة. يمكن أن تؤدي الأخطاء المتكررة إلى توقف الزحف المؤقت لفترات طويلة.
Robots.Txt وتحديات تحسين محركات البحث الحديثة
برامج الزحف بالذكاء الاصطناعي ونماذج اللغات الكبيرة
ظهرت أنواع جديدة من برامج الزحف لتدريب نماذج الذكاء الاصطناعي والنماذج اللغوية الكبيرة. وتنشر شركات مثل OpenAI و Anthropic وغيرهما روبوتات لكشط محتوى الويب.
وغالبًا ما تحترم برامج الزحف هذه برامج الزحف هذه الروبوتات.txt، ولكن ليس دائمًا. وقد أدخلت بعض شركات الذكاء الاصطناعي وكلاء مستخدمين محددين:
- روبوت GPTBot (OpenAI)
- CCBot (الزحف المشترك)
- أنثروبيك-أي (أنثروبيك)
يمكن لمالكي المواقع القلقين بشأن تدريب الذكاء الاصطناعي على محتواهم حظر هذه المواقع على وجه التحديد:
وكيل المستخدم: GPTBot
عدم السماح: /
وكيل المستخدم: CCBot
عدم السماح: /
ولكن إليك المشكلة - ليست كل أنظمة الذكاء الاصطناعي تعرّف نفسها بوضوح، وقد لا يحترم بعضها توجيهات robots.txt.
اعتبارات الفهرسة على الجوال أولاً
مع فهرسة الجوّال أولاً، تستخدم Google في المقام الأول إصدار الجوّال من المحتوى للفهرسة والترتيب. يجب أن يسمح ملف robots.txt للجوال بتتبع الموارد اللازمة للعرض على الجوّال.
في حالة وجود عناوين URL منفصلة للأجهزة المحمولة (m.example.com)، يحتاج هذا النطاق الفرعي إلى تكوين robots.txt الخاص به.
أدوات لإدارة الروبوتات واختبارها.Txt
تساعد العديد من الأدوات في إنشاء ملفات robots.txt والتحقق من صحتها ومراقبتها:
اختبار روبوتات وحدة تحكم بحث Google Console Robots.Txt
تعرض هذه الأداة المجانية كيفية تفسير Googlebot لملف robots.txt بالضبط. وهي تسلط الضوء على أخطاء بناء الجملة وتسمح باختبار عناوين URL محددة مقابل القواعد.
أدوات مشرفي المواقع من Bing
على غرار أداة جوجل، يقدم Bing ميزات التحقق والاختبار داخل منصة مشرفي المواقع الخاصة بهم.
مولدات الروبوتات عبر الإنترنت
بالنسبة لأولئك غير المعتادين على بناء الجملة، توفر المولدات قوالب وواجهات تفاعلية لإنشاء ملفات robots.txt. هذه تقلل من مخاطر الأخطاء النحوية.
تحليل ملف السجل
يكشف تحليل سجلات الخوادم كيف تتصرف برامج الزحف بالفعل. تُظهِر أدوات مثل Screaming Frog Log Analyzer أو Botify أي برامج زحف تزورها، والصفحات التي تصل إليها، وما إذا كانت توجيهات الروبوتات.txt تُحترم.
أمثلة على روبوتات العالم الحقيقي
إن النظر إلى كيفية تنظيم المواقع الإلكترونية الكبرى لملفات robots.txt الخاصة بها يوفر رؤى عملية.
مدونة بسيطة أو موقع تجاري صغير
وكيل المستخدم: *
عدم السماح: /wp-admin/
السماح: /wp-admin/admin-ajax.php
عدم السماح: /wp-login.php
عدم السماح: /كارت/
عدم السماح: /الخروج/
خريطة الموقع: https://example.com/sitemap.xml
يحظر مثال ووردبريس هذا مناطق الإدارة ومناطق الدفع للتجارة الإلكترونية بينما يسمح بكل شيء آخر.
موقع كبير للتجارة الإلكترونية
وكيل المستخدم: *
عدم السماح: / بحث
عدم السماح: /**؟*الفرز=
عدم السماح: /**؟*فلتر=
عدم السماح: /كارت
عدم السماح: /خروج
عدم السماح: /الحساب
عدم السماح: /*.pdf$
وكيل المستخدم: AhrefsBot
عدم السماح: /
خريطة الموقع: https://store.example.com/sitemap.xml
خريطة الموقع: https://store.example.com/products-sitemap.xml
موقع الأخبار أو النشر
وكيل المستخدم: *
عدم السماح: / بحث
عدم السماح: /api/
السماح: /API/public/
تأخير الزحف 10
وكيل المستخدم: أخبار Googlebot-News
عدم السماح:
خريطة الموقع: https://news.example.com/news-sitemap.xml
وهذا يسمح لبرامج زحف أخبار Google بالوصول غير المقيد مع تقييد برامج الروبوت الأخرى.
الخاتمة: إتقان Robots.Txt لتحسين تحسين محركات البحث
لا يزال ملف robots.txt مكونًا أساسيًا من مكونات تحسين محركات البحث التقنية على الرغم من مرور أكثر من 30 عامًا على إنشائه. فهو يوفر تحكمًا دقيقًا في كيفية وصول محركات البحث إلى مواقع الويب والزحف إليها، مما يساعد على منع التحميل الزائد على الخادم، والحفاظ على ميزانية الزحف، وتجنب فهرسة المحتوى منخفض القيمة.
لكنها ليست مضمونة. إن فهم ما يمكن وما لا يمكن أن يفعله robots.txt يمنع الأخطاء الشائعة التي تضر بأداء تحسين محركات البحث. يتحكم في الزحف - وليس الفهرسة. إنه مرئي للعامة - وليس إجراءً أمنيًا. ويتطلب اختبارًا دقيقًا قبل النشر.
يجمع النهج الأكثر نجاحًا بين robots.txt وأدوات أخرى: علامات عدم الفهرسة للتحكم في الفهرسة، وبنية الموقع المناسبة لإدارة كفاءة الزحف، والمراقبة المنتظمة من خلال تحليل ملفات السجل وأدوات مشرفي المواقع.
مع تطور محركات البحث وظهور أنواع جديدة من برامج الزحف - خاصةً روبوتات تدريب الذكاء الاصطناعي - يستمر برنامج الروبوتات. txt في التكيف. يضمن البقاء على اطلاع دائم بالمواصفات وأفضل الممارسات حفاظ المواقع الإلكترونية على التحكم في كيفية تفاعل الأنظمة الآلية مع محتواها.
ابدأ بمراجعة تكوينات robots.txt الحالية. اختبر بدقة باستخدام Google Search Console وBing Webmaster Tools. راقب سلوك الزحف من خلال ملفات السجل. والأهم من ذلك، قم بتوثيق أي تغييرات حتى لا تؤدي التحديثات المستقبلية إلى كسر التوجيهات المهمة عن طريق الخطأ.
هل أنت مستعد لتحسين الزحف لتحسين أداء تحسين محركات البحث؟ راجع ملف robots.txt اليوم وتأكد من توافقه مع أفضل الممارسات الحالية.









