


Zoekmachines zijn opmerkelijk geavanceerd, maar ze worstelen nog steeds met één fundamentele uitdaging: context begrijpen. Een pagina over “appeltaart” kan gaan over bakken, een menu-item van een restaurant of zelfs een tech-gerelateerde metafoor. Zonder duidelijke signalen maken zoekmachines gissingen over wat de inhoud betekent.
Dat is waar gestructureerde gegevens om de hoek komen kijken. Het is in wezen een vertaler tussen de inhoud van uw website en zoekmachines, die expliciete aanwijzingen geeft over wat informatie betekent en hoe deze in verband staat met andere elementen op uw pagina.
En de resultaten spreken voor zich. Volgens Google Search Central ontdekte Rakuten dat gebruikers 1,5x meer tijd doorbrengen op pagina's met gestructureerde data dan op pagina's met niet-gestructureerde data, en een 3,6x hogere interactiegraad hebben op AMP-pagina's met zoekfuncties versus AMP-pagina's zonder functies. Nestlé heeft gemeten dat pagina's die worden weergegeven als rijke resultaten in zoekopdrachten een 82% hogere doorklikratio hebben dan pagina's met niet-rijke resultaten.
Wat zijn gestructureerde gegevens precies?
Gestructureerde gegevens is een gestandaardiseerde indeling voor het verstrekken van informatie over een pagina en het classificeren van de inhoud. Zie het als metadata die beschrijft wat er op je pagina staat in een taal die zoekmachines nauwkeurig kunnen ontleden.
Wanneer iemand een recept online publiceert, kunnen mensen eenvoudig de ingrediëntenlijst, kooktijd en voedingsinformatie herkennen door alleen maar naar de paginaopmaak te kijken. Zoekmachines zien echter HTML-code. Zonder gestructureerde gegevens moeten ze de betekenis afleiden uit de visuele presentatie en de omringende tekst.
Gestructureerde gegevensopmaak lost dit op door elk inhoudselement expliciet te labelen. In plaats van Google te laten raden welke paragraaf de kooktijd bevat, verklaart de opmaak: “Dit is de kooktijd: 45 minuten.” De zoekmachine hoeft niet langer te interpreteren; hij weet het.
Het machineleesbare web
Het web is oorspronkelijk gemaakt om door mensen gelezen te worden. Gestructureerde gegevens transformeren het in iets dat machines met dezelfde duidelijkheid kunnen begrijpen. Deze verschuiving is belangrijk omdat zoekmachines steeds meer vertrouwen op het begrijpen van semantische relaties tussen inhoudselementen, niet alleen op het matchen van trefwoorden.
Wanneer gestructureerde gegevens Google vertellen dat een pagina een product bevat met een specifieke prijs, beschikbaarheidsstatus en klantbeoordeling, kan de zoekmachine die informatie met vertrouwen direct in de zoekresultaten weergeven. Dit creëert die verbeterde lijsten die rich results worden genoemd - zoekfuncties die sterbeoordelingen, prijzen, bereidingstijden, evenementdata en andere details direct op de resultatenpagina tonen.
Schema.org begrijpen: De universele woordenlijst
In 2011 werkten Google, Microsoft, Yahoo en Yandex samen aan Schema.org, een uniform vocabulaire voor gestructureerde gegevensopmaak. Deze samenwerking standaardiseerde hoe websites konden communiceren met zoekmachines en maakte een einde aan jaren van concurrerende indelingen en inconsistente implementaties.
Schema.org is geen eigendom van één bedrijf. Het is een gemeenschapsgedreven project dat schema's onderhoudt - in feite sjablonen of blauwdrukken - voor het beschrijven van verschillende soorten inhoud. Het vocabulaire is aanzienlijk gegroeid sinds de lancering en bestaat momenteel uit 827 Types, 1.528 Properties, 14 Datatypes, 94 Enumerations en 522 Enumeration members, volgens Schema.org.
Deze schema's dekken een uitgebreide reeks inhoudscategorieën:
- Creatieve werken: Artikelen, boeken, films, muziek, recepten, recensies
- Organisaties en plaatsen: Bedrijven, scholen, restaurants, bezienswaardigheden
- Evenementen: Concerten, conferenties, festivals, sportevenementen
- Producten en aanbiedingen: Fysieke goederen, diensten, prijzen, beschikbaarheid
- Mensen: Auteurs, kunstenaars, professionals
- Acties: Interacties die gebruikers kunnen uitvoeren op webpagina's
Vanaf 2024 markeren meer dan 45 miljoen webdomeinen hun webpagina's met meer dan 450 miljard Schema.org objecten, waardoor het de de facto standaard is voor de implementatie van gestructureerde gegevens op het hele web.
Het hiërarchiemodel
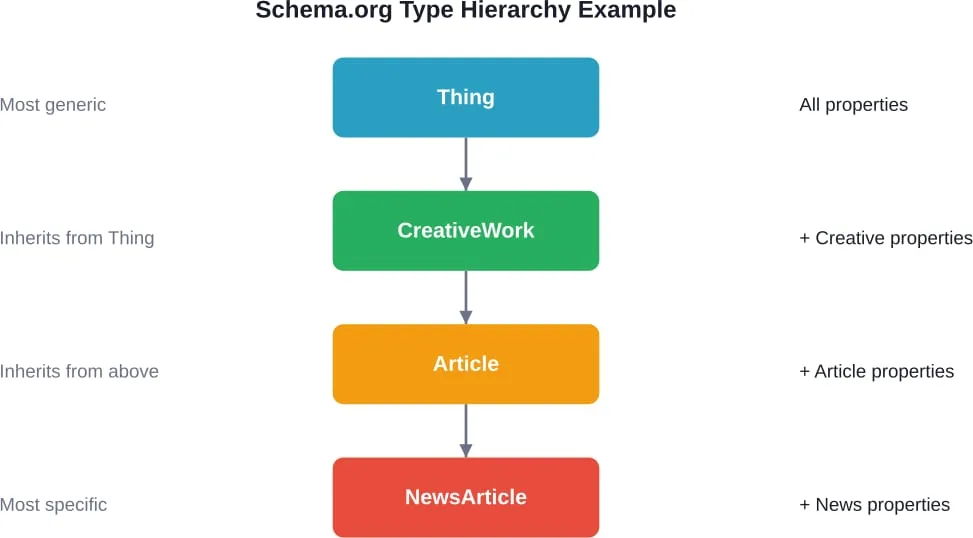
Schema.org organiseert types in een hiërarchie. Bovenaan staat “Ding”, het meest generieke type. Alles daalt af van Ding en wordt steeds specifieker. Bijvoorbeeld: Ding > CreativeWork > Artikel > Nieuwsartikel.
Deze hiërarchische structuur betekent dat schema's eigenschappen erven van hun bovenliggende types. Een Nieuwsartikel bevat automatisch alle eigenschappen die beschikbaar zijn voor Artikel, CreativeWork en Ding, plus zijn eigen specifieke eigenschappen. Dit overervingsmodel houdt het vocabulaire overzichtelijk terwijl het gedetailleerde specificiteit toestaat wanneer dat nodig is.
Waarom gestructureerde gegevens belangrijk zijn voor SEO
Zoekmachines hebben geen gestructureerde gegevens nodig om pagina's te indexeren of te rangschikken. Sites zonder opmaak kunnen nog steeds goed presteren in de zoekresultaten. Dus waarom zou je je druk maken?
Het antwoord ligt in zichtbaarheid, context en concurrentievoordeel.
Verbeterde zichtbaarheid door rijke resultaten
Rijke resultaten zijn de belangrijkste reden waarom de meeste websites gestructureerde gegevens implementeren. Deze uitgebreide zoekresultaten geven extra informatie weer naast de standaard blauwe link en meta description.
Ze kunnen het laten zien:
- Aantal sterren en beoordelingen
- Productprijzen en beschikbaarheid
- Bereidingstijden van recepten en aantal calorieën
- Evenementdata en -locaties
- FAQ accordeon inhoud
- Videominiaturen en duur
- Navigatiepaden met kruimel
Deze uitgebreide lijsten nemen meer visuele ruimte in op de resultatenpagina en trekken meer aandacht dan de standaardresultaten. Studies hebben aangetoond dat rich snippets de CTR met 5%-30% kunnen verbeteren, volgens onderzoek van Moz. Dat is geen kleine optimalisatie, maar een aanzienlijk concurrentievoordeel.
Maar dit is belangrijk: niet alle gestructureerde gegevens komen automatisch in aanmerking voor rijke resultaten. Google geeft selectief uitgebreide functies weer op basis van de kwaliteit van de inhoud, de nauwkeurigheid van de opmaak en de relevantie voor de zoekopdracht. De opmaak zorgt ervoor dat u in aanmerking komt, niet dat u er recht op heeft.
Verbeterd semantisch begrip
Naast rijke resultaten helpen gestructureerde gegevens zoekmachines om inhoudrelaties en context te begrijpen. Dit semantisch begrip beïnvloedt hoe zoekmachines inhoud categoriseren, relevantie voor zoekopdrachten bepalen en gerelateerde informatie op verschillende pagina's met elkaar verbinden.
Als een receptenpagina gestructureerde gegevens bevat die de auteur identificeren, kunnen zoekmachines dat recept koppelen aan andere inhoud van dezelfde auteur. Wanneer productpagina's merkinformatie markeren, kunnen zoekmachines alle producten van dat merk samenvoegen. Dit onderling verbonden begrip creëert wat soms de “kennisgrafiek” wordt genoemd - het web van relaties tussen entiteiten dat de moderne zoekmachine aandrijft.
Prestatie-impact in de praktijk
De gegevens die de implementatie van gestructureerde gegevens ondersteunen gaan verder dan de theoretische voordelen. Volgens onderzoek van de Moz-branche zag een gevestigd nationaal retailmerk de implementatie van schema's bijdragen aan een toename van 50% in organische conversies binnen slechts één maand. Schemaverbeteringen zorgden voor een toename van 230% in organische conversiewaarde binnen zes maanden voor dezelfde klant.
Dit zijn geen geïsoleerde gevallen. Het consistente patroon bij alle implementaties laat zien dat gestructureerde gegevens meetbare resultaten opleveren als ze correct worden geïmplementeerd.
Algemene gestructureerde gegevensindelingen
Schema.org definieert wat je moet markeren (het vocabulaire), maar het specificeert niet hoe je die markering in je HTML moet coderen. Drie formaten zijn naar voren gekomen als de primaire opties:
JSON-LD (aanbevolen)
JSON-LD staat voor JavaScript Object Notation for Linked Data. Het is de door Google aanbevolen indeling en de meest gebruikte aanpak voor nieuwe implementaties.
JSON-LD leeft in een script tag, meestal geplaatst in de head of body sectie van de pagina. De opmaak staat los van de zichtbare pagina-inhoud, waardoor het eenvoudig is om iets toe te voegen, te bewerken of te verwijderen zonder de HTML aan te raken die gebruikers zien.
Hier zie je hoe een basis JSON-LD implementatie eruit ziet voor een artikel:
| <script type=”application/ld+json”> { “@context”: “https://schema.org”, “@type”: “Artikel”, “headline”: “Wat is Structured Data SEO?”, “auteur”: { “@type”: “Persoon”, “naam”: “Jane Smith”.” }, “datePublished”: “2026-02-25”, “image”: “https://example.com/image.jpg” } </script> |
De indeling is schoon, leesbaar en verstoort de paginaweergave of gebruikerservaring niet. Omdat het gescheiden is van zichtbare inhoud, kunnen ontwikkelaars gestructureerde gegevens onafhankelijk van ontwerpwijzigingen beheren.
Microgegevens
Microdata voegt schemaopmaak rechtstreeks in HTML-tags in als extra attributen. Het is verweven met de zichtbare inhoud en gebruikt attributen zoals itemscope, itemtype en itemprop om schema-eigenschappen te definiëren.
Hoewel microdata nog steeds wordt ondersteund, is het uit de gratie geraakt omdat het moeilijker te onderhouden is. Veranderingen aan de lay-out van een pagina vereisen het bijwerken van de opmaak en het is moeilijker te valideren zonder gespecialiseerde tools.
RDFa
RDFa (Resource Description Framework in Attributes) is een andere ingebedde indeling die semantische annotaties toevoegt via HTML-attributen. Het is flexibeler dan microdata, maar ook complexer om correct te implementeren.
RDFa wordt beperkt gebruikt in algemene SEO contexten, maar blijft relevant in specifieke industrieën en contexten waar meer verfijnde semantische relaties moeten worden uitgedrukt.
| Formaat | Plaatsing | Gebruiksgemak | Google's aanbeveling | Beste voor |
|---|---|---|---|---|
| JSON-LD | Apart scriptblok | Eenvoudig te implementeren en onderhouden | Aanbevolen | De meeste websites en nieuwe implementaties |
| Microgegevens | Ingebed in HTML | Matige complexiteit | Ondersteund | Bestaande systemen met bestaande microgegevens |
| RDFa | Ingebed in HTML | Complex | Ondersteund | Gespecialiseerde semantische toepassingen |
Typen gestructureerde data die het meest waardevol zijn voor SEO
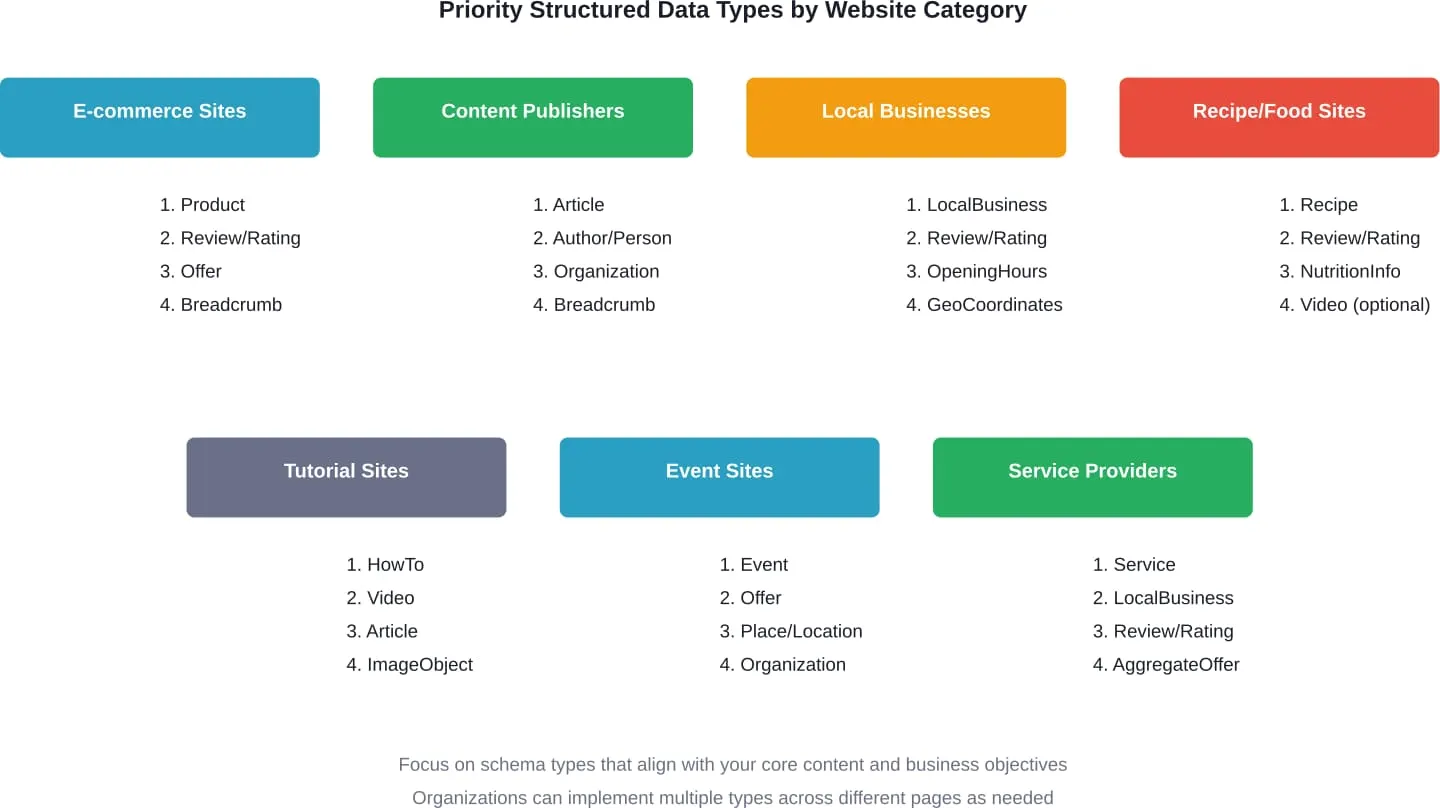
Schema.org bevat honderden typen, maar de meeste websites hebben er baat bij om zich te richten op een kernset van schema's die aansluiten bij hun inhoud en bedrijfsmodel.
Artikel schema
Artikel schema is van toepassing op blogberichten, nieuwsartikelen, opiniestukken en soortgelijke inhoud. Het helpt zoekmachines bij het identificeren van auteurschap, publicatiedata, uitgelichte afbeeldingen en artikelonderdelen.
Nieuwssites, blogs en uitgevers van content zouden prioriteit moeten geven aan Artikel schema (of de meer specifieke varianten zoals Nieuwsartikel, BlogPosting of Wetenschappelijk Artikel). Deze markering ondersteunt functies zoals de Top Stories carrousel en artikelsnippets in zoekresultaten.
Productschema
E-commercesites vertrouwen sterk op het schema Product om items te markeren die te koop worden aangeboden. Dit schema bevat eigenschappen voor naam, afbeelding, beschrijving, SKU, merk, prijs, beschikbaarheid en klantbeoordelingen.
Productmarkup maakt winkelgerelateerde rijke resultaten mogelijk die prijzen, beschikbaarheid en beoordelingen direct in de zoekopdracht weergeven. Voor online verkopers is deze opmaak niet optioneel, maar essentieel om te kunnen concurreren bij het zoeken naar producten.
Schema voor lokale bedrijven
Bakstenen bedrijven en dienstverleners profiteren van het LocalBusiness-schema (en de vele specifieke subtypes zoals Restaurant, Store of ProfessionalService). Deze markup bevat openingstijden, locatie, contactinformatie en servicegebieden.
Lokaal bedrijfsschema ondersteunt het kennispaneel dat wordt weergegeven bij zoekopdrachten naar bedrijven en helpt bij lokale rankings in Google Maps-resultaten.
FAQ-schema
FAQ schema markup creëert uitbreidbare vraag-en-antwoord secties direct in de zoekresultaten. Als iemand zoekt naar een vraag die uw FAQ beantwoordt, kan Google dat specifieke vraag-en-antwoordpaar direct op de resultatenpagina weergeven.
Google heeft de rijke resultaten van FAQ's de afgelopen jaren echter beperkt tot gezaghebbende overheids- en gezondheidswebsites. Hoewel andere sites nog steeds FAQ-schema kunnen implementeren voor semantisch begrip, hoeven ze geen rijke resultaten te verwachten.
HowTo Schema
Les- en instructie-inhoud heeft baat bij het schema HowTo, dat stapsgewijze processen structureert met afzonderlijke stappen, afbeeldingen en geschatte voltooitijden.
Uitgebreide HowTo-resultaten kunnen bij zoekopdrachten worden weergegeven met afbeeldingen voor elke stap, waardoor tutorial-inhoud zeer zichtbaar en aantrekkelijk wordt voor gebruikers die op zoek zijn naar instructies.
Videoschema
Pagina's met video-inhoud moeten VideoObject schema implementeren om zoekmachines te voorzien van informatie over de titel, beschrijving, thumbnail, uploaddatum en duur van de video.
Videoschema ondersteunt videocarrousels in zoekresultaten en kan videopreviews direct op de zoekpagina weergeven, waardoor de zichtbaarheid van videocontent toeneemt.
Broodkruimelschema
Kruimelopmaak zorgt niet voor dramatische visuele verbeteringen, maar het helpt zoekmachines de hiërarchie van de site te begrijpen en kan de URL-weergave in zoekresultaten vervangen door een gebruiksvriendelijker kruimelpad.
Gestructureerde gegevens implementeren op uw website
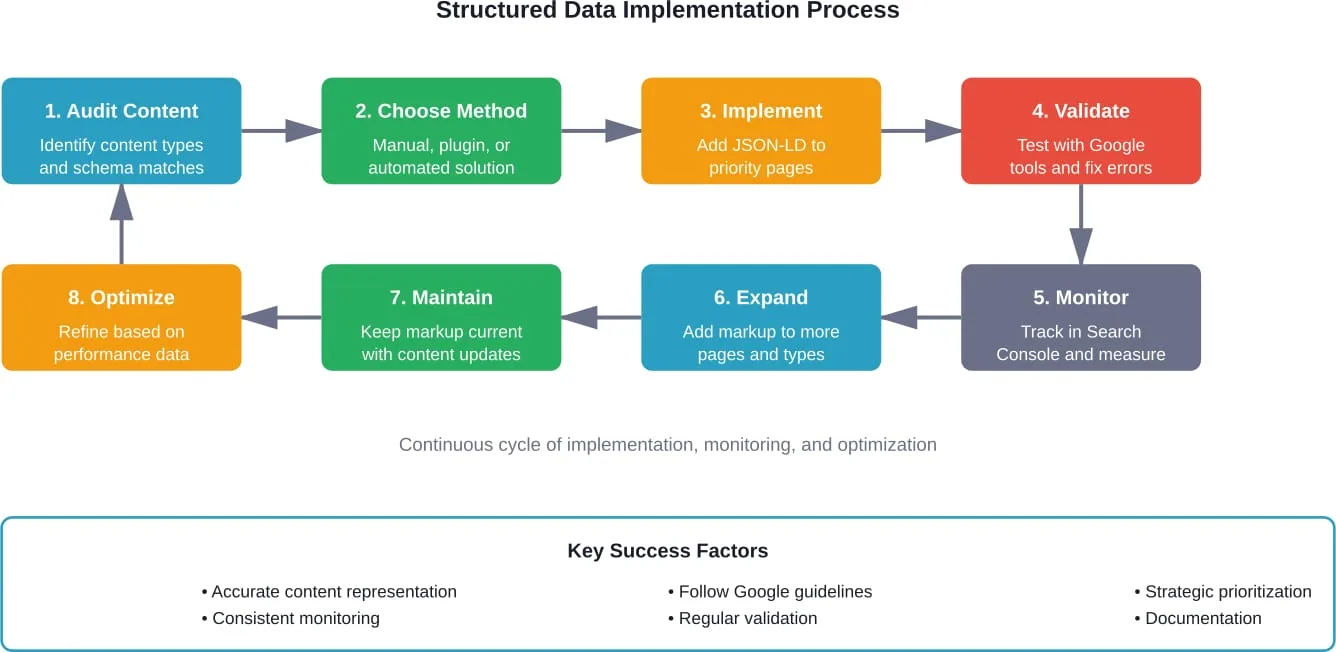
Implementatiebenaderingen variëren van handmatige codering tot geautomatiseerde plugin-oplossingen, afhankelijk van de technische mogelijkheden en platformbeperkingen.
Handmatige implementatie
Voor ontwikkelaars die vertrouwd zijn met HTML en JSON, biedt handmatige implementatie volledige controle.
Deze aanpak houdt in:
- Identificeren welke schematypen overeenkomen met je inhoud
- Raadpleeg de Schema.org documentatie voor vereiste en aanbevolen eigenschappen
- JSON-LD-code schrijven die je inhoud nauwkeurig beschrijft
- Het scriptblok toevoegen aan je paginasjabloon of individuele pagina's
- De implementatie testen met validatietools
Handmatige implementatie werkt goed voor op maat gemaakte websites en situaties waarin precieze controle over opmaakdetails nodig is.
WordPress Plugins
WordPress gebruikers kunnen gebruik maken van plugins die een groot deel van het proces van gestructureerde gegevens automatiseren. Populaire opties zijn Yoast SEO, Rank Math, Schema Pro en All in One Schema Rich Snippets.
Deze plugins bieden meestal instellingsinterfaces waar gebruikers schema types kunnen configureren zonder code te schrijven. De plugins genereren dan automatisch de juiste JSON-LD en voegen die in op basis van het inhoudstype, de aangepaste velden en de plugin-instellingen.
Plugin-gebaseerde implementaties ruilen wat flexibiliteit voor gebruiksgemak. Ze werken goed voor sites waar standaard schema types de meeste behoeften dekken en de technische middelen beperkt zijn.
Google Tagmanager
Sommige organisaties implementeren gestructureerde gegevens via Google Tag Manager, waarmee markup kan worden toegevoegd en gewijzigd zonder de websitecode te wijzigen. Deze aanpak is geschikt voor situaties waarin directe toegang tot code beperkt is of waarin marketingteams markup onafhankelijk moeten beheren.
Implementaties van Tag Manager vereisen het instellen van aangepaste HTML-tags die de JSON-LD-code bevatten en vervolgens het configureren van triggers om deze tags op de juiste pagina's af te vuren.
Platformspecifieke oplossingen
E-commerce platforms zoals Shopify, WooCommerce en BigCommerce hebben vaak ingebouwde gestructureerde gegevens of bieden gespecialiseerde apps voor schema-implementatie. Deze oplossingen begrijpen de datastructuur van het platform en kunnen automatisch Product-, Review- en Offer-markup genereren op basis van productinformatie die al in het systeem aanwezig is.
Gestructureerde gegevens testen en valideren
Het implementeren van opmaak is slechts de helft van het proces. Validatie zorgt ervoor dat de code foutloos is en in aanmerking komt voor rijke resultaten.
Google rijke resultaten test
De Rich Results Test van Google controleert of de gestructureerde gegevens van een pagina in aanmerking komen voor specifieke rich result-functies. Fouten, waarschuwingen en geldige items worden geïdentificeerd terwijl een voorbeeld wordt getoond van hoe de pagina in de zoekresultaten zou kunnen verschijnen.
Deze tool richt zich specifiek op markup-typen die rijke resultaten kunnen genereren, dus het zal niet alle schema-typen valideren, maar alleen de schema-typen die Google actief gebruikt voor zoekfuncties.
Schema Markup Validator
Schema.org biedt zijn eigen validator die opmaak controleert aan de hand van de volledige vocabulairespecificatie. Dit hulpmiddel is uitgebreider dan de Rich Results Test van Google omdat het alle schema-typen valideert, niet alleen die welke in aanmerking komen voor rich features.
Gebruik deze validator om technische correctheid te controleren, zelfs als rijke resultaten niet het primaire doel zijn.
Google Search Console
Na het implementeren van gestructureerde gegevens laten de verbeteringsrapporten van Google Search Console zien welke pagina's specifieke markup-typen bevatten, welke fouten Google is tegengekomen en prestatiegegevens voor pagina's met rijke resultaten.
Deze rapporten zorgen voor voortdurende controle en waarschuwen site-eigenaren wanneer Google nieuwe fouten of problemen met bestaande markup ontdekt.
Veelvoorkomende fouten in gestructureerde gegevens om te vermijden
De implementatie van gestructureerde gegevens lijkt eenvoudig, maar verschillende veelvoorkomende fouten kunnen ervoor zorgen dat markup niet correct werkt of zelfs leiden tot handmatige acties van Google.
Inhoud markeren die niet zichtbaar is voor gebruikers
De richtlijnen voor gestructureerde gegevens van Google verbieden het markeren van inhoud die gebruikers niet op de pagina kunnen zien. De markup moet zichtbare inhoud beschrijven, geen extra informatie injecteren die alleen voor zoekmachines bestaat.
Het markeren van een 5-sterrenbeoordeling wanneer er geen beoordeling op de pagina wordt weergegeven, is bijvoorbeeld in strijd met de richtlijnen. De gestructureerde gegevens moeten nauwkeurig weergeven wat gebruikers ervaren.
Misbruik van beoordelingsmarkering
Opmaak voor beoordelingen en waarderingen wordt vaak verkeerd toegepast.
Veel voorkomende overtredingen zijn:
- Promo-inhoud markeren als beoordelingen
- Zelfbeoordelingen maken (bedrijven die zichzelf beoordelen)
- Valse of gestimuleerde beoordelingen gebruiken
- Recensies over meerdere items op één pagina markeren
Google controleert actief of de opmaak van beoordelingen wordt gemanipuleerd en kan bij overtredingen handmatige acties uitvoeren.
Dubbele of conflicterende opmaak
Meerdere bronnen kunnen soms gestructureerde gegevens toevoegen aan dezelfde pagina: een thema kan basisopmaak bevatten, een plugin voegt meer toe en aangepaste code voegt extra schema's toe. Dit kan dubbele of tegenstrijdige informatie opleveren.
Controleer je pagina's om ervoor te zorgen dat markup niet overvloedig dezelfde inhoud beschrijft of tegenstrijdige waarden geeft voor dezelfde eigenschappen.
Ontbrekende vereiste eigenschappen
Elk schema-type heeft vereiste eigenschappen die aanwezig moeten zijn voor een geldige opmaak. Productschema vereist bijvoorbeeld naam, afbeelding en ofwel aanbiedingen of beoordeling.
Controleer de Schema.org documentatie of gebruik validatietools om te controleren of alle vereiste eigenschappen aanwezig zijn.
Onjuiste gegevenstypen
Eigenschappen verwachten specifieke gegevenstypen - datums moeten correct worden opgemaakt, prijzen hebben valutacodes nodig en URL's moeten volledig zijn. Onjuiste opmaak kan markup ongeldig maken, zelfs als de onderliggende informatie correct is.
Gestructureerde gegevens naast rijke resultaten
Hoewel rijke resultaten de meeste aandacht genereren, dienen gestructureerde gegevens bredere doelen in moderne SEO en webtechnologie.
Spraakgestuurd zoeken en digitale assistenten
Spraakassistenten zoals Google Assistant, Alexa en Siri vertrouwen op gestructureerde gegevens om gesproken vragen te beantwoorden. Als iemand vraagt naar openingstijden, tijden van evenementen of ingrediënten voor recepten, halen assistenten informatie van pagina's met de juiste markup.
Omdat voice search blijft groeien, worden gestructureerde gegevens steeds belangrijker om te verschijnen in de resultaten van zoekopdrachten.
Integratie van kennisgrafieken
Google's Knowledge Graph verzamelt informatie over entiteiten (mensen, plaatsen, dingen en concepten) van over het hele web. Gestructureerde gegevens helpen Google om relaties tussen entiteiten te begrijpen en kunnen bijdragen aan Knowledge Graph-panelen.
Consistente gestructureerde gegevens over organisaties, mensen en hun relaties helpen bij het opbouwen van completere entiteitprofielen in de Knowledge Graph.
Toekomstbestendigheid voor AI-zoeken
Naarmate zoekmachines meer AI en machine learning integreren, wordt het begrijpen van semantische relaties nog belangrijker. Gestructureerde gegevens bieden expliciete semantische informatie die AI-systemen kunnen gebruiken om de context en relaties van inhoud beter te begrijpen.
Met de opkomst van generatieve AI-zoekervaringen kunnen gestructureerde gegevens invloed hebben op de manier waarop inhoud wordt geselecteerd en gepresenteerd in AI-gegenereerde antwoorden.
Strategie en best practices voor gestructureerde gegevens
Een effectieve implementatie van gestructureerde data vereist strategisch denken dat verder gaat dan alleen het toevoegen van markup aan pagina's.
Begin met je belangrijkste pagina's
Probeer niet elke pagina tegelijk te markeren. Stel prioriteiten:
- Pagina's die het meeste verkeer of conversies genereren
- Inhoudstypen met duidelijke schema-overeenkomsten (producten, artikelen, evenementen)
- Pagina's waar rijke resultaten een concurrentievoordeel zouden opleveren
Bouw de dekking van gestructureerde gegevens geleidelijk op en valideer en controleer de resultaten terwijl u de implementatie uitbreidt.
Nauwkeurigheid en consistentie behouden
Gestructureerde gegevens moeten altijd een accurate weergave zijn van de pagina-inhoud. Wanneer inhoud verandert, moet de opmaak dienovereenkomstig worden bijgewerkt. Verouderde prijzen, vervallen producten of gebeurtenissen uit het verleden met onnauwkeurige data zorgen voor een slechte gebruikerservaring en kunnen in strijd zijn met de richtlijnen van Google.
Zorg voor processen om markup gesynchroniseerd te houden met contentwijzigingen, met name voor dynamische content zoals prijzen en beschikbaarheid.
Documenteer uw implementatie
Maak documentatie die in kaart brengt welke schema types waar worden gebruikt, hoe ze worden geïmplementeerd (plugin, handmatige code, Tag Manager) en welke eigenschappen zijn opgenomen. Deze documentatie helpt bij het oplossen van problemen, het trainen van teamleden of het controleren van de volledigheid van opmaak.
Prestaties bewaken
Meetgegevens bijhouden die de impact van gestructureerde gegevens aangeven:
- Indrukken en klikken op rijke resultaten in Search Console
- Doorklikratio's voor pagina's met rijke resultaten vs. standaard vermeldingen
- Algemene trends in organisch verkeer na implementatie
- Conversiepercentages voor verkeer uit rijke resultaten
Deze statistieken helpen bij het kwantificeren van de ROI van de inspanningen op het gebied van gestructureerde data en geven richting aan toekomstige optimalisatieprioriteiten.
Blijf op de hoogte van de richtlijnen van Google
Google werkt de richtlijnen voor gestructureerde gegevens regelmatig bij, voegt ondersteuning voor nieuwe schema-typen toe en past de weergave van bestaande opmaak in zoekresultaten aan. Abonneer u op de blogupdates van Google Search Central en bekijk regelmatig de officiële documentatie om op de hoogte te blijven van wijzigingen.
Prestaties schalen met Lengreo
Hoewel het begrijpen van de mechanica van Schema.org van vitaal belang is voor elke moderne digitale strategie, kan de technische uitvoering en het doorlopende onderhoud van deze schema's een aanzienlijke onderneming zijn voor groeiende bedrijven. Ons team bij Lengreo is gespecialiseerd in het overbruggen van de kloof tussen technische SEO-eisen en bedrijfsgroei op hoog niveau. We integreren gestructureerde data-audits en optimalisaties direct in onze uitgebreide SEO- en contentstrategieën om ervoor te zorgen dat onze klanten niet alleen zichtbaar zijn, maar hun respectieve zoeklandschappen domineren met rijke resultaten met een hoge impact.
De gegevens bevestigen dat semantische helderheid leidt tot een hogere betrokkenheid en we hebben gezien dat dit zich vertaalt in opmerkelijke resultaten in de praktijk. Door technische precisie af te stemmen op een marktgerichte strategie, hebben we met succes de conversieratio's met meer dan 53% verhoogd voor onze partners in de IT-sector en de kosten per lead aanzienlijk verlaagd voor internationale techbedrijven. Of je nu JSON-LD wilt implementeren voor een complexe e-commerce catalogus of je lokale aanwezigheid wilt optimaliseren, wij bieden de expertise die nodig is om gestructureerde data om te zetten in een duurzaam concurrentievoordeel.
De toekomst van gestructureerde data in SEO
Het belang van gestructureerde gegevens blijft groeien naarmate zoekervaringen verder evolueren dan de traditionele blauwe links. Verschillende trends wijzen op een toenemende relevantie:
AI en Generatief zoeken
Nu AI-gestuurde zoekervaringen zoals Google's Search Generative Experience en andere AI-chatbots steeds vaker voorkomen, kunnen gestructureerde gegevens van invloed zijn op hoe content wordt geselecteerd en geciteerd in AI-gegenereerde antwoorden. Deze systemen hebben betrouwbare, gestructureerde informatiebronnen nodig en pagina's met duidelijke schema markup bieden precies dat.
Multimodaal zoeken
Zoeken omvat steeds meer gesproken, visuele en traditionele tekstvragen. Gestructureerde gegevens helpen zoekmachines om inhoud in deze verschillende modaliteiten te begrijpen, zodat pagina's kunnen worden weergegeven voor gesproken vragen, zoekopdrachten op afbeeldingen en visuele zoekhulpmiddelen.
Op entiteit gebaseerd zoeken
Google's verschuiving naar begrip op basis van entiteiten in plaats van trefwoorden maakt gestructureerde gegevens waardevoller. Markup definieert expliciet entiteiten en hun relaties, wat overeenkomt met hoe moderne zoekmachines informatie opvatten.
De organisaties en websites die vandaag uitgebreide, accurate gestructureerde gegevens implementeren, positioneren zichzelf in een voordelige positie voor alle zoekinnovaties van morgen.
Aan de slag met SEO op basis van gestructureerde data
De implementatie van gestructureerde gegevens lijkt misschien technisch, maar de basisprincipes zijn toegankelijk voor iedereen die bereid is de basisbeginselen te leren.
Begin met het identificeren van één type inhoud met hoge waarde op uw site: uw populairste productcategorie, uw blogartikelen of uw servicepagina's. Onderzoek welk schema overeenkomt met dat type inhoud. Onderzoek welk schema-type overeenkomt met die inhoud en implementeer markup in eerste instantie op slechts een paar pagina's. Valideer de implementatie, monitor de resultaten een paar weken en breid de dekking geleidelijk uit op basis van wat werkt.
Het landschap van gestructureerde gegevens blijft evolueren, maar het kernprincipe blijft constant: zoekmachines voorzien van expliciete, nauwkeurige informatie over uw inhoud creëert mogelijkheden voor verbeterde zichtbaarheid en betere gebruikerservaringen.
Naarmate zoeken geavanceerder en AI-gedrevener wordt, zullen de websites die de semantische taal van zoekmachines spreken door middel van gestructureerde gegevens concurrentievoordelen behouden ten opzichte van websites die alleen vertrouwen op traditionele optimalisatietechnieken.
Neem de tijd om de basisprincipes van gestructureerde data te begrijpen, implementeer markup strategisch op uw belangrijkste pagina's en monitor de resultaten. De initiële investering in leren en implementeren betaalt zich terug in de vorm van verbeterde zichtbaarheid bij zoekopdrachten, hogere doorklikpercentages en een betere positionering voor de toekomst van zoekopdrachten.









